ColorNet: Investigating the importance of color spaces for image classification
Shreyank N Gowda, Chun Yuan · ACCV 2018 · arXiv 2019년 공개
핵심 요약
이 논문이 발표된 2018년 무렵에는 CNN을 더 깊게 만들거나 층 사이 연결을 개선해 이미지 분류 성능을 높이는 연구가 활발했다. 반면 입력 이미지는 RGB로 사용하는 경우가 많았다. ColorNet은 같은 이미지를 여러 색공간으로 표현하고 각각의 분류 결과를 결합하면, 하나의 큰 네트워크에만 의존하지 않고도 좋은 성능을 얻을 수 있는가를 검토한 연구다.
- 같은 이미지라도 색공간을 바꾸면 모델이 잘 맞히는 클래스와 틀리는 양상이 달라질 수 있다는 관찰에서 출발한다.
- RGB를 포함한 7개 색공간을 각각 작은 DenseNet에 입력하고, 마지막에 분류 점수를 결합한다.
- 작은 ColorNet-40-12는 논문이 보고한 1.75M 파라미터로 일부 큰 DenseNet과 가까운 오류율을 보였다. 더 넓은 모델에서는 오류율을 더 낮췄다.
- 핵심은 새로운 이미지 정보를 추가하는 것이 아니라, 서로 다른 입력 표현으로 학습한 모델들의 결과를 함께 활용하는 것이다. 파라미터 수가 적어도 색 변환과 여러 분기의 실행 비용은 남는다.
1. Introduction: 입력을 RGB로만 볼 필요가 있을까?
이미지 분류에서는 주로 네트워크를 어떻게 설계할지에 집중한다. 하지만 같은 사진도 RGB, HSV, Lab처럼 어떤 좌표계로 표현하느냐에 따라 각 채널에 담기는 의미와 값의 분포가 달라진다. 모델의 구조가 같아도 학습하기 쉬운 특징이 달라질 여지가 있다.
ColorNet은 여기서 한 단계 더 나아간다. 가장 좋은 색공간 하나를 고르기보다, 서로 다른 색 표현에서 얻은 예측을 결합하면 오류를 보완할 수 있는지를 살펴본다. 먼저 단순 CNN으로 색공간별 차이를 관찰하고, 이를 바탕으로 여러 작은 DenseNet을 결합하는 구조를 제안한다.
2. 색공간을 바꾸면 무엇이 달라지나?
2.1. 같은 색을 다른 축으로 표현한다
색공간 변환은 같은 픽셀 값을 다른 성분으로 표현하는 과정이다. ColorNet의 최종 모델은 다음 7개 입력을 사용한다.
| 색공간 | 표현하는 성분 | 이 글에서 구분할 점 |
|---|---|---|
| RGB | 빨강·초록·파랑 채널 | 기본 입력 표현 |
| HSV | 색상·채도·밝기 | 색의 종류와 강도, 밝기를 다른 축으로 표현 |
| Lab | 명도와 두 색상 축 | 밝기와 색 성분을 구분하는 지각 기반 표현 |
| YUV·YCbCr·YIQ | 밝기 성분과 두 색 성분 | 비슷한 계열이지만 변환 계수와 표현 방식이 다른 세 색공간 |
| HED | Hematoxylin·Eosin·DAB 성분 | 원래 염색 영상의 색 분리에 쓰이는 변환을 입력 표현으로 활용 |
HED의 일반적인 용도는 scikit-image의 색 분리 설명을 참고했다. ColorNet은 이를 일반 이미지 분류의 입력 변환 중 하나로 시험한다.
여기서 표현이 달라진다고 원본에 없던 관측 정보가 생기는 것은 아니다. 같은 정보를 다른 수치 관계로 제시했을 때, 유한한 모델과 학습 과정이 그 정보를 활용하는 방식이 달라질 수 있다는 관점이다.
2.2. 전체 정확도보다 클래스별 차이에 주목한다
논문은 먼저 같은 형태의 단순 CNN에 서로 다른 색공간의 CIFAR-10 이미지를 입력했다. Table 1에서 RGB의 정확도는 78.89%, Lab은 80.43%, HSV는 78.57%로 보고됐다. Lab이 RGB보다 1.54%p 높지만, 이 결과만으로 모든 데이터에 Lab이 최선이라고 결론내릴 수는 없다.
저자들은 혼동행렬을 보고, 색공간에 따라 어떤 클래스를 얼마나 잘 구분하는지가 달라진다는 점에 주목한다.
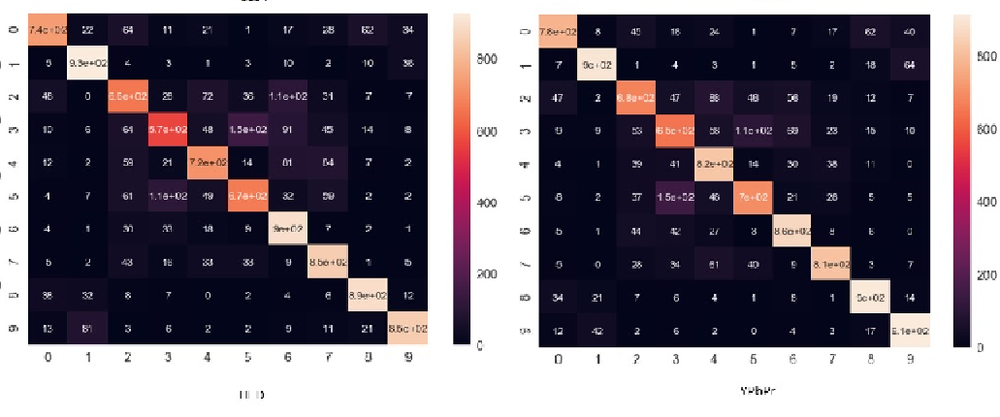
Figure 1에서 HED(왼쪽)와 YPbPr(오른쪽) 패널을 발췌해 나란히 배치했다. 출처: Gowda and Yuan. 대각선은 정답 클래스로 분류한 수를, 다른 칸은 오분류를 보여준다.
예를 들어 본문은 CIFAR-10의 class 4를 YPbPr에서는 82%, HED에서는 72%로 분류했다고 설명한다. 이런 차이가 여러 클래스에서 관찰된다면, 서로 다른 모델의 판단을 합쳐 보완할 가능성이 생긴다.
이 관찰은 색공간들이 통계적으로 독립이라는 증명은 아니다. 색공간별로 학습한 분류기의 오류 양상이 완전히 같지 않다는 것이 모델 결합으로 이어지는 근거다.
3. Proposed Approach: 색공간별 DenseNet과 Late Fusion
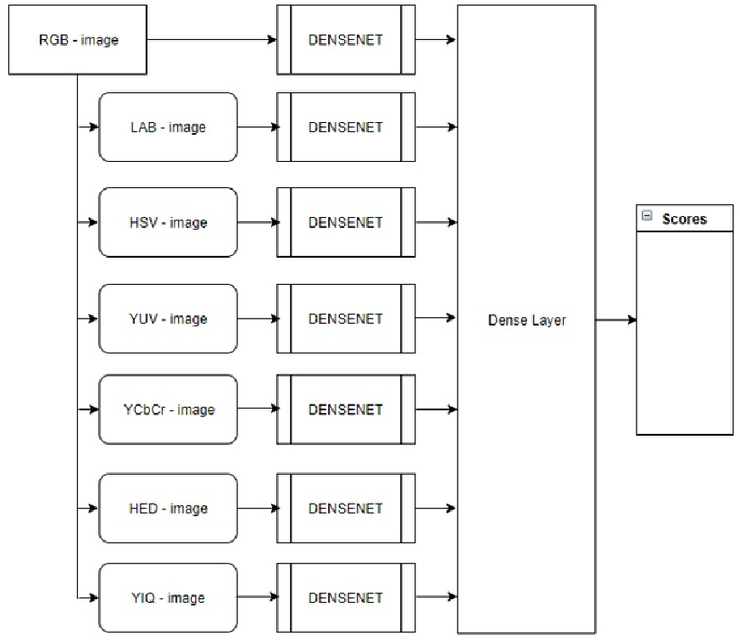
Figure 2. 입력 RGB와 Lab·HSV·YUV·YCbCr·HED·YIQ의 총 7개 분기가 마지막 분류층에서 만난다. 출처: Gowda and Yuan, p.9.
3.1. 입력은 일곱 가지, 각 분기는 작게
하나의 RGB 이미지를 나머지 여섯 색공간으로 변환해 총 7개의 입력 표현을 만든다. 각 표현에는 별도의 DenseNet이 연결된다. 같은 모델에 색공간을 번갈아 넣는 방식도, 7개 색공간의 채널을 처음부터 한 덩어리로 붙이는 방식도 아니다.
DenseNet은 이전 층의 특징을 뒤쪽 층에서 연결해 재사용하는 구조다. ColorNet은 하나의 큰 DenseNet 대신 작은 분기를 여러 개 두어, 표현의 다양성을 활용하면서 파라미터 수를 조절한다.
ColorNet-L-k의 L과 k는 각 DenseNet 분기의 깊이와 growth rate를 뜻한다. Growth rate는 dense block의 층이 새로 만들어 추가하는 특징 채널 수다. 논문은 깊이 40의 분기에서 k를 12 또는 48로 바꾸며, 깊이뿐 아니라 너비를 늘리는 선택도 비교한다.
3.2. 마지막에 예측을 결합한다
각 분기는 자기 색공간에서 클래스별 점수를 만들고, 마지막 Dense Layer가 이 점수들을 조합한다. 구조를 설명하기 위한 간단한 표기로 쓰면 다음과 같다.
s_i=f_i(T_i(x)),\qquad s_{\mathrm{final}}=g(s_1,\ldots,s_7)- Tᵢ: i번째 색공간 변환.
- fᵢ: 해당 입력을 처리하는 DenseNet.
- sᵢ: 분기별 분류 점수.
- g: 점수들을 결합하는 학습 가능한 최종 Dense Layer.
위 식은 원문의 구조 설명을 정리한 표현이며, 논문에 별도로 제시된 수식은 아니다.
이처럼 각 표현을 별도로 처리한 뒤 뒤쪽에서 합치는 것을 late fusion이라고 한다. 최종층은 어느 분기의 점수를 어떻게 조합할지 학습한다. 분기별 특징을 충분히 만든 뒤 결합할 수 있지만, 여러 네트워크를 계산해야 하는 비용도 생긴다.
반대로 early fusion은 입력이나 초기 특징 단계에서 표현을 합치는 접근이다. 네트워크를 공유해 규모를 줄일 여지가 있지만, 서로 다른 표현의 특징을 초반부터 함께 처리해야 한다. 이 논문은 단순 CNN 탐색 실험에서 late fusion 쪽의 정확도가 더 높아 이를 선택했다.
3.3. 색공간은 많이 넣을수록 좋을까?
단순 CNN을 이용한 Table 2의 일부 결과를 보면 그렇지 않다.
| 입력 조합·방식 | 색공간 수 | 정확도(%) ↑ |
|---|---|---|
| RGB + HSV | 2 | 81.42 |
| RGB + HSV + YUV + Lab | 4 | 82.96 |
| 위 4개 + HED | 5 | 83.61 |
| 위 5개 + XYZ | 6 | 82.81 |
| 위 5개를 early fusion으로 결합 | 5 | 81.63 |
원문 Table 2, p.8 발췌. 최종 DenseNet 기반 ColorNet의 결과가 아니라, 색공간 조합을 탐색한 단순 CNN 실험이다.
5개 조합에 XYZ를 추가했을 때는 정확도가 낮아졌다. 같은 5개 조합에서도 결합 방식에 따라 결과가 달랐다. 따라서 중요한 것은 입력 표현의 수 자체보다 서로 보완되는 조합과 결합 방법이다.
최종 모델에서는 RGB·Lab·HSV·YUV·YCbCr·HED·YIQ를 선택했다. 다만 Table 2가 최종 7개 조합의 모든 선택 과정을 보여주는 것은 아니므로, 이 조합이 모든 데이터셋에 최적이라고 해석하지는 않는다.
4. Experiments: 적은 파라미터로 어느 정도까지 가능한가?
4.1. 평가와 학습 조건
실험은 CIFAR-10, CIFAR-100, SVHN, ImageNet에서 수행한다. CIFAR와 SVHN은 32×32 이미지이며, ImageNet은 검증 세트에서 224×224의 single-crop 또는 10-crop 평가를 사용한다.
- CIFAR는 배치 32·300 epochs로 학습하며, 수평 뒤집기와 가로·세로 이동 증강을 사용한 결과를
+로 구분한다. - SVHN은 100 epochs로 학습한다.
- 각 DenseNet에는 SGD·Nesterov momentum 0.9·weight decay 0.0001을 사용한다. 증강이 없을 때는 dropout 0.2를 추가한다.
주의할 점은 앞의 탐색 표가 정확도였던 반면, 아래 Tables 3~6의 값은 오류율이라는 것이다. 아래 표에서는 작을수록 좋다.
4.2. CIFAR와 SVHN 결과
| 모델 | 파라미터(M) | CIFAR-10+ 오류율(%) ↓ | CIFAR-100+ 오류율(%) ↓ | SVHN 오류율(%) ↓ |
|---|---|---|---|---|
| DenseNet-BC-100-12 | 0.8 | 4.51 | 20.20 | 1.76 |
| DenseNet-BC-250-24 | 15.3 | 3.62 | 17.60 | 1.74 |
| DenseNet-BC-190-40 | 25.6 | 3.46 | 17.18 | 미보고 |
| ColorNet-40-12 | 1.75 | 3.49 | 17.42 | 1.59 |
| ColorNet-40-48 | 19.0 | 1.54 | 11.68 | 1.12 |
원문 Tables 3·4·6을 같은 모델 기준으로 묶었다. CIFAR의 +는 증강을 사용한 결과이며, SVHN의 ‘미보고’는 해당 표에 없는 값이다. 수치는 저자 보고값이다.
작은 ColorNet-40-12는 1.75M 파라미터로, 25.6M인 DenseNet-BC-190-40과 가까운 CIFAR 오류율을 보인다. 다만 3.49는 3.46보다, 17.42는 17.18보다 조금 높다. 더 적은 파라미터로 비슷한 수준에 접근했다는 결과이지, 작은 모델이 모든 비교에서 이겼다는 뜻은 아니다.
분기 너비를 키운 ColorNet-40-48은 CIFAR-10+에서 1.54%, CIFAR-100+에서 11.68%의 오류율을 보고한다. 대신 파라미터는 19M으로 커진다. 입력 표현의 결합과 네트워크 용량을 함께 조절하는 절충이 드러난다.
4.3. ImageNet 결과는 별도 모델이다
| 모델 | Top-1 오류율: single / 10-crop ↓ | Top-5 오류율: single / 10-crop ↓ |
|---|---|---|
| DenseNet-121 | 25.02 / 23.61 | 7.71 / 6.66 |
| DenseNet-264 | 22.15 / 20.80 | 6.12 / 5.29 |
| ColorNet-121 | 17.65 / 15.42 | 5.22 / 3.89 |
원문 Table 5, p.12 발췌. 단위는 %이며 각 셀의 앞은 single-crop, 뒤는 10-crop 오류율이다.
ColorNet-121은 각 분기를 DenseNet-121로 바꾼 모델이다. 앞서 소개한 1.75M 모델의 ImageNet 성능으로 읽으면 안 된다. 논문 표에는 ColorNet-121의 전체 파라미터 수가 제시되어 있지 않다.
이 표에서 개선은 크지만, 이는 논문이 보고한 당시 비교 결과다. 현재의 전체 ImageNet 모델 순위나 독립적으로 재현된 성능을 뜻하지 않는다.
5. 이 결과에서 읽을 점과 남는 질문
표현의 다양성과 모델 결합을 함께 봐야 한다
ColorNet은 색공간 변환과 여러 분류기의 결합을 동시에 사용한다. 색공간별 오류 양상이 다르다는 관찰은 설계의 근거지만, 같은 RGB 입력을 사용하는 7개 분류기와의 대조도 있다면 색공간 다양성의 효과와 모델을 여러 개 합친 효과를 더 분명히 나눠 볼 수 있다. 이 대조는 제시된 주요 결과 표에서 확인되지 않는다.
파라미터 수와 실행 속도는 다르다
작은 모델을 쓰더라도 색 변환과 7개 분기의 실행은 필요하다. 저자들도 결론에서 큰 이미지의 변환 비용과 여러 DenseNet을 처리하는 비용을 남은 과제로 언급한다. 최종 시스템의 지연시간을 파라미터 수만으로 판단해서는 안 된다.
색 변환의 구현 조건도 중요하다
색공간마다 값의 범위와 분포가 달라지므로 감마 처리·정규화·변환 구현이 학습 결과에 영향을 줄 수 있다. 원문은 일부 변환식과 scikit-image 사용을 설명하지만, 최종 결합층의 학습 절차나 전체 실행 비용까지 상세히 제공하는 구현 문서는 아니다.
6. Conclusion: 구조뿐 아니라 입력 표현도 설계 대상이다
ColorNet은 같은 이미지를 다른 색공간으로 표현하면 학습한 모델의 판단이 달라질 수 있고, 그 차이를 결합에 활용할 수 있다는 접근이다. 작은 DenseNet을 색공간별로 두고 마지막 분류 점수를 합치는 구조가 이를 구현한다.
이 논문에서 가져갈 핵심은 특정 색공간이 항상 우월하다는 결론보다, 입력 표현과 모델 결합도 이미지 분류 성능을 바꾸는 설계 선택이라는 점이다. 그 이득을 평가할 때는 결합 방식, 모델 크기, 데이터 증강과 실제 실행 비용을 함께 보아야 한다.
답글 남기기