JAMESCUBE.me
-
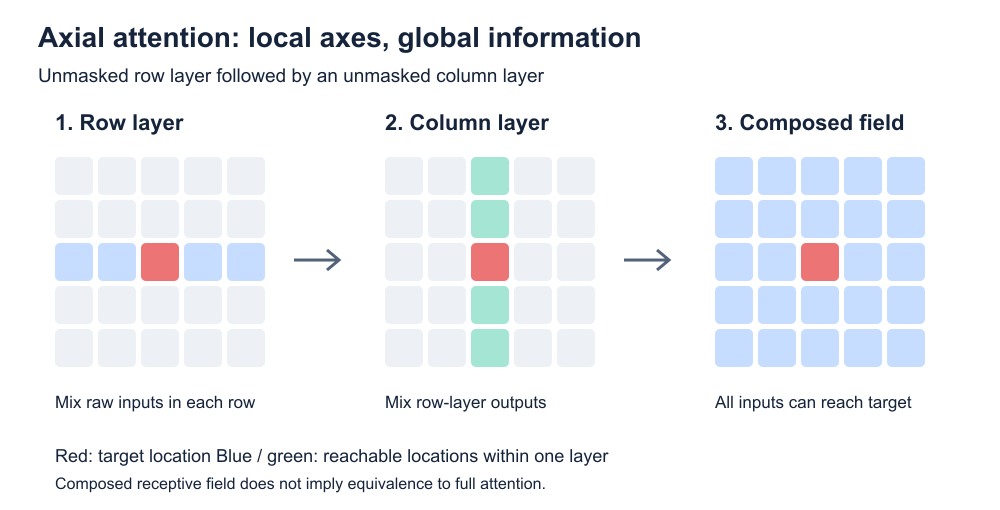
[논문정리] Axial Attention: 축별 attention으로 이미지 전체 문맥을 연결하는 Transformer
논문: Axial Attention In Multidimensional Transformers 저자: Jonathan Ho, Nal Kalchbrenner, Dirk Weissenborn, Tim Salimans 발표: 2019년, arXiv 1912.12180v1 원문: 논문 읽기 1. 핵심 요약: 전체를 보되, 한꺼번에 연결하지 않는다 이미지·영상 생성에서는 멀리 떨어진 픽셀…
-
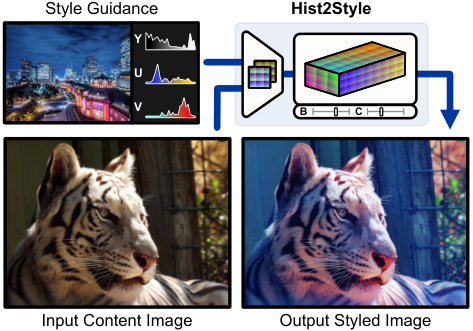
[논문 정리] Hist2Style: 히스토그램으로 제어하는 사진의 색과 톤
논문: Hist2Style: Histogram-Guided Stylization with Bilateral Grids 저자: Dekel Galor, Adam Pikielny, Zhoutong Zhang, Ke Wang, Laura Waller, Jiawen Chen, Ilya Chugunov 발표: CVPR 2026 · Adobe Nextcam, UC Berkeley 관련 자료: 공식 프로젝트와 시연…
-
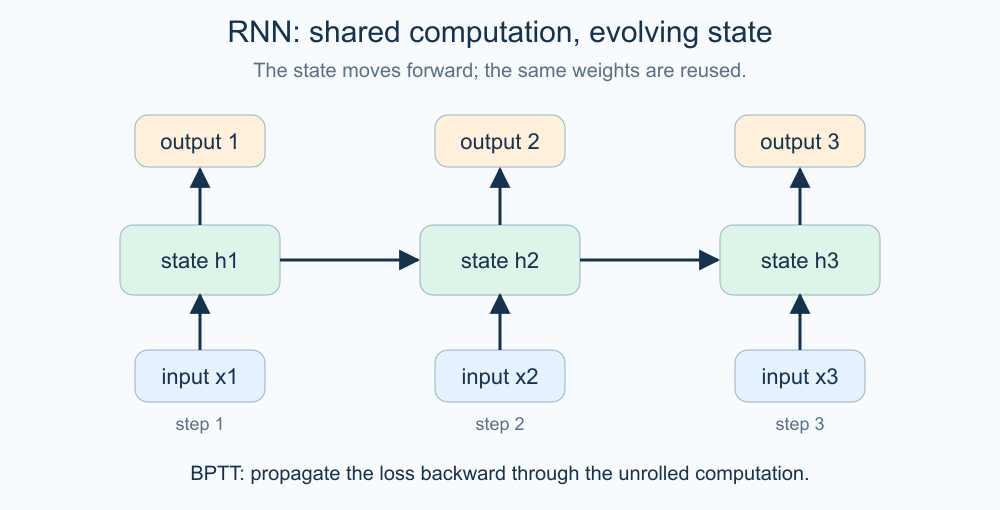
[논문 정리] RNN 서베이: 순환 신경망의 기억과 LSTM·양방향 RNN의 원리
논문: A Critical Review of Recurrent Neural Networks for Sequence Learning 저자: Zachary C. Lipton, John Berkowitz, Charles Elkan 발표: 2015년 arXiv 서베이, v4 기준 1. 왜 순서를 기억하는 신경망이 필요한가 문장 속 단어와 영상…
-
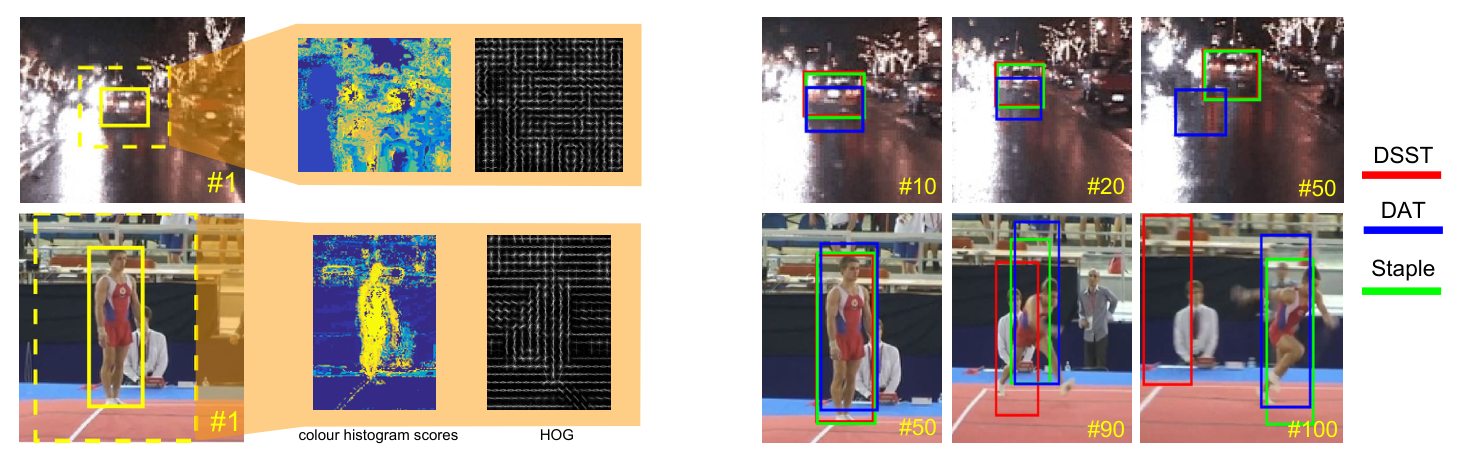
[논문 정리] Staple: Complementary Learners for Real-Time Tracking
논문: Staple: Complementary Learners for Real-Time Tracking 저자: Luca Bertinetto, Jack Valmadre, Stuart Golodetz, Ondrej Miksik, Philip H. S. Torr 발표: CVPR 2016, pp. 1401–1409. arXiv 최초 등록 2015-12-04, 이 글의 기준은 v2(2016-04-13). 출처: 논문…
-
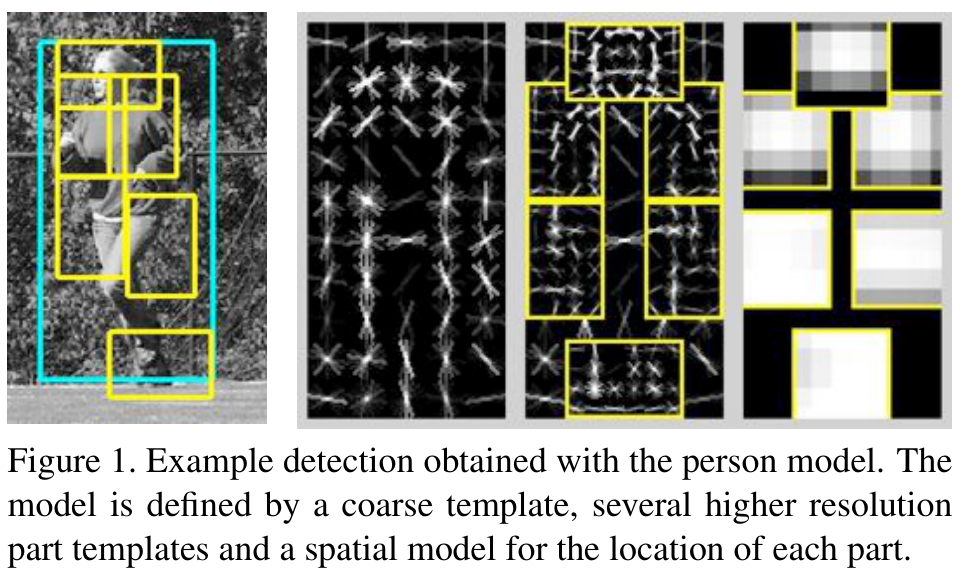
[논문 정리] DPM 두 논문 읽기: CVPR 2008의 변형 가능한 부품에서 TPAMI 2010의 혼합 모델까지
① CVPR 2008: A Discriminatively Trained, Multiscale, Deformable Part Model Pedro Felzenszwalb, David McAllester, Deva Ramanan. 출판 정보·원문 ② TPAMI 2010: Object Detection with Discriminatively Trained Part-Based Models Pedro F. Felzenszwalb, Ross B. Girshick, David…
-
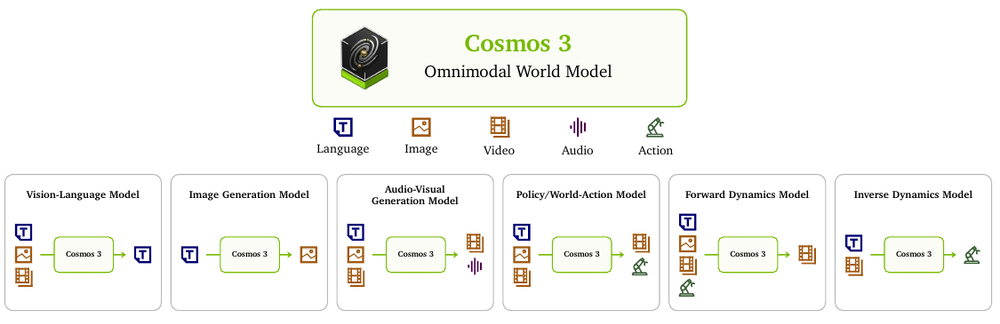
[논문 정리] Cosmos 3: 이해·생성·행동을 연결하는 Physical AI 월드 모델
Cosmos 3: Omnimodal World Models for Physical AI NVIDIA · 2026년 기술 보고서 · 보고서 표기일: 2026년 6월 22일 기술 보고서 · 공식 프로젝트 · 모델 모음 · 공식 코드 핵심 요약 로봇이 식탁을 치우려면…
-
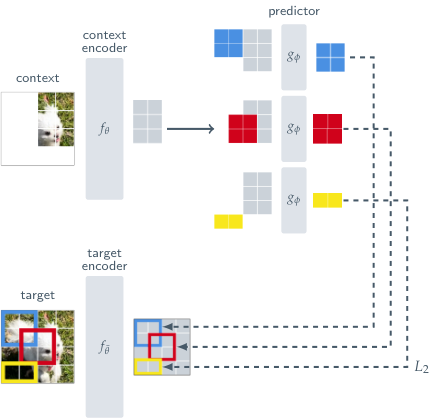
[논문 정리] I-JEPA: 픽셀 대신 의미 있는 표현을 예측하는 자기지도 학습
Self-Supervised Learning From Images With a Joint-Embedding Predictive Architecture Mahmoud Assran, Quentin Duval, Ishan Misra, Piotr Bojanowski, Pascal Vincent, Michael Rabbat, Yann LeCun, Nicolas Ballas · CVPR 2023 논문 · CVPR 공식 페이지 · 공식…
-
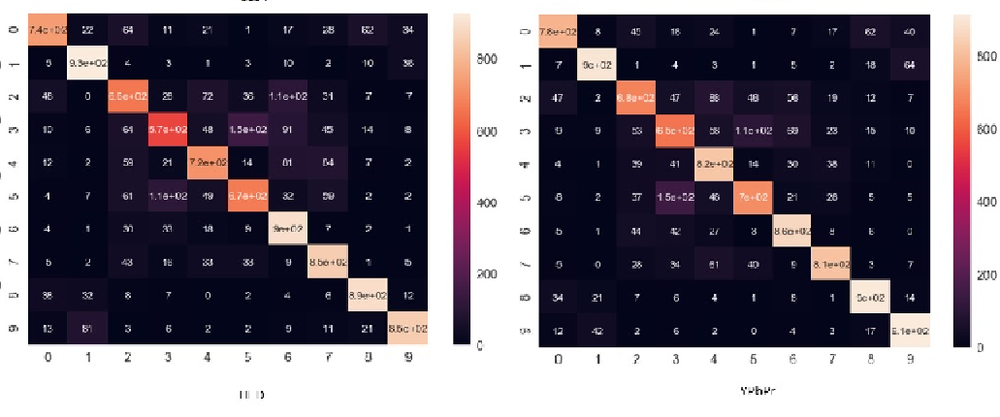
[논문 정리] ColorNet: 여러 색공간의 분류 결과를 결합하는 방법
ColorNet: Investigating the importance of color spaces for image classification Shreyank N Gowda, Chun Yuan · ACCV 2018 · arXiv 2019년 공개 논문 · 원문 핵심 요약 이 논문이 발표된 2018년 무렵에는 CNN을 더 깊게…
-
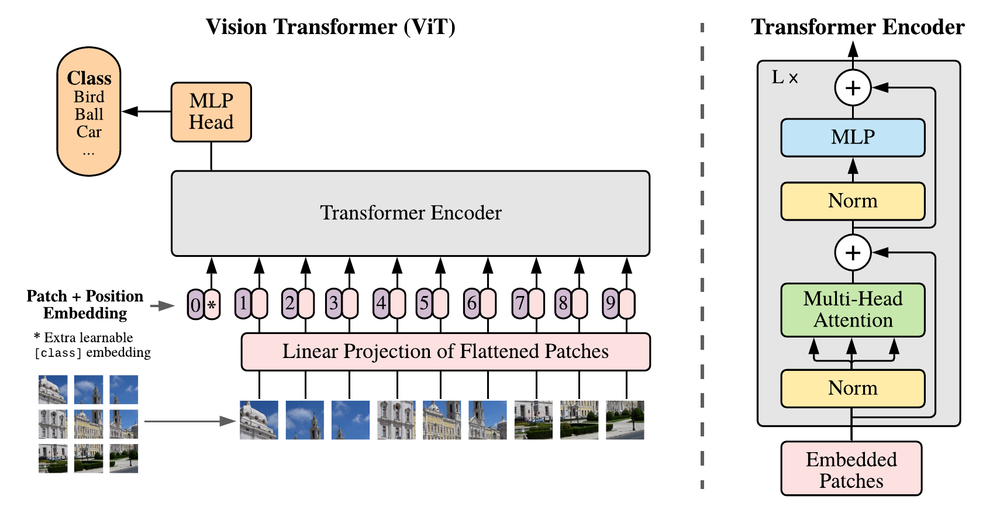
[논문 정리] Vision Transformer(ViT): 이미지를 패치 시퀀스로 읽는 Transformer
An Image is Worth 16×16 Words: Transformers for Image Recognition at Scale Alexey Dosovitskiy, Lucas Beyer, Alexander Kolesnikov 외 · Google Research, Brain Team · ICLR 2021 논문 · 원문 · 공식 구현·사전학습 모델 핵심…