논문: VINO: Revisiting 3D Representation Learning with Volume Transformers
저자: Adrian Kruse, Kadir Yilmaz, Daan de Geus, Francis Engelmann, Bastian Leibe
발표: 2026년 11월, arXiv 사전공개 논문 2611.07176v1
1. 배경과 핵심 요약
이미지에서는 DINO 계열처럼 정답 라벨 없이 학습한 표현을 고정하고 간단한 분류기만 붙여도 여러 작업에 활용할 수 있다. 하지만 3D 포인트 클라우드, 즉 공간에 흩어진 점들로 표현한 장면에서는 같은 접근의 성능이 충분히 따라오지 못했다. VINO는 이를 단순히 모델이나 데이터 크기의 문제로 보지 않고, 교사가 만드는 학습 목표가 일관적인지, 가렸다는 영역의 기하 정보가 실제로 숨겨졌는지부터 다시 묻는다.
- 교사는 안정적인 목표를 만든다: 강한 손상은 학생의 지역 뷰에만 적용하고, 교사의 목표 생성 헤드를 학생의 예측 헤드와 분리한다.
- 마스킹은 내용뿐 아니라 기하 정보도 가려야 한다: 가린 토큰을 학생 인코더에서 제거하고, 가린 위치끼리도 정보를 주고받지 못하게 한다.
- 이미지 지식은 시점 차이를 줄인 뒤 전달한다: 같은 3D 표면을 보는 이미지 패치들이 일치하는 프로토타입 분포를 갖도록 만든 다음 3D 모델을 학습시킨다.
결과적으로 VINO는 인코더를 고정한 의미 분할 평가에서 실내·실외 여섯 벤치마크 모두 강한 결과를 보인다. 여기서 중요한 점은 사전학습이 자기지도 방식이라는 뜻이지, 최종 평가의 분류기까지 라벨 없이 학습했다는 뜻은 아니라는 것이다.
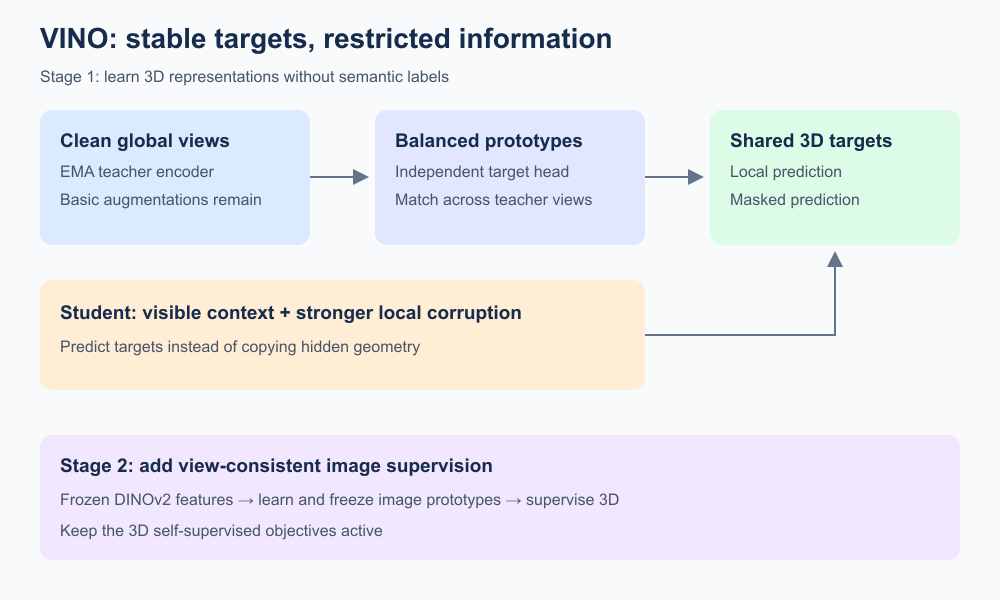
그림 1. 논문 §3과 Figure 3을 바탕으로 독립적으로 구성한 설명도. 교사의 3D 인코더는 학생의 지수이동평균으로 갱신하지만, 목표를 만드는 프로토타입은 별도로 학습한다. 이미지 증류는 두 번째 단계에서 추가한다.
2. 백본보다 중요한 것은 학습 문제의 설계
2.1 Volume Transformer: 3D 토큰을 같은 해상도로 다루기
출발점인 Sonata는 계층형 Point Transformer V3의 여러 단계 특징을 합쳐 학습한다. VINO는 이를 Volume Transformer(Volt)로 바꾼다. Volt는 공간 패치를 토큰으로 처리하는 ViT 유사 구조이므로, 여러 해상도의 특징을 다시 올리고 합치는 대신 출력 토큰에 직접 학습 목표를 줄 수 있다.
다만 백본 교체만으로 모든 개선이 설명되지는 않는다. ScanNet200의 논문 내 재현 실험에서 Sonata의 점수는 PTv3를 쓸 때 28.3, Volt로 바꾸면 29.6 mIoU다. 이후의 큰 개선은 교사·학생의 역할과 마스크 예측을 다시 설계하면서 나온다. 이 28.3은 뒤의 주 결과 표에서 인용하는 Sonata의 29.3과 다른 재현 기준선이다.
2.2 교사와 학생에게 같은 난도를 줄 필요는 없다
자기증류에서는 학생이 다른 뷰에서 얻은 교사의 출력을 맞힌다. 그런데 교사에게도 심한 변형과 점 제거를 적용하면, 학생이 따라가야 하는 목표 자체가 불안정해질 수 있다.
VINO는 교사의 전역 뷰에는 강한 손상을 넣지 않고, 학생의 지역 뷰에만 탄성 변형이나 점 드롭아웃 등을 적용한다. 여기서 ‘깨끗한 교사 뷰’는 증강이 전혀 없는 원본이라는 뜻은 아니다. 부록 A.2에 따르면 스케일·회전·뒤집기·좌표 지터 같은 기본 증강은 각 뷰에 적용되며, 강한 손상을 비대칭적으로 분리한 것이다.
또 하나의 분리는 헤드에서 일어난다. 교사 인코더는 계속 학생 인코더의 지수이동평균(EMA)으로 갱신하지만, 교사 헤드는 학생 헤드의 EMA 복사본으로 만들지 않는다. 손상된 입력에 적응하는 학생의 예측 공간과 안정적인 입력에서 정답을 만드는 교사의 공간을 분리하는 것이다.
교사 특징을 의미 기준 벡터인 프로토타입들과 비교하고, 한 프로토타입으로 쏠리지 않도록 균형 잡힌 확률 분포를 만든다. 원문 식 (1)은 다음과 같다.
\ell_{i,k}=\frac{c_k^\top x_i}{\|c_k\|_2\|x_i\|_2},\qquad P_t=\operatorname{SK}(\ell/\tau_t).여기서 는 교사의 토큰 특징, 는 프로토타입, 는 분포의 날카로움을 조절하는 온도다. SK는 Sinkhorn-Knopp 알고리즘으로, 프로토타입들이 균형 있게 사용되도록 할당을 조정한다. 학생은 대응 위치의 이 분포를 교차엔트로피로 예측한다.
프로토타입 자체는 교사의 두 전역 뷰에서 같은 위치에 해당하는 토큰들의 할당이 일치하도록 별도로 학습한다. 이때 교사 인코더와 정답 할당으로 향하는 기울기는 차단한다. 즉, 학생 예측을 맞추기 위해 교사 정답이 함께 움직이는 구조를 피한다.
2.3 빈칸의 위치가 이미 정답 힌트라면
이미지에서 패치를 마스크 토큰으로 바꾸면 그 칸의 픽셀은 사라진다. 하지만 희소한 3D 장면에서는 어느 좌표에 점이나 복셀이 존재하는가 자체가 물체 모양을 드러낸다. 가구의 색이나 특징을 지워도 다리와 상판을 이루는 위치들이 남아 있다면, 학생은 주변 문맥보다 가린 영역의 모양으로 답할 수 있다.
VINO는 마스크 토큰을 학생 인코더에 넣지 않는다. 인코더는 보이는 토큰만 처리하고, 별도의 가벼운 예측기가 숨긴 위치의 표현을 맞힌다. 이 예측기는 교차 어텐션만 사용한다. 각 질의는 자신의 위치와 보이는 문맥에는 접근하지만, 다른 마스크 질의와는 어텐션하지 않는다. 질의들끼리 위치를 모아 숨긴 물체의 모양을 다시 구성하는 우회로도 막는 셈이다.
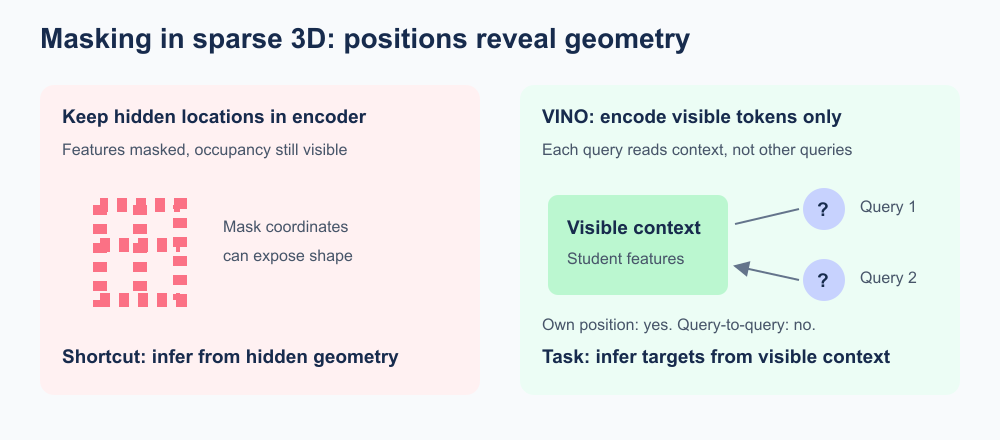
그림 2. 논문 §3.3과 Figure 2의 문제의식을 바탕으로 새로 그린 설명도. VINO가 모든 위치 정보를 없애는 것은 아니다. 각 질의는 자신의 좌표를 알지만, 다른 숨긴 질의의 좌표 집합을 읽지 못한다.
이 차이는 분석 실험에서도 드러난다. 교차 어텐션만 쓰면 ScanNet200에서 35.9 mIoU지만, 질의 간 어텐션을 추가하면 34.2, 완전한 자기 어텐션 디코더를 쓰면 33.0으로 내려간다(Table 11). 복원기를 복잡하게 만드는 것보다 어떤 정보가 통과하는가가 더 중요하다는 근거다.
VINO는 표현 크기가 점유 복셀 수에 좌우되는 문제도 줄인다. 레지스터 토큰으로 큰 노름의 이상 토큰을 억제하고, 공간 패치의 특징 집계를 점유 복셀 수로 나눠 평균화한다. 점이 많이 찬 패치라는 사실만으로 교사 표현을 맞히는 지름길을 약화하는 조치다.
3. 이미지의 지식도 그대로 회귀하지 않는다
2D 비전 모델의 특징을 3D로 옮기면 풍부한 의미 정보를 얻을 수 있다. 다만 같은 3D 표면도 카메라 시점과 이미지 격자 위치에 따라 서로 다른 2D 특징을 갖는다. 이 특징들을 그대로 맞히라고 하면, 하나의 3D 위치에 서로 다른 정답을 주는 문제가 생긴다.
VINO는 고정된 DINOv2-g/14 특징 공간에서 별도의 이미지 프로토타입을 학습한다. 카메라 자세와 깊이로 같은 표면을 보는 패치 쌍을 찾고, 두 패치의 프로토타입 할당이 일치하도록 만든다. 부록에 따르면 이렇게 학습한 이미지 프로토타입은 이후 고정한다. 학생은 같은 이미지 패치에 투영되는 3D 특징들을 평균낸 뒤, 그 패치의 프로토타입 분포를 예측한다. 시점 의존적인 특징 전체보다 여러 뷰에서 유지되는 부분을 전달하려는 설계다.
학습 순서도 분리한다.
- 1단계: 3D 자기지도 목표만으로 지역 예측·마스크 예측을 학습한다.
- 2단계: 3D 목표를 유지하면서, 고정된 이미지 모델과 프로토타입을 이용한 2D-3D 증류를 더한다.
아래는 ScanNet200에서 학습 순서와 목표 표현을 바꾼 분석이다. 전부 선형 탐침의 mIoU이며, 주 실험의 다른 모델 간 비교와 구분해야 한다.
| 2D-3D 증류 설정 | ScanNet200 mIoU |
|---|---|
| 처음부터 이미지 정렬 | 37.2 |
| 3D 선행 학습 후 원시 이미지 특징 정렬 | 38.6 |
| 3D 선행 학습 후 프로토타입 목표 | 40.4 |
Table 4 재구성. 2단계 학습으로 1.4포인트, 원시 특징 대신 프로토타입 목표를 사용해 추가 1.8포인트 개선된다. 같은 조건에서 각 변화의 효과를 구분한 결과다.
4. 실험: 고정한 3D 표현은 얼마나 유용한가
저자들은 실내와 실외에 별도 모델을 학습했다. 실내 1단계는 약 18,000개 장면, 이미지 증류가 필요한 2단계는 RealEstate10K 재구성 데이터를 더한 약 90,000개 장면을 사용한다. 실외는 두 단계 모두 약 110,000개 LiDAR 스캔을 사용한다. 1단계는 200,000스텝, 2단계는 추가 30,000스텝이며, 기본 마스킹 비율은 55%다.
4.1 선형 탐침: 인코더를 고정한 의미 분할
선형 탐침(linear probing)은 사전학습 인코더를 고정한 상태에서 라벨이 있는 훈련 분할로 선형 분류기만 학습하는 평가다. 아래는 검증 분할에서의 mIoU로, 클래스별 IoU를 평균한 값이다. 이 설정은 최종 작업에 맞춰 전체 모델을 다시 학습하는 미세조정과 다르다.
| 모델과 사전학습 | ScanNet200 | ScanNet++ | nuScenes | SemanticKITTI | Waymo |
|---|---|---|---|---|---|
| Sonata: 3D만 | 29.3 | 38.9 | 66.1 | 62.0 | 60.5 |
| DOS: 3D만 | 30.7 | 미보고 | 74.8 | 68.3 | 67.0 |
| VINO: 3D만 | 35.9 | 42.4 | 76.7 | 70.7 | 68.6 |
| Concerto: 2D 추가 | 37.4 | 45.6 | 74.2 | 66.6 | 62.2 |
| Utonia: 2D 추가 | 36.4 | 44.7 | 75.5 | 67.7 | 63.8 |
| VINO: 2D 추가 | 40.4 | 48.2 | 80.6 | 71.1 | 70.6 |
Table 5에서 대표 데이터셋과 모델을 선택했다. DOS의 실외 결과는 PTv3-S를 사용하며, 대부분의 기존 방법이 쓰는 PTv3-B와 크기가 다르다. 백본과 사전학습 데이터가 완전히 통제된 비교는 아니다.
3D만 사용하는 VINO는 ScanNet200에서 이전 3D 전용 방법 중 가장 높은 DOS의 30.7보다 5.2 mIoU 포인트 높다. VINO 자체에 이미지 증류를 추가하면 35.9에서 40.4로 4.5포인트 상승한다. 다만 이 4.5포인트는 프로토타입 손실만의 효과가 아니다. 학습 단계·데이터 구성·증강도 함께 달라지므로, 목표 설계의 효과는 앞의 Table 4 분석과 나눠 읽어야 한다.
표에서 생략한 ScanNet에서도 VINO의 3D 전용 모델은 76.9, 2D 추가 모델은 77.9를 기록한다. 논문은 Table 5의 여섯 벤치마크에서 각 사전학습 그룹 내 최고 선형 탐침 결과를 보고한다.
4.2 미세조정과 다른 작업에서는 예외도 있다
전체 인코더와 작업별 디코더를 함께 미세조정하면, VINO는 의미 분할에서 ScanNet200 42.7, ScanNet++ 52.6, nuScenes 83.2 mIoU를 기록한다. 하지만 모든 데이터셋에서 최고는 아니다. Waymo에서는 VINO가 72.9이고 DOS는 73.9다(Table 6).
인스턴스 분할도 지표를 구분해야 한다. 고정 인코더 위에 PointGroup의 선형 의미·오프셋 헤드를 학습하면 ScanNet200에서 VINO는 35.0 mAP50·18.7 mAP를 기록한다. 반면 ScanNet++의 mAP는 VINO 18.0, Concerto 18.2로 뒤진다(Table 7). mAP50은 IoU 0.5 기준이고, mAP는 여러 IoU 기준을 평균하므로 같은 지표처럼 읽으면 안 된다.
사전학습에 없던 3DMatch·3DLoMatch에서는 고정 표현으로 대응점을 찾고, 공통 SC²-PCR 후처리로 정합을 수행했다. VINO의 성공률은 각각 84.1%·44.6%, Utonia는 76.5%·36.3%였다(Table 9). 이는 정합 전용 학습 없이 전이된 표현의 유용성을 보여주지만, 모든 정합 전용 시스템을 이겼다는 비교는 아니다.
5. 정리와 읽을 때의 한계
VINO의 핵심은 ‘이미지에서 성공한 학습법을 3D로 옮긴다’보다 한 단계 더 들어간다. 희소한 3D 장면에서는 토큰의 존재와 위치가 이미 기하 정보를 담고 있으므로, 정답을 만드는 방식과 학생이 볼 수 있는 정보의 범위를 함께 설계해야 한다는 주장이다. 교사·학생의 헤드 분리, 마스크 질의 간 통신 차단, 시점 일관적인 이미지 목표가 이 관점을 공유한다.
해석에는 다음 조건이 따른다.
- 하나의 범용 모델 결과는 아니다: 실내·실외 모델은 별도로 학습했고, 이미지 증류에는 정렬된 이미지와 카메라 기하 정보가 필요하다.
- 무라벨 사전학습과 무라벨 최종 작업은 다르다: 의미·인스턴스 분할의 탐침과 미세조정은 작업별 라벨을 쓴다.
- 학습 규모와 비용이 있다: 부록은 1단계에 실내 H100 8장·실외 16장으로 각각 약 24시간, 2단계에 각각 약 9시간·8시간을 보고한다. 이미지 프로토타입 학습도 별도 절차다.
- 표현 지표를 넘어선 범용성은 추가 검증 대상이다: 이 글의 해석으로는 로보틱스 행동 제어·장기 시퀀스·임의 센서에서의 활용까지 검증했다고 확대할 수 없다.
여기의 수치는 저자들이 보고한 실험 결과이며, 별도의 모델 학습이나 재현 실행을 수행한 결과는 아니다. 그 범위 안에서 VINO는 모델을 키우기 전에 학습에 숨어 있는 쉬운 지름길과 서로 충돌하는 목표부터 점검하는 접근의 효과를 보여준다.
답글 남기기