[태그:] Self-Supervised Learning
-
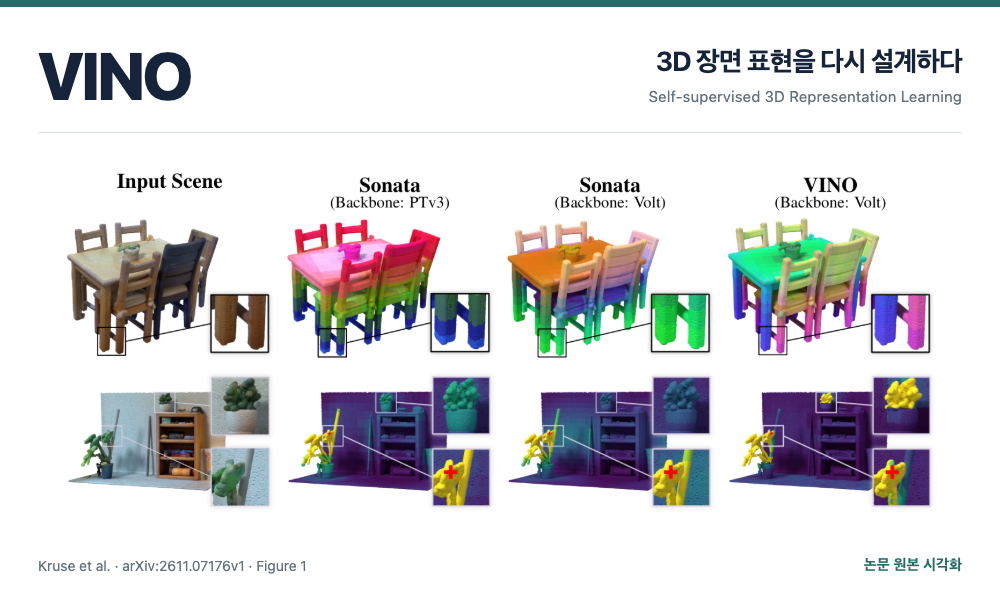
[논문정리] VINO: 3D 자기지도학습에서 정답과 마스킹을 다시 설계하다
논문: VINO: Revisiting 3D Representation Learning with Volume Transformers 저자: Adrian Kruse, Kadir Yilmaz, Daan de Geus, Francis Engelmann, Bastian Leibe 발표: 2026년 11월, arXiv 사전공개 논문 2611.07176v1 1. 배경과 핵심 요약 이미지에서는 DINO 계열처럼 정답 라벨 없이 학습한 표현을 고정하고 간단한 분류기만 붙여도 여러 작업에 활용할 수 있다. 하지만 3D 포인트 클라우드, 즉 공간에…
-
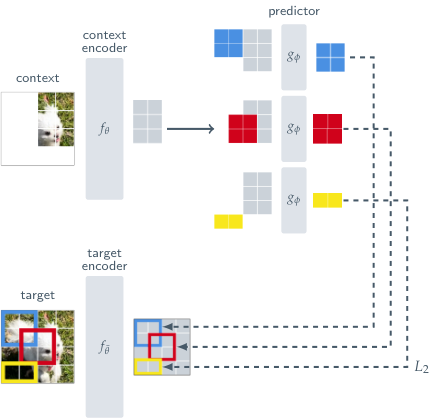
[논문 정리] I-JEPA: 픽셀 대신 의미 있는 표현을 예측하는 자기지도 학습
Self-Supervised Learning From Images With a Joint-Embedding Predictive Architecture Mahmoud Assran, Quentin Duval, Ishan Misra, Piotr Bojanowski, Pascal Vincent, Michael Rabbat, Yann LeCun, Nicolas Ballas · CVPR 2023 논문 · CVPR 공식 페이지 · 공식 코드 핵심 요약 이미지의 정답 라벨 없이 유용한 특징을 배우려면 어떤 문제를 풀게 해야 할까? 당시 자기지도 학습에서는 같은 사진을…
-
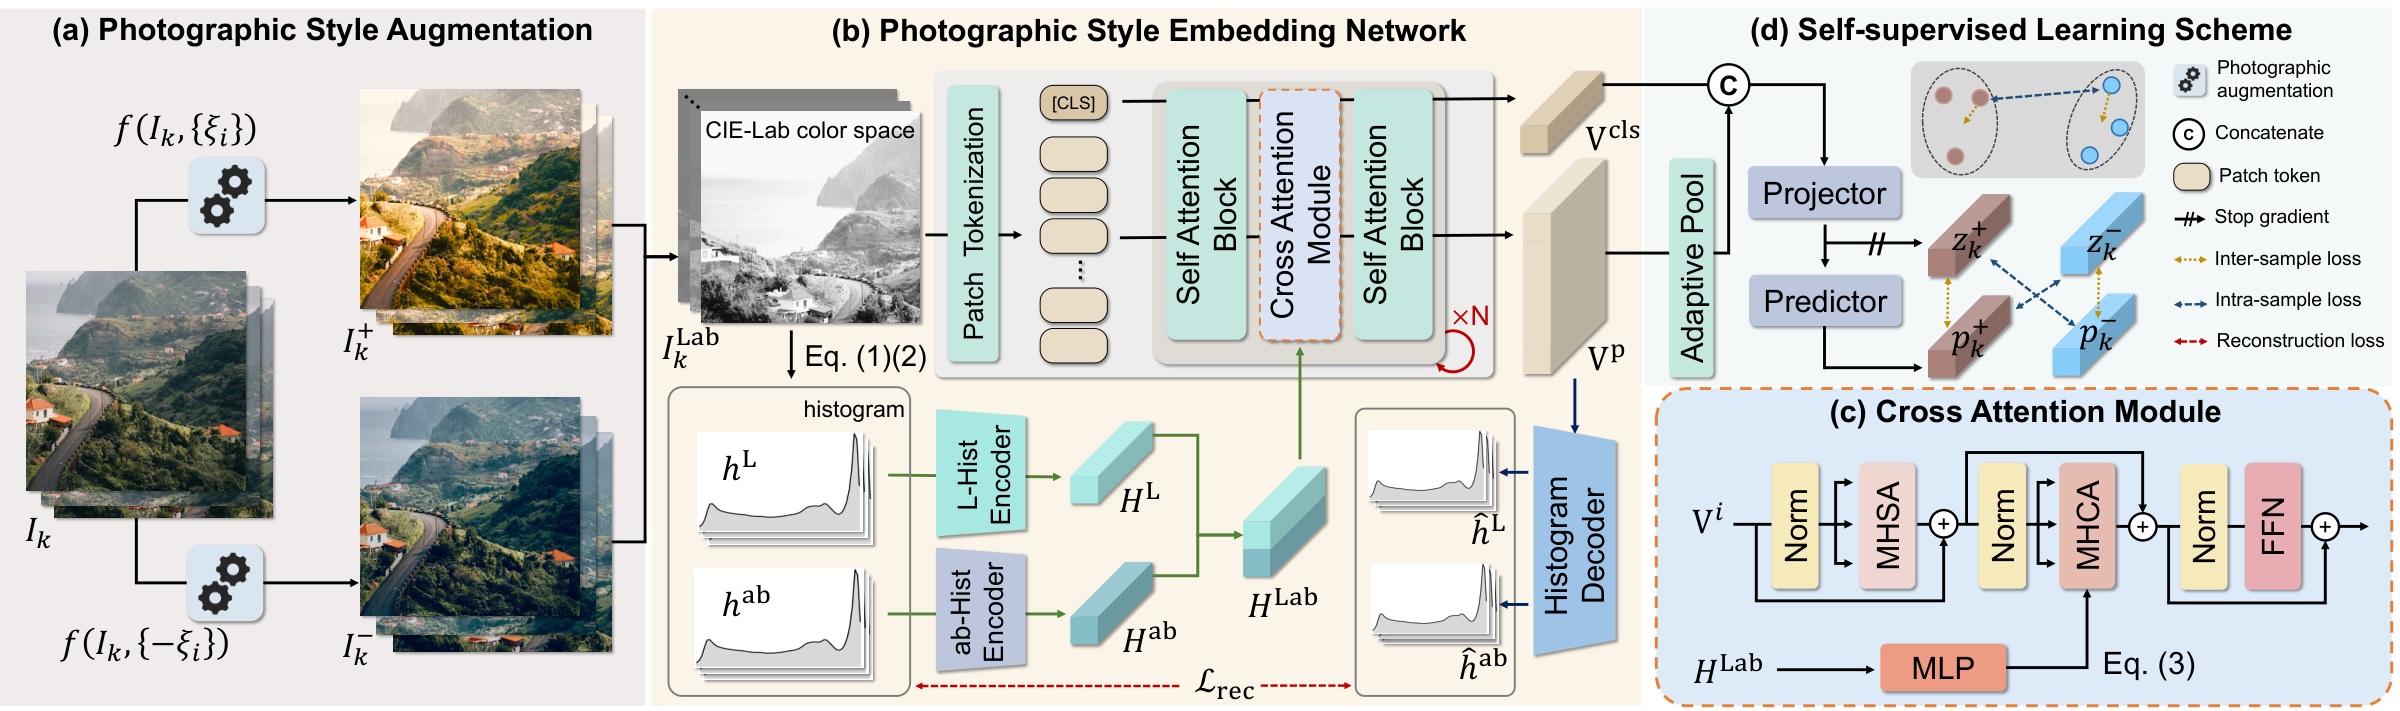
[논문 정리] PETAL: 사진의 내용은 유지하고 색감과 분위기를 옮기는 방법
Enlightening Photographic Style Transfer with a Self-Supervised Photographic Embedding Chengxuan Zhu, Jiacong Fang 외 · ECCV 2026 논문 · 프로젝트 · 코드 · 모델 가중치 핵심 요약 PETAL은 사진의 노출·대비·색조 같은 스타일을 표현하는 임베딩을 먼저 학습한다. 그 임베딩으로 가벼운 이미지 변환기를 조절해, 참조 사진의 분위기를 다른 사진에 옮긴다. 핵심은 두 부분이다. 어떤 분위기인지 읽는 모델과…