[카테고리:] 논문
-
[논문 정리] I-JEPA: 픽셀 대신 의미 있는 표현을 예측하는 자기지도 학습
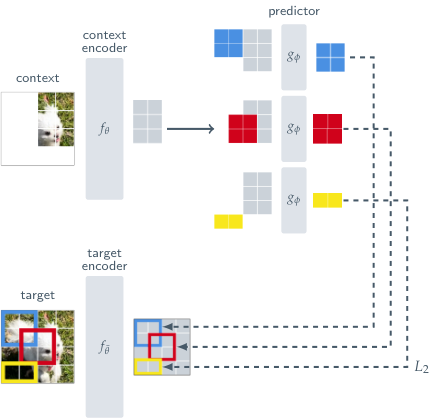
Self-Supervised Learning From Images With a Joint-Embedding Predictive Architecture Mahmoud Assran, Quentin Duval, Ishan Misra, Piotr Bojanowski, Pascal Vincent, Michael Rabbat, Yann LeCun, Nicolas Ballas · CVPR 2023 논문 · CVPR 공식 페이지 · 공식 코드 핵심 요약 이미지의 정답 라벨 없이 유용한 특징을 배우려면 어떤 문제를 풀게 해야 할까? 당시 자기지도 학습에서는 같은 사진을…
-
[논문 정리] ColorNet: 여러 색공간의 분류 결과를 결합하는 방법
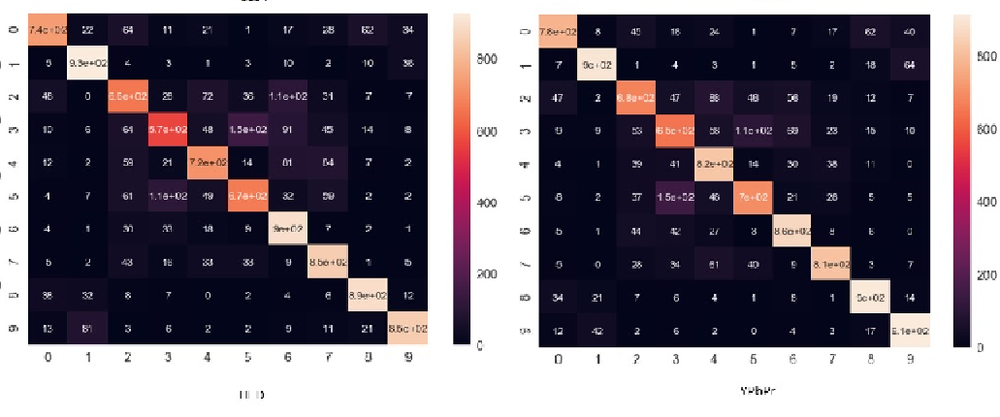
ColorNet: Investigating the importance of color spaces for image classification Shreyank N Gowda, Chun Yuan · ACCV 2018 · arXiv 2019년 공개 논문 · 원문 핵심 요약 이 논문이 발표된 2018년 무렵에는 CNN을 더 깊게 만들거나 층 사이 연결을 개선해 이미지 분류 성능을 높이는 연구가 활발했다. 반면 입력 이미지는 RGB로 사용하는 경우가 많았다. ColorNet은 같은…
-
[논문 정리] Vision Transformer(ViT): 이미지를 패치 시퀀스로 읽는 Transformer
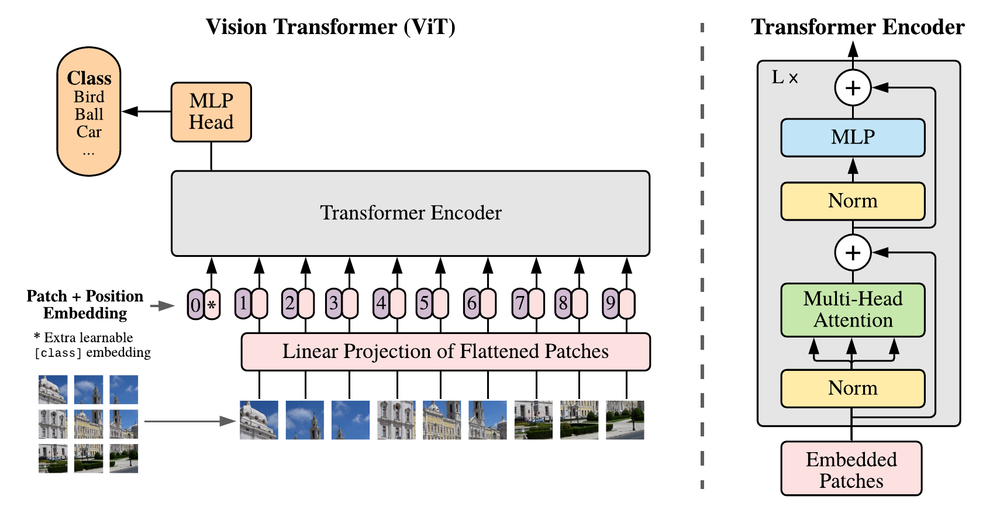
An Image is Worth 16×16 Words: Transformers for Image Recognition at Scale Alexey Dosovitskiy, Lucas Beyer, Alexander Kolesnikov 외 · Google Research, Brain Team · ICLR 2021 논문 · 원문 · 공식 구현·사전학습 모델 핵심 요약 이 논문이 처음 공개된 2020년에는 자연어 처리에서 Transformer의 대규모 사전학습이 확산된 반면, 이미지 인식에서는 CNN이 중심이었다. 비전에 attention을 적용하는…
-
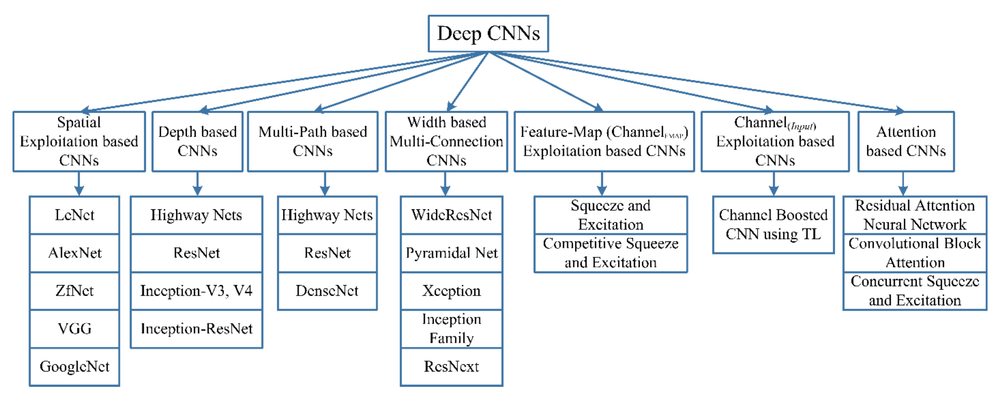
[논문 정리] CNN 아키텍처 서베이: 구조의 발전과 7가지 분류
A Survey of the Recent Architectures of Deep Convolutional Neural Networks Asifullah Khan, Anabia Sohail, Umme Zahoora, Aqsa Saeed Qureshi · Artificial Intelligence Review, 2020 논문 · 원문 · 출판 DOI 핵심 요약 이 논문은 ImageNet 같은 대규모 이미지 데이터와 GPU 학습을 바탕으로 CNN 아키텍처가 빠르게 다양해지던 시기를 다룬다. 특히 AlexNet 이후인 2012~2020년의 주요 구조를…
-
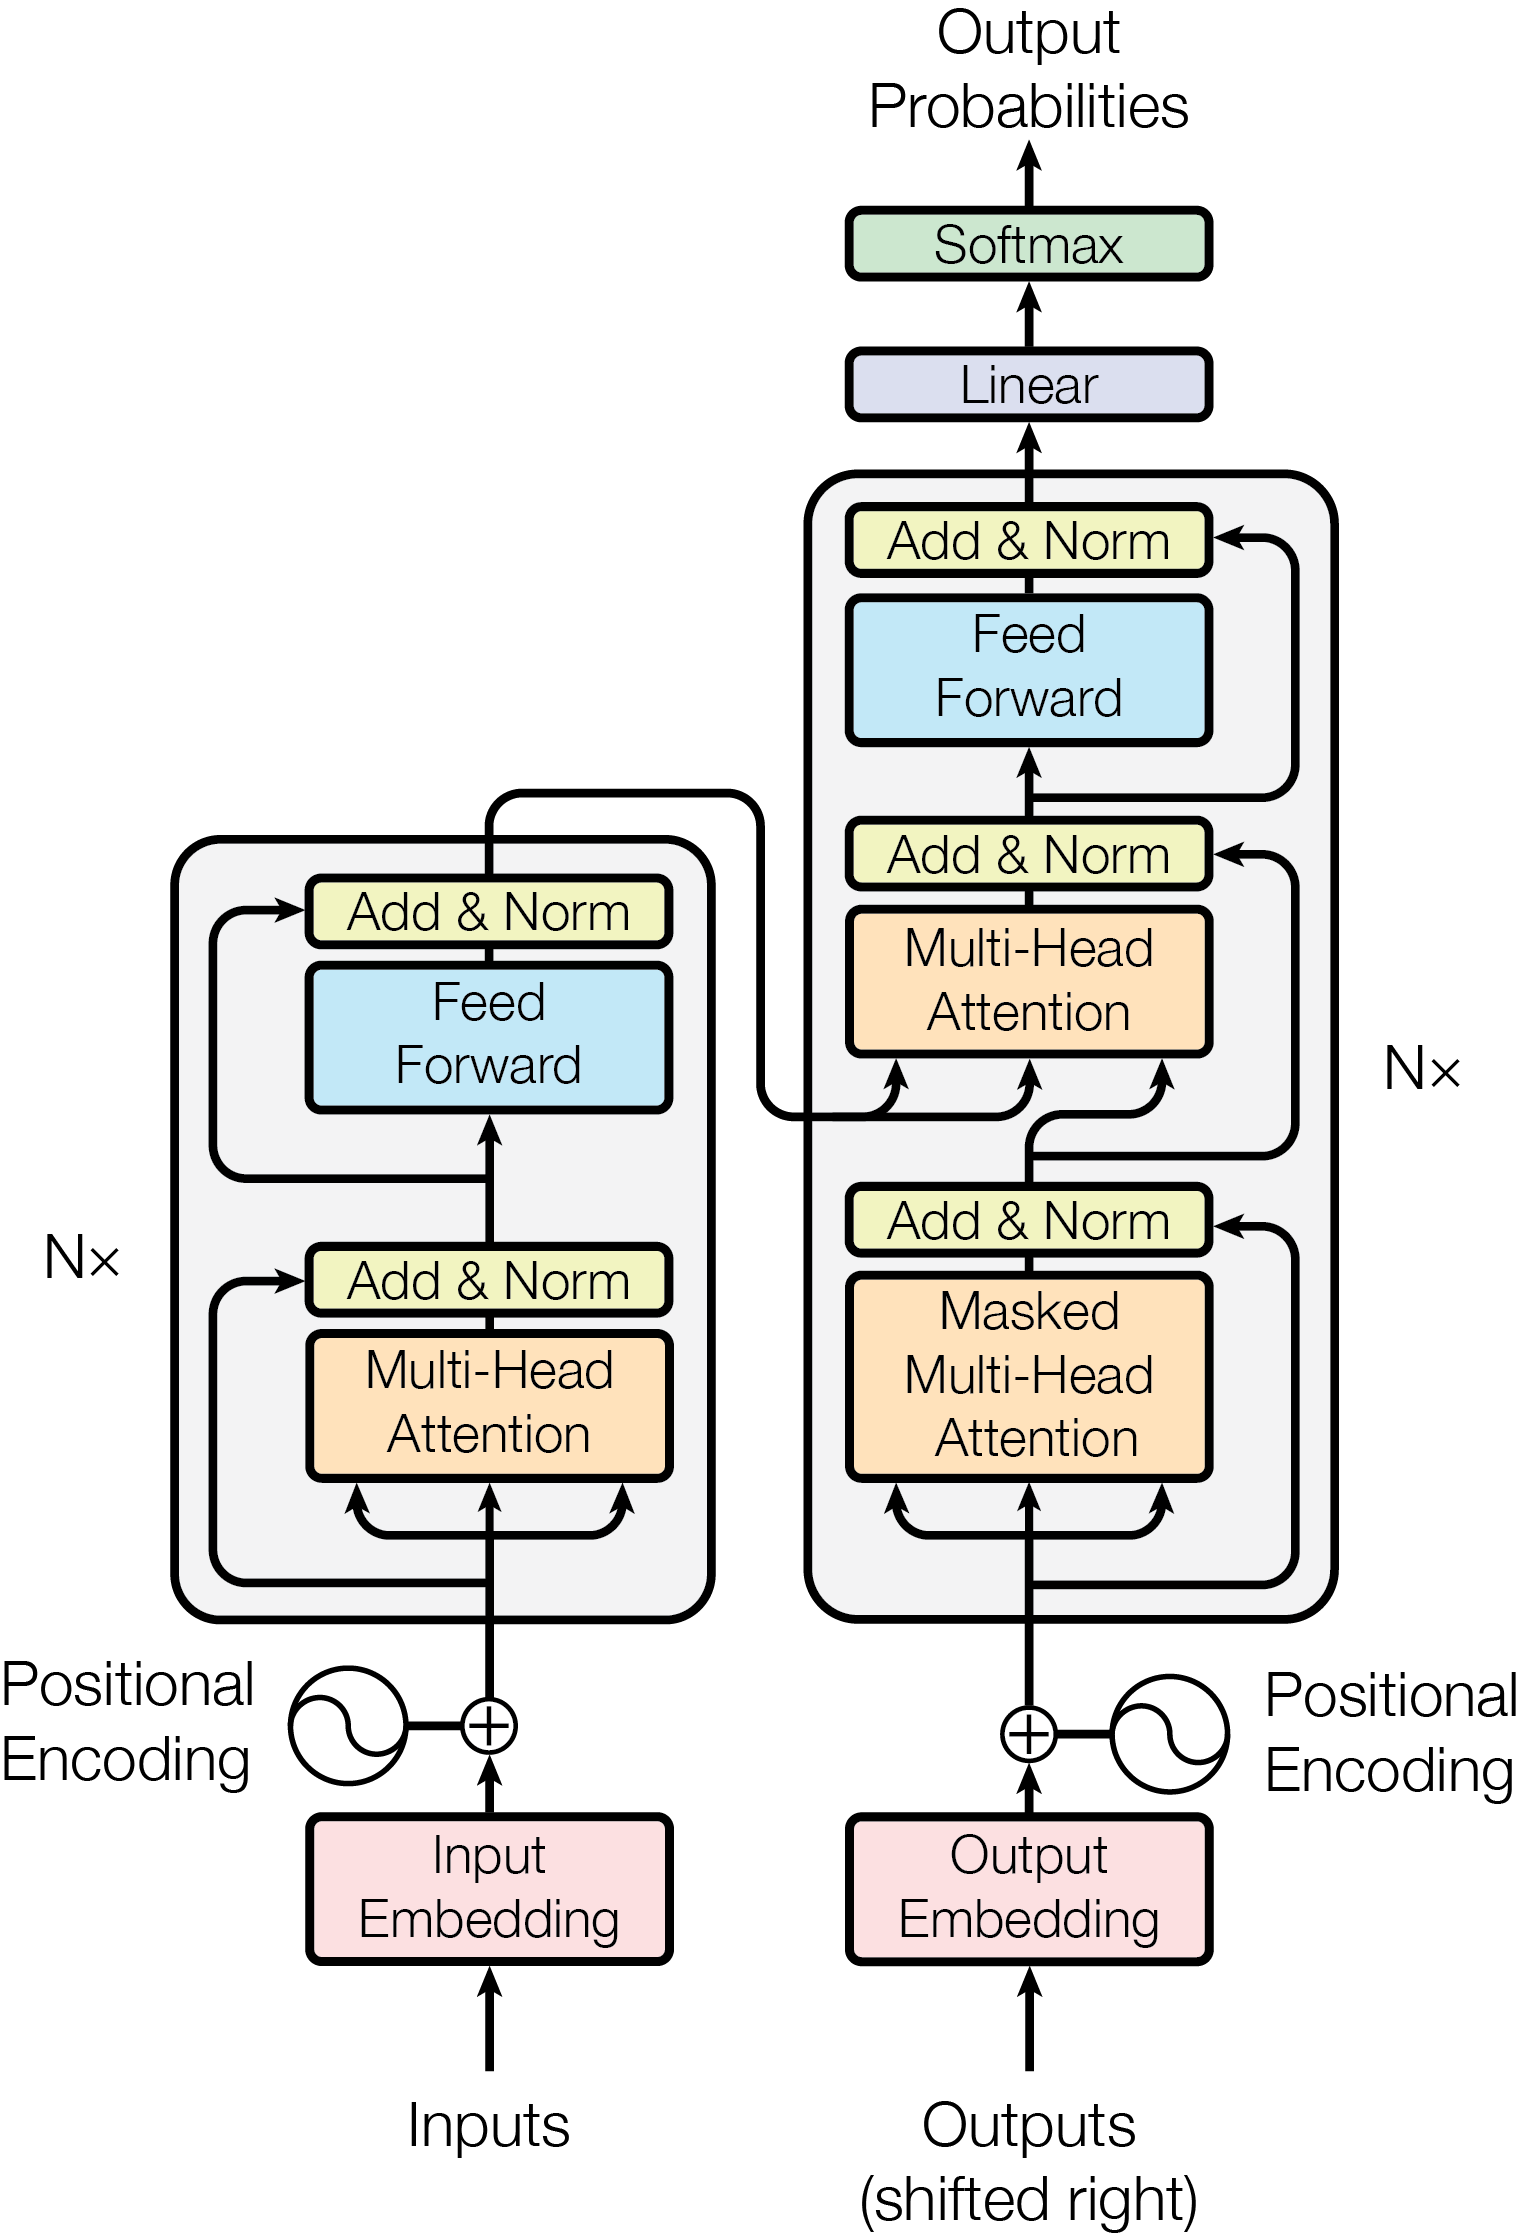
[논문 정리] Attention Is All You Need: Transformer의 구조와 핵심 원리
Attention Is All You Need Ashish Vaswani, Noam Shazeer, Niki Parmar, Jakob Uszkoreit, Llion Jones, Aidan N. Gomez, Łukasz Kaiser, Illia Polosukhin · NIPS 2017 논문 · 본문 · 공식 구현 핵심 요약 이 논문이 발표된 2017년의 기계 번역 연구에서는 RNN·LSTM 기반 인코더·디코더에 attention을 결합하는 방식이 널리 사용됐다. 그러나 토큰을 순서대로 처리하는 구조는 학습 병렬화와…
-
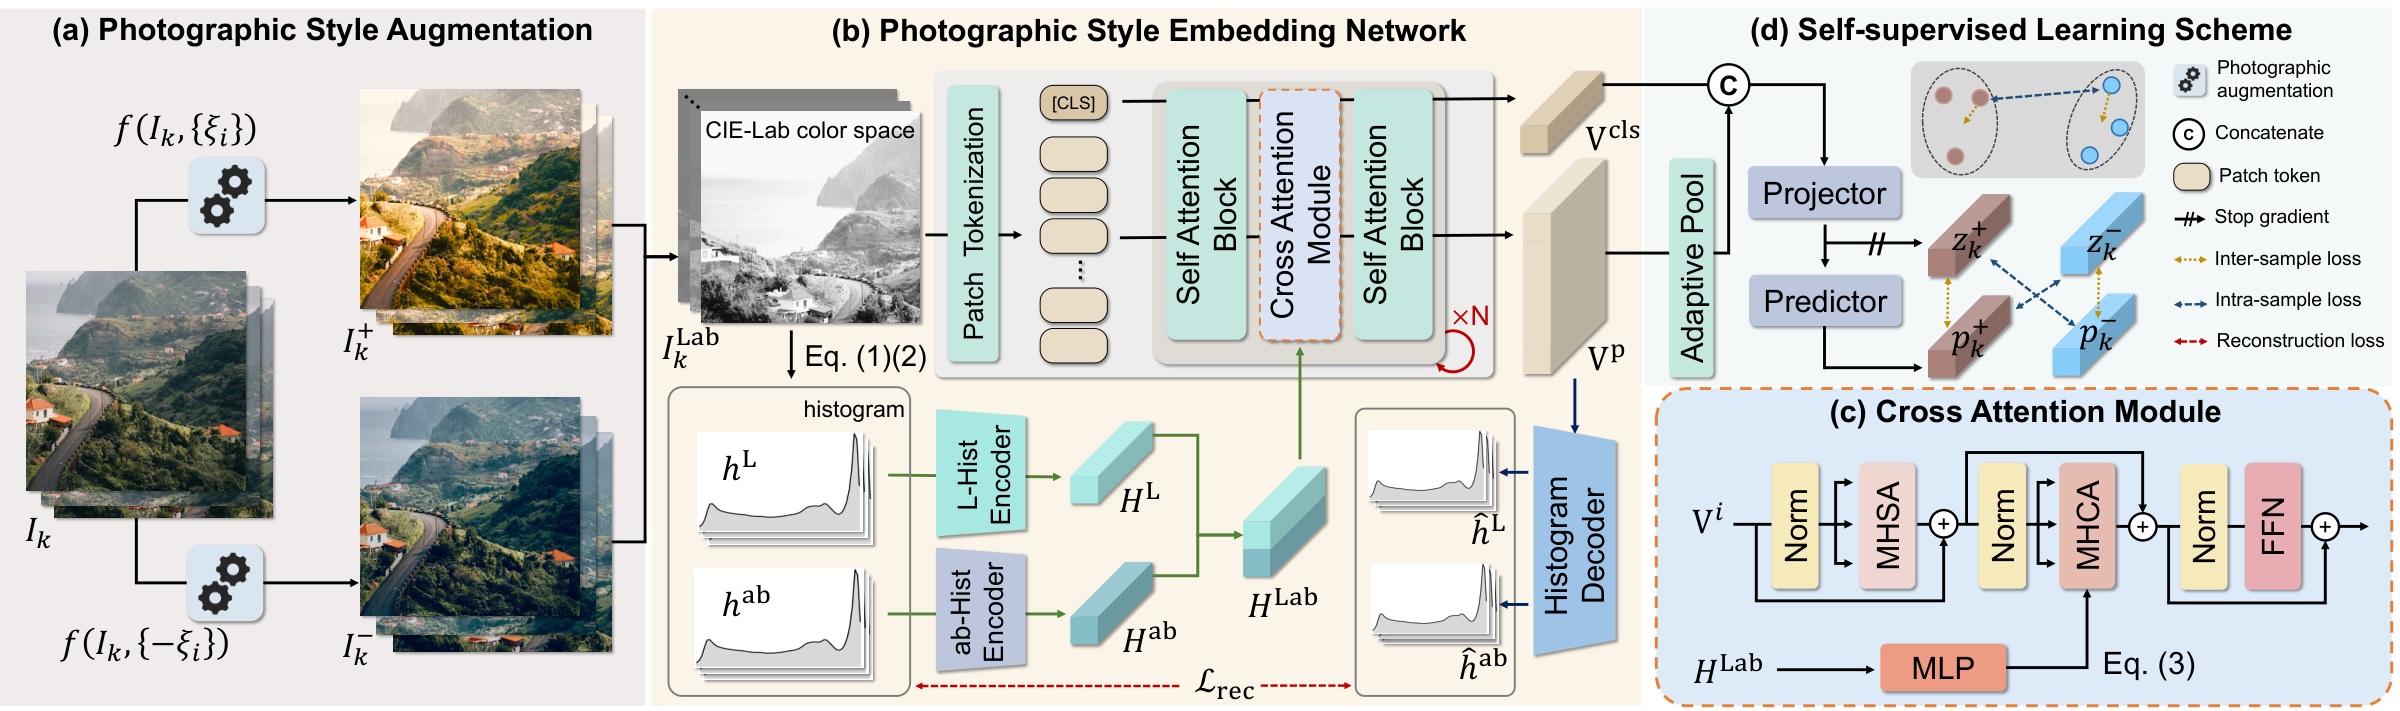
[논문 정리] PETAL: 사진의 내용은 유지하고 색감과 분위기를 옮기는 방법
Enlightening Photographic Style Transfer with a Self-Supervised Photographic Embedding Chengxuan Zhu, Jiacong Fang 외 · ECCV 2026 논문 · 프로젝트 · 코드 · 모델 가중치 핵심 요약 PETAL은 사진의 노출·대비·색조 같은 스타일을 표현하는 임베딩을 먼저 학습한다. 그 임베딩으로 가벼운 이미지 변환기를 조절해, 참조 사진의 분위기를 다른 사진에 옮긴다. 핵심은 두 부분이다. 어떤 분위기인지 읽는 모델과…