Self-Supervised Learning From Images With a Joint-Embedding Predictive Architecture
Mahmoud Assran, Quentin Duval, Ishan Misra, Piotr Bojanowski, Pascal Vincent, Michael Rabbat, Yann LeCun, Nicolas Ballas · CVPR 2023
논문 · CVPR 공식 페이지 · 공식 코드
핵심 요약
이미지의 정답 라벨 없이 유용한 특징을 배우려면 어떤 문제를 풀게 해야 할까? 당시 자기지도 학습에서는 같은 사진을 여러 방식으로 변형해 비슷한 표현을 만들거나, 가린 부분의 픽셀을 복원하는 방법이 널리 쓰였다. 전자는 어떤 변화에 둔감해야 하는지 사람이 설계해야 하고, 후자는 의미 이해에 꼭 필요하지 않은 세부 질감까지 맞혀야 한다. I-JEPA는 보이는 영역을 단서로 가려진 영역의 ‘특징 표현’을 예측하면, 강한 이미지 증강이나 픽셀 복원 없이도 의미 있는 특징을 배울 수 있는지를 검토한다.
- 예측할 정답은 픽셀이나 클래스 이름이 아니다. 전체 이미지를 읽은 타깃 인코더가 만든 패치별 특징 벡터다.
- 컨텍스트 인코더는 보이는 패치만 읽고, 예측기는 가려진 위치 정보를 받아 그 위치의 특징을 예측한다.
- 표현 공간에서 예측한다는 것만큼 무엇을 얼마나 가릴지도 중요하다. 충분히 큰 여러 타깃 영역과 공간적으로 넓게 남은 단서를 함께 사용한다.
- ImageNet에서 인코더를 고정한 분류 평가와 라벨이 적은 평가에 강점을 보였다. 다만 모든 과제에서 기존 방법보다 좋은 것은 아니며, 이미지 생성 모델로 이해해서도 안 된다.
1. Introduction: 무엇을 예측해야 좋은 표현을 배울까?
자기지도 학습은 데이터 자체에서 학습 문제를 만들어, 사람이 붙인 라벨 없이도 이후 과제에 쓸 표현을 얻는 방식이다. 예를 들어 같은 사진에서 만든 두 뷰의 표현을 비슷하게 만들면, 색감이나 잘린 위치가 달라도 같은 물체임을 알아보도록 유도할 수 있다. 하지만 분류에서는 유용한 불변성이 물체의 개수나 위치까지 알아야 하는 과제에서도 항상 좋은 것은 아니다.
반대로 MAE 같은 복원 기반 방법은 일부 패치를 숨긴 뒤 원래 픽셀을 맞히게 한다. 여러 종류의 데이터에 적용하기 쉬운 접근이지만, 보이지 않는 영역의 정확한 색과 질감까지 예측해야 한다. I-JEPA의 질문은 여기서 나온다. 정확한 픽셀을 모두 복원하는 대신, 다른 네트워크가 추출한 추상적인 특징을 맞히면 어떨까?
| 접근 | 학습시키는 관계 | I-JEPA와 비교할 핵심 |
|---|---|---|
| 뷰 불변성 기반: DINO 등 | 같은 이미지에서 만든 여러 뷰의 표현을 일치시킨다 | 어떤 변형에도 같아야 하는지를 증강으로 설계한다 |
| 픽셀 복원 기반: MAE 등 | 보이는 패치로 가린 픽셀을 복원한다 | 정답에 세밀한 색·질감까지 포함된다 |
| 표현 예측 기반: I-JEPA | 보이는 패치와 타깃 위치로 가린 영역의 특징을 예측한다 | 학습 중인 인코더가 예측할 표현 공간을 만든다 |
표현을 예측한다는 아이디어 자체가 I-JEPA에서 처음 나온 것은 아니다. 논문도 data2vec와 Context Autoencoder를 가까운 선행 연구로 다룬다. I-JEPA에서 눈여겨볼 부분은 표현 예측과 다중 블록 마스킹을 결합해, 적은 추가 학습으로도 쓸 만한 특징을 얻는 설계다.
2. I-JEPA의 구조: 같은 이미지를 서로 다르게 읽는다
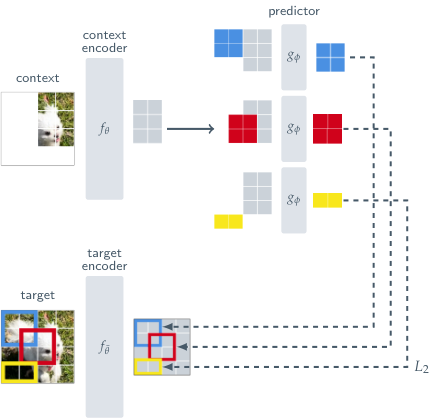
논문 Figure 3. 위쪽 경로는 보이는 영역으로 타깃 특징을 예측하고, 아래쪽 경로는 전체 이미지에서 비교할 특징을 만든다. 색이 다른 토큰은 예측할 위치를 나타낸다. 출처: Assran et al., CVPR 2023.
2.1. 타깃 인코더: 전체를 본 뒤 정답 영역을 고른다
먼저 이미지를 패치로 나눠 타깃 인코더(target encoder)에 넣는다. 이 인코더는 전체 이미지를 읽고 각 패치 위치에 대응하는 특징 벡터를 출력한다. 그다음 예측 대상으로 정한 영역의 벡터만 골라 학습의 정답으로 사용한다.
여기서 순서가 중요하다. 타깃 영역만 잘라 인코더에 넣는 것이 아니라, 전체 이미지를 인코딩한 뒤 출력에서 해당 위치를 선택한다. 따라서 정답 특징에는 주변과 물체 전체의 관계가 반영될 수 있다. 정답은 미리 정한 물체 이름도, 외부 모델이 붙여 준 라벨도 아니다.
2.2. 컨텍스트 인코더: 정답 영역을 보지 않고 단서를 읽는다
컨텍스트(context)는 예측에 사용할 보이는 부분이다. 큰 영역을 하나 고른 뒤, 타깃과 겹치는 부분을 제거해 만든다. 컨텍스트 인코더의 Transformer는 이렇게 남은 패치만 처리한다.
한 장을 인코딩해 만든 특징을 양쪽에서 그대로 비교하는 구조가 아니다. 타깃 인코더는 전체를 보지만, 컨텍스트 인코더는 타깃 영역을 볼 수 없다. 이 정보 차이가 예측 문제를 만든다.
2.3. 예측기: 같은 단서라도 어디를 물어보는지에 따라 답이 달라진다
예측기(predictor)는 컨텍스트 특징과 예측할 위치의 마스크 토큰을 함께 받는 작은 폭의 ViT다. 마스크 토큰은 학습 가능한 공통 벡터에 위치 임베딩을 더해 만든다. 컨텍스트 특징을 재사용하면서, 타깃 블록마다 다른 위치를 지정해 패치별 특징을 예측한다.
예를 들어 새의 일부가 보일 때, 가려진 영역이 머리 쪽인지 몸통 쪽인지에 따라 예측할 내용이 달라져야 한다. 이 예시는 위치 조건의 역할을 설명하기 위한 것으로, 모델이 ‘머리’라는 단어를 출력한다는 뜻은 아니다.
논문의 예측 관계를 간단히 다시 쓰면 다음과 같다.
\hat{\mathbf{s}}_y^{(i)}
=g_\phi\left(\mathbf{s}_x,\{\mathbf{m}_j\}_{j\in B_i}\right)- : 보이는 컨텍스트에서 추출한 특징.
- : i번째 타깃 블록의 패치 위치 집합.
- : j번째 위치를 지정하는 마스크 토큰.
- : 해당 블록에 대한 예측 특징. 한 개의 전역 벡터가 아니라 패치별 벡터들의 집합이다.
2.4. 학습: 예측을 맞추되, 정답 네트워크는 천천히 바꾼다
논문 §3은 예측 특징과 타깃 특징의 차이를 다음 제곱 L2 손실로 설명한다.
\mathcal{L}=\frac{1}{M}\sum_{i=1}^{M}\sum_{j\in B_i}
\left\|\hat{\mathbf{s}}_{y_j}-\mathbf{s}_{y_j}\right\|_2^2
여기서 M은 타깃 블록 수다. 컨텍스트 인코더와 예측기는 이 오차를 줄이도록 역전파로 학습한다. 반면 타깃 인코더에는 기울기를 전달하지 않고, 컨텍스트 인코더 가중치의 지수이동평균(EMA)으로 갱신한다. 업데이트 규칙을 풀어 쓰면 다음과 같다.
\bar{\theta}\leftarrow\tau\bar{\theta}+(1-\tau)\thetaθ는 컨텍스트 인코더의 가중치, θ̄는 타깃 인코더의 가중치이며, τ가 클수록 타깃이 천천히 변한다. 타깃 인코더는 처음에는 컨텍스트 인코더의 복사본이고, 학습 중 조금씩 따라가는 정답 생성기가 된다.
입력에 상관없이 모두 같은 벡터를 내면 표현 학습이 무너지는 표현 붕괴(representation collapse)가 생길 수 있다. I-JEPA는 예측기·기울기 차단·EMA를 이용한 비대칭 구조를 사용하며, 저자들은 EMA 타깃이 학습에 필수적이었다고 보고한다. EMA 식 하나만으로 모든 조건에서 붕괴를 막는다고 보장하는 것은 아니다.
공개 구현에서는 손실이 다르다. 공식 src/train.py는 타깃 특징을 LayerNorm으로 정규화한 뒤 F.smooth_l1_loss로 비교한다. 위 식은 논문의 설명이며, 배포된 코드가 제곱 L2를 그대로 계산하는 것은 아니다. 다만 두 경우 모두 비교 대상이 픽셀이 아니라 특징 표현이라는 핵심은 같다.
3. 마스킹: 작은 빈칸보다 의미 있는 영역을 예측하게 한다
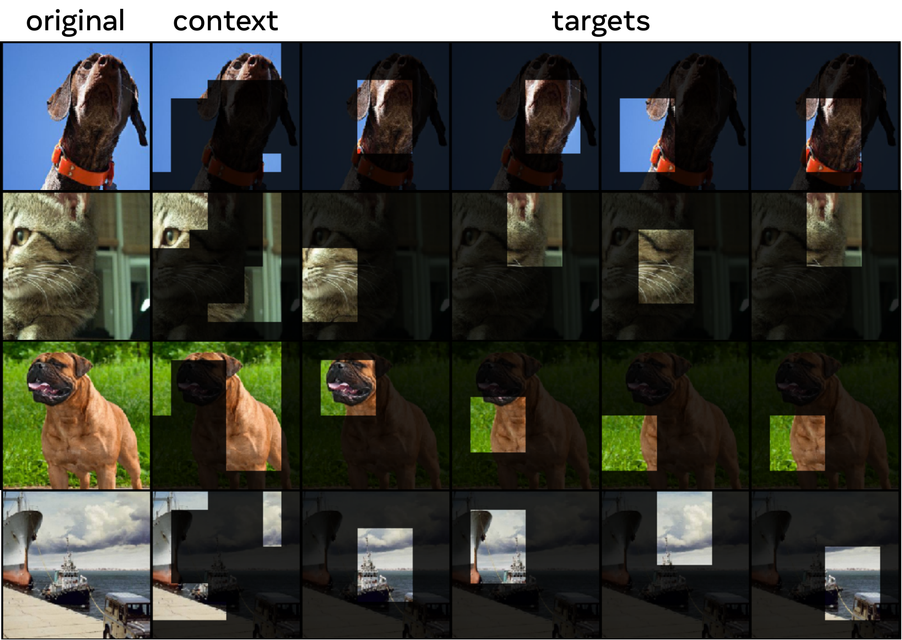
논문 Figure 4. 각 행에서 왼쪽은 원본, 두 번째는 컨텍스트, 나머지는 네 개의 타깃 위치다. 그림의 타깃 패널은 선택 영역을 시각화한 것이며, 실제 타깃 인코더에는 전체 이미지가 들어간다. 출처: Assran et al.
기본 설정에서는 타깃 블록을 4개 뽑는다. 각 블록의 면적 비율은 이미지의 15~20%, 종횡비 범위는 0.75~1.5다. 타깃끼리는 겹칠 수 있다.
컨텍스트는 먼저 이미지 면적의 85~100%에 해당하는 큰 블록을 뽑고, 타깃과 겹치는 부분을 제거한다. 따라서 “이미지의 85~100%를 실제로 본다”는 뜻이 아니다. 논문의 기본 마스킹 비교 실험에서는 최종 컨텍스트가 평균적으로 전체 패치의 약 25%였다.
이 설계는 두 조건을 함께 맞추려는 것이다.
- 타깃은 충분히 커야 한다. 작은 빈칸의 질감을 보간하는 수준을 넘어, 물체 부분과 장면 구조에 관한 단서가 필요하도록 만든다.
- 컨텍스트는 넓게 분포해야 한다. 보이는 패치가 적더라도 이미지의 여러 위치에 단서가 남아야 가린 부분의 특징을 추론할 수 있다.
그렇다고 타깃을 무조건 키우면 좋아지지는 않는다. 부록 Table 8에서는 타깃 면적을 더 키운 설정의 성능이 다시 낮아진다. 타깃의 의미 있는 크기와 남겨 둔 정보량 사이의 균형이 중요하다.
마스킹을 바꾸면 실제로 달라지는가?
아래는 ViT-B/16을 300 epoch 사전학습한 뒤, 인코더를 고정하고 ImageNet-1K 라벨 1%로 선형 분류기를 학습한 결과다.
| 마스킹 | 예측 문제 | 평균 컨텍스트 비율 | Top-1 정확도(%) |
|---|---|---|---|
| Multi-block | 여러 블록을 넓게 남은 단서로 예측 | 25% | 54.2 |
| Rasterized | 네 사분면 중 하나로 나머지 셋을 예측 | 25% | 15.5 |
| Block | 하나의 큰 블록을 나머지 영역으로 예측 | 40% | 20.2 |
| Random | 흩어진 랜덤 패치를 나머지 영역으로 예측 | 40% | 17.6 |
출처: 본문 Table 6. 마스킹 방식에 따라 타깃 수·모양·컨텍스트 양이 함께 달라지는 비교다.
같은 표현 예측 틀에서도 결과가 크게 달라진다. 이 실험은 표현 공간에서 예측하기만 하면 자동으로 좋은 의미 특징이 생기는 것은 아니라는 것을 보여준다. 다만 여러 조건을 함께 바꾼 결과이므로 차이를 특정 요소 하나의 효과로만 해석하면 안 된다.
4. 실험: 인코더를 얼마나 고쳐야 쓸 수 있는가?
4.1. ImageNet: 선형 평가와 1% 라벨 평가를 구분한다
선형 평가(linear probing)는 사전학습한 인코더를 고정하고 그 위의 선형 분류기만 학습하는 방식이다. 복잡한 추가 학습 없이도 표현에서 클래스 정보를 얼마나 쉽게 꺼낼 수 있는지 살펴본다.
아래 모델들은 모두 ImageNet-1K로 자기지도 사전학습했다. ViT-H/14는 Huge 크기의 ViT와 14×14 픽셀 패치를 뜻한다.
| 방법 | 인코더·사전학습 해상도 | 사전학습 epoch | 전체 라벨 선형 평가(%) | 라벨 1% 평가(%) |
|---|---|---|---|---|
| MAE | ViT-H/14 · 224×224 | 1600 | 77.2 | 71.5 |
| I-JEPA | ViT-H/14 · 224×224 | 300 | 79.3 | 73.3 |
| I-JEPA | ViT-H/16 · 448×448 | 300 | 81.1 | 77.3 |
출처: 본문 Tables 1·2. 마지막 열은 방법별로 유리한 fine-tuning 또는 선형 평가 결과이며, I-JEPA의 ViT-L/H 모델은 부록 A.2의 fine-tuning 설정을 사용한다. 앞의 마스킹 비교 표는 라벨 1%를 쓰더라도 인코더를 고정한 별도 평가다.
같은 ViT-H/14에서 I-JEPA는 더 적은 사전학습 epoch로 MAE보다 높은 선형 평가 정확도를 얻었다. 이는 이 논문이 강조하는 바로 활용하기 좋은 표현의 근거다. 고해상도 설정에서는 더 좋아지지만, 입력 해상도와 패치 크기가 달라졌으므로 추가 비용 없는 향상으로 보면 안 된다.
뷰 증강을 사용하는 방법과의 차이도 줄였다. Table 1의 iBOT ViT-L/16은 81.0%이며, 고해상도 I-JEPA는 81.1%다. 하지만 모델 크기·입력 조건이 다르므로 0.1%p 차이만으로 방법 자체의 우열을 단정하기는 어렵다.
4.2. 의미 정보와 위치 관련 정보를 함께 남기는가?
I-JEPA는 이미지 분류뿐 아니라 물체 개수와 거리 관련 과제도 평가한다. 아래 결과는 인코더를 고정한 선형 전이 평가다.
| 방법 | 인코더 | iNaturalist18(%) | CLEVR Count(%) | CLEVR Dist(%) |
|---|---|---|---|---|
| MAE | ViT-H/14 | 32.9 | 90.5 | 72.4 |
| I-JEPA | ViT-H/14 | 47.6 | 86.7 | 72.4 |
| DINO | ViT-B/8 | 55.9 | 86.6 | 53.4 |
| iBOT | ViT-L/16 | 57.3 | 85.7 | 62.8 |
출처: 본문 Tables 3·4의 일부 열. iNaturalist18은 세밀한 생물 분류, CLEVR Count·Dist는 합성 장면의 물체 개수·거리 관련 벤치마크다. Dist 수치를 일반적인 픽셀별 깊이 맵의 오차 지표로 읽으면 안 된다.
I-JEPA는 iNaturalist18에서 MAE보다 높지만 DINO와 iBOT보다 낮다. 반대로 CLEVR Dist에서는 두 뷰 불변성 기반 방법보다 높고, MAE와는 같다. Count에서는 MAE가 가장 높다. 따라서 결과의 요지는 전 과제 최고 성능보다는 의미적 구분 능력을 높이면서 지역적 정보도 함께 활용할 수 있었다는 데 있다. 이 표 역시 인코더 크기와 패치 크기가 모두 같은 비교는 아니다.
4.3. 효율: 한 번의 계산이 항상 더 가벼운 것은 아니다
논문은 ImageNet-1K의 ViT-H/14 사전학습을 A100 GPU 16개로 72시간 미만에 수행했다고 보고한다. 공식 저장소의 해당 재현 설정은 A100 80GB 16개, 전체 배치 크기 2048이다.
절약은 주로 여러 증강 뷰를 반복 처리하지 않고, 적은 학습 반복으로 좋은 표현에 도달하는 데서 나온다. 컨텍스트 인코더는 보이는 패치만 처리하며, 타깃 인코더는 이미지 한 뷰에서 여러 타깃의 특징을 얻는다.
한편 §7에 따르면 MAE와 비교한 반복당 시간은 타깃 인코더 계산 때문에 약 7% 더 느렸다. 그럼에도 약 5배 적은 반복으로 수렴해 전체 사전학습 계산량을 줄였다는 설명이다. 전체 학습 비용의 절감과 한 번의 추론 속도 향상은 다른 주장이다.
5. 예측된 표현에는 무엇이 들어 있을까?
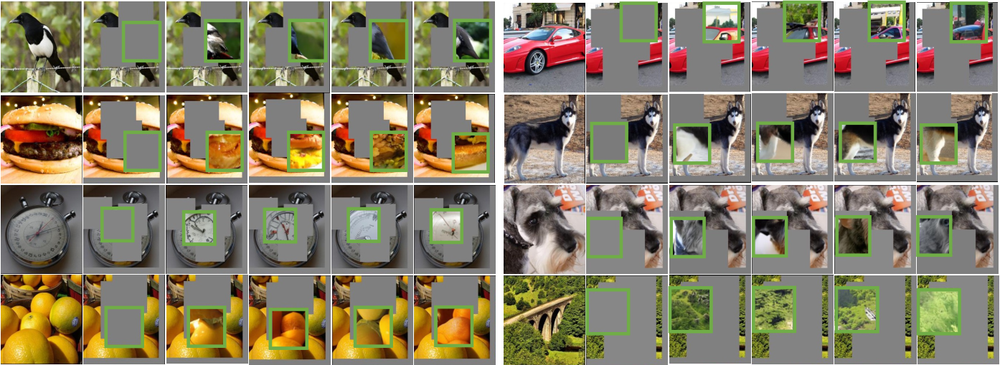
논문 Figure 6. 좌우 각 묶음은 원본, 컨텍스트, 그리고 예측 특징을 조건으로 생성한 여러 샘플 순서다. 초록색 상자 안이 타깃 영역이다. 출처: Assran et al.
그림은 I-JEPA가 직접 그린 복원 이미지가 아니다. 저자들은 사전학습한 인코더와 예측기를 고정하고, 예측 특징을 이미지로 바꾸는 별도의 RCDM 생성 디코더를 학습했다. 같은 예측 특징에 다른 난수를 넣어 나온 샘플들을 비교한 것이다.
새의 몸통이나 자동차의 윗부분처럼 여러 샘플에서 반복되는 구조는 예측 표현이 담은 정보의 단서가 된다. 반대로 질감·세부 색·배경이 달라지는 것은 그러한 세부사항이 표현에 강하게 고정되지 않았음을 시사한다. 이는 표현의 내용을 살펴보는 정성적 관찰이지, 원본을 정확히 복원했다는 평가가 아니다.
6. 공식 코드와 함께 읽을 때 확인할 점
공식 코드의 흐름은 논문의 큰 구조를 그대로 따른다. forward_target은 전체 이미지의 특징을 구한 뒤 타깃 위치를 선택하고, forward_context는 컨텍스트 특징을 예측기에 넘긴다. 타깃 계산에는 torch.no_grad()를 적용하고, 학습 스텝 뒤 EMA로 가중치를 갱신한다.
구현에서 특히 구분할 사항은 다음과 같다.
- “증강이 없다”의 범위: 공개 ViT-H/14 설정은 색 변형·블러·좌우 반전을 끄지만,
RandomResizedCrop과 정규화는 사용한다. 핵심은 강한 증강으로 여러 뷰를 만들고 표현 불변성을 강제하는 학습 목표에 의존하지 않는다는 것이다. - 예측기는 폭이 좁다: 같은 설정에서 인코더의 특징 차원은 1280, 예측기는 384이며 예측기의 깊이는 12층이다. 이미지를 다시 그릴 큰 디코더 대신 특징 예측용 네트워크를 둔다.
- 평가용 표현: 부록 A.1에 따르면 별도의
[CLS]토큰 없이 학습하고, 평가에는 타깃 인코더의 패치 출력을 평균 낸 표현을 사용한다. 예측기는 자기지도 사전학습을 위한 구성 요소다.
코드 세부사항은 공식 저장소의 고정 버전을 기준으로 확인했다. 특히 손실 함수처럼 논문의 개념 설명과 배포 구현이 다른 부분은 구분해서 읽는 편이 좋다.
7. 결론: 복원의 정답을 바꾸면 배우는 특징도 달라진다
I-JEPA의 핵심은 보이지 않는 내용을 예측하되, 정답을 픽셀이 아니라 학습 가능한 특징 표현으로 둔다는 것이다. 여기에 큰 타깃 블록과 충분한 공간적 단서를 남기는 마스킹을 결합해, 강한 뷰 증강에 의존하지 않고도 유용한 시각 표현을 얻었다.
성과의 범위는 구분해야 한다. 부록 Table 15의 전체 라벨 fine-tuning에서는 고해상도 I-JEPA가 87.1%, MAE가 87.8%였다. 두 모델의 패치 크기와 사전학습 기간도 다르다. 선형 평가에서의 강점이 모든 fine-tuning 성능의 우위로 이어지는 것은 아니다.
또한 이 연구가 직접 검증한 것은 정지 이미지 안의 영역 관계다. 시간에 따른 미래 예측이나 행동 계획 능력을 입증한 것은 아니다. 이 글에서 읽은 의의는, 막연히 ‘더 많은 정보를 복원하자’에서 벗어나 다음 과제에 유용한 표현을 배우려면 어떤 정보를 예측하게 해야 하는가를 구체적인 학습 설계와 실험으로 보여 줬다는 점이다.
답글 남기기