[태그:] Vision Transformer
-
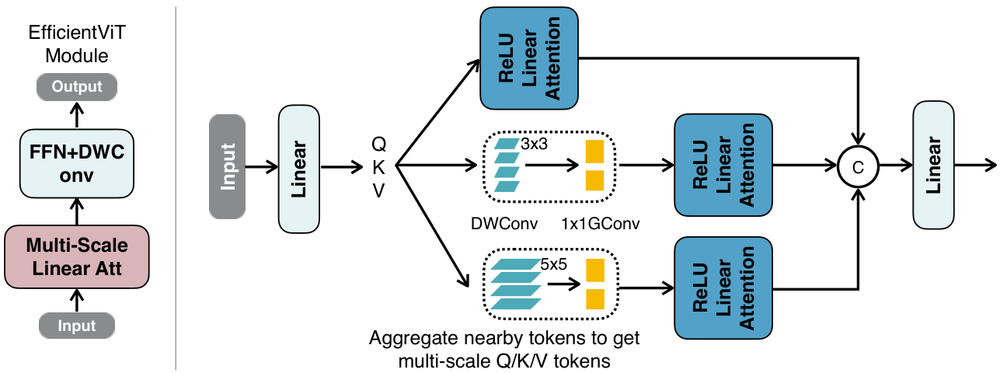
[논문정리] EfficientViT: 고해상도 예측을 위한 멀티스케일 선형 Attention
논문: EfficientViT: Multi-Scale Linear Attention for High-Resolution Dense Prediction 저자: Han Cai, Junyan Li, Muyan Hu, Chuang Gan, Song Han 발표: ICCV 2023. 이 글은 EfficientViT-SAM 결과가 추가된 arXiv v6(2024년 2월 6일)를 기준으로 정리한다. 논문 · 공식 코드 1. 연구 배경과 핵심 요약 이미지의 각 픽셀에 의미를 부여하는 밀집 예측(dense prediction)은 자율주행의 장면 분할이나 고해상도…
-
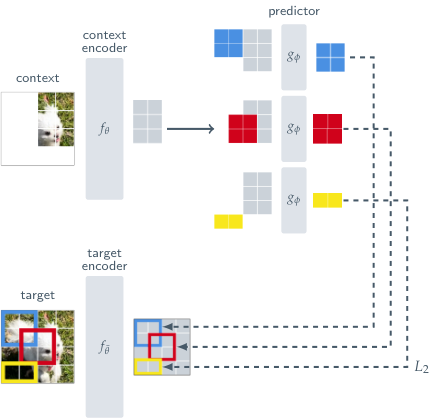
[논문 정리] I-JEPA: 픽셀 대신 의미 있는 표현을 예측하는 자기지도 학습
Self-Supervised Learning From Images With a Joint-Embedding Predictive Architecture Mahmoud Assran, Quentin Duval, Ishan Misra, Piotr Bojanowski, Pascal Vincent, Michael Rabbat, Yann LeCun, Nicolas Ballas · CVPR 2023 논문 · CVPR 공식 페이지 · 공식 코드 핵심 요약 이미지의 정답 라벨 없이 유용한 특징을 배우려면 어떤 문제를 풀게 해야 할까? 당시 자기지도 학습에서는 같은 사진을…
-
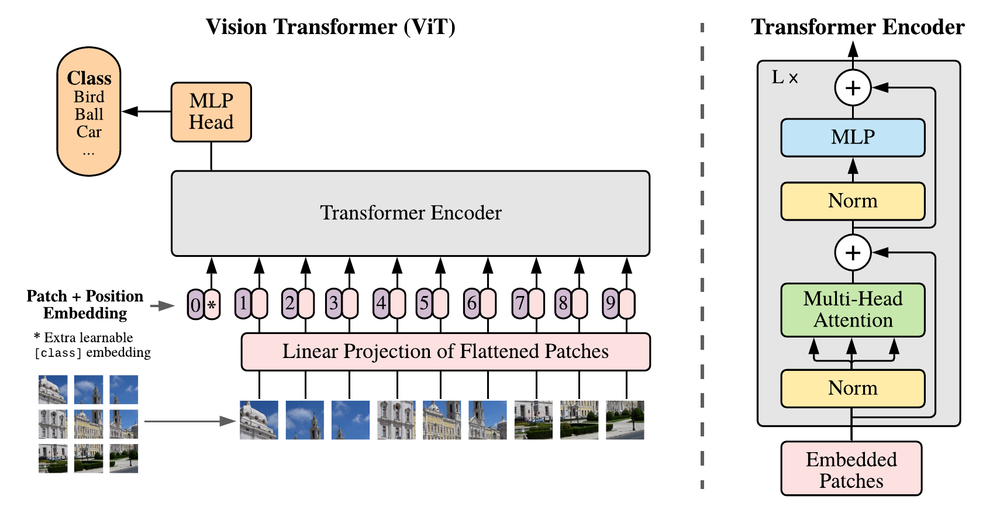
[논문 정리] Vision Transformer(ViT): 이미지를 패치 시퀀스로 읽는 Transformer
An Image is Worth 16×16 Words: Transformers for Image Recognition at Scale Alexey Dosovitskiy, Lucas Beyer, Alexander Kolesnikov 외 · Google Research, Brain Team · ICLR 2021 논문 · 원문 · 공식 구현·사전학습 모델 핵심 요약 이 논문이 처음 공개된 2020년에는 자연어 처리에서 Transformer의 대규모 사전학습이 확산된 반면, 이미지 인식에서는 CNN이 중심이었다. 비전에 attention을 적용하는…