논문: EfficientViT: Multi-Scale Linear Attention for High-Resolution Dense Prediction
저자: Han Cai, Junyan Li, Muyan Hu, Chuang Gan, Song Han
발표: ICCV 2023. 이 글은 EfficientViT-SAM 결과가 추가된 arXiv v6(2024년 2월 6일)를 기준으로 정리한다.
논문 · 공식 코드
1. 연구 배경과 핵심 요약
이미지의 각 픽셀에 의미를 부여하는 밀집 예측(dense prediction)은 자율주행의 장면 분할이나 고해상도 이미지 복원에 필요하다. 작은 물체와 경계를 구별하려면 해상도를 유지해야 하고, 무엇을 보고 있는지 판단하려면 이미지 전체의 문맥도 알아야 한다. 문제는 두 요구를 함께 만족시키는 모델이 무겁다는 것이다. Softmax Attention은 멀리 떨어진 위치를 연결하지만 토큰 수에 따라 비용이 빠르게 커진다. 큰 합성곱 커널도 넓은 범위를 볼 수 있지만, 연산량이 줄었다고 실제 장치에서 반드시 빨라지는 것은 아니다.
EfficientViT는 이 문제를 전역 문맥과 여러 크기의 특징을, 하드웨어가 잘 처리하는 연산으로 함께 얻는 방법으로 접근한다.
- ReLU 선형 Attention: 전체 위치를 연결하되 토큰 간 관계 행렬을 직접 만들지 않아 고해상도 처리 비용을 줄인다.
- 멀티스케일 토큰과 지역 연산: 작은 합성곱으로 주변 정보를 모아 선형 Attention의 약한 지역 표현력을 보완한다.
- 실제 장치 중심의 설계: 행렬 곱·작은 depthwise convolution·그룹 합성곱을 조합해 계산량 감소가 추론 속도로 이어지도록 한다.
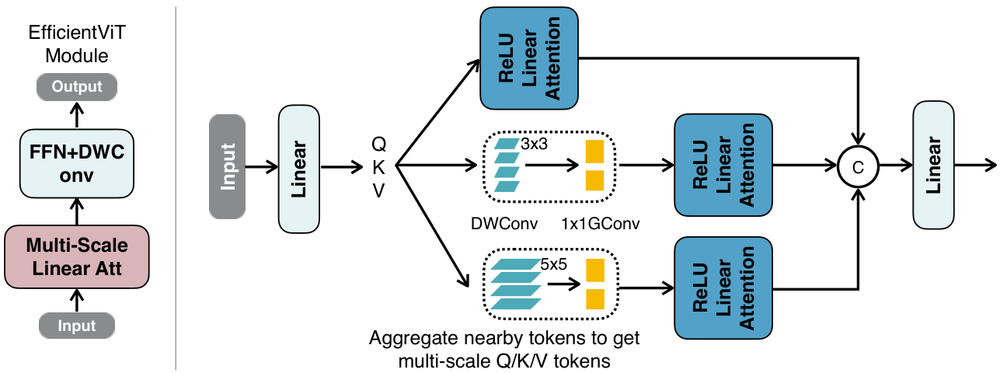
그림 1. 왼쪽은 전역 문맥을 처리하는 Attention과 지역 정보를 처리하는 FFN의 결합, 오른쪽은 멀티스케일 Q/K/V 생성 과정이다. 그림은 여러 커널의 확장을 예시하며, 논문의 실제 실험은 원본 분기와 5×5 집계 분기를 사용하는 두 분기 구성이다. 출처: Cai 외, 논문 Figure 2, CC BY 4.0. 표시 크기만 비율에 맞게 축소했다.
2. 핵심 방법: 전체를 보되, 모든 쌍을 직접 계산하지 않는다
2.1. Softmax 대신 ReLU 선형 Attention
일반적인 Self-Attention에서 Q는 각 위치가 찾는 정보, K는 비교를 위한 특징, V는 전달할 정보를 나타낸다. 토큰 수를 , 헤드 차원을 라고 하면 다음과 같이 계산한다.
O=\operatorname{softmax}\!\left(\frac{QK^{\mathsf T}}{\sqrt d}\right)V여기서 는 모든 토큰 쌍의 관계를 담는 행렬이다. 채널 차원이 고정되어 있어도 토큰 수에 대한 비용은 이차적으로 증가한다.
EfficientViT는 유사도 함수를 로 바꾸며, 를 사용한다. 논문 식 (2)와 (3)을 한 헤드 기준으로 정리하면 다음과 같다.
S=\sum_{j=1}^{N}\phi(k_j)^{\mathsf T}v_j,
\qquad z=\sum_{j=1}^{N}\phi(k_j)^{\mathsf T},
\qquad o_i=\frac{\phi(q_i)S}{\phi(q_i)z}
행 벡터 표기에서 S는 크기의 전역 정보 요약이고, z는 정규화에 쓰이는 열 벡터다. 각 위치가 모든 위치와 개별적으로 관계를 계산하는 대신, K와 V를 먼저 모은 요약을 모든 Q가 재사용한다. 행렬 곱의 결합법칙을 이용해 계산 순서를 바꾸므로, 헤드 차원이 고정되어 있을 때 토큰 수에 대한 계산 비용은 선형이 된다. 위 식은 논문의 수학적 표현이며 구현의 수치 안정화 항은 생략했다.
중요한 구분이 있다. ReLU 유사도를 선택한 뒤 계산 순서를 바꾸는 것은 동등한 변형이지만, Softmax Attention을 ReLU Attention으로 바꾸는 것 자체가 같은 출력을 보장하지는 않는다. 효율을 얻는 대신 표현 방식도 달라지는 설계다.
2.2. 선형 Attention의 약점을 합성곱으로 보완한다
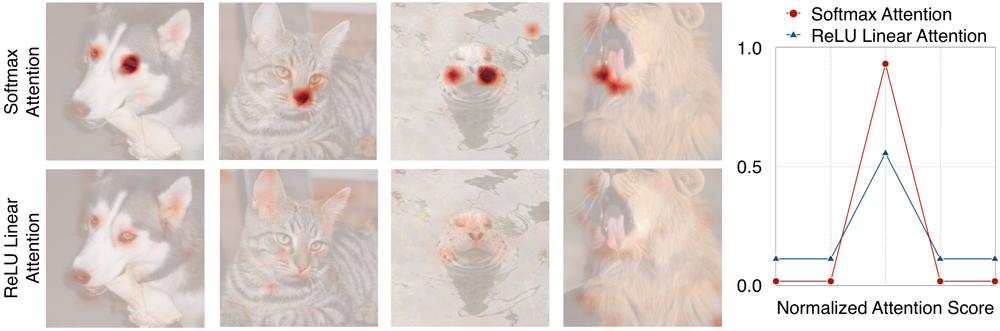
그림 2. 논문이 제시한 Attention 분포 비교. ReLU 선형 Attention은 Softmax처럼 날카롭게 집중된 분포를 만드는 능력이 약하다. 모든 입력에서 반드시 같은 모양이 된다는 의미는 아니다. 출처: Cai 외, 논문 Figure 3, CC BY 4.0. 비율 유지 축소.
전역 정보를 효율적으로 모으더라도, 분할 경계나 작은 물체처럼 가까운 위치의 세밀한 차이는 놓칠 수 있다. EfficientViT는 이를 두 경로로 보완한다.
첫째, Q/K/V 주변 토큰을 작은 커널로 집계한다. 원래 토큰을 사용하는 분기와 주변 정보를 모은 분기에서 각각 선형 Attention을 수행하고 출력을 결합한다. 각 분기가 서로 다른 범위의 정보를 바탕으로 전체 이미지를 보므로, 전역 연결과 멀티스케일 학습을 동시에 얻는다. 단순히 이미지를 여러 해상도로 바꾸어 넣는 방식과는 다르다.
둘째, FFN에 depthwise convolution을 추가한다. FFN은 토큰 특징을 변환하는 층이고, depthwise convolution은 각 채널에서 공간적으로 이웃한 정보를 처리하는 연산이다. Attention이 전역 문맥을 담당하고 FFN의 합성곱이 지역 정보를 보완하도록 역할을 나눈다.
작은 연산을 지나치게 잘게 실행하면 GPU에서도 비효율적일 수 있다. 논문은 Q/K/V와 헤드별 집계 연산을 depthwise convolution과 1×1 그룹 합성곱으로 묶어 실행하는 점도 강조한다. 구조의 아이디어뿐 아니라 실행 방식까지 효율을 고려한 것이다.
2.3. 전체 모델: 계층형 백본과 단순한 예측 헤드
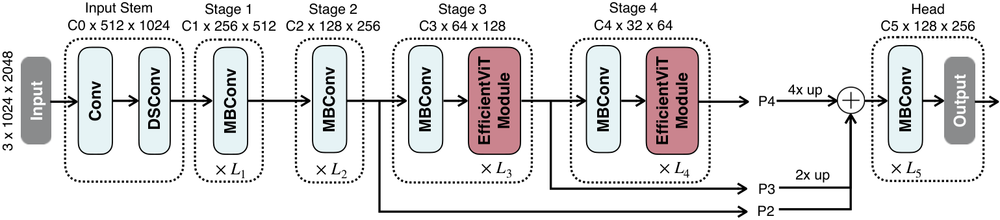
그림 3. 단계가 진행될수록 공간 크기는 줄고 채널은 늘어난다. Stage 3·4에 EfficientViT 모듈을 배치하고, 마지막 세 단계의 특징을 예측 헤드로 전달한다. 출처: Cai 외, 논문 Figure 5, CC BY 4.0. 비율 유지 축소.
백본은 입력 stem과 네 단계로 구성되며, 다운샘플링에는 stride 2의 MBConv를 사용한다. 밀집 예측 헤드는 P2·P3·P4의 공간 크기와 채널 수를 맞춘 뒤 덧셈으로 융합한다. 전역 문맥 추출은 백본이 맡으므로, 헤드는 여러 MBConv와 출력층으로 비교적 단순하게 구성한다. 처음부터 끝까지 모든 층을 Attention으로 바꾸는 모델은 아니다.
3. 실험: 정확도와 실제 지연시간을 함께 본다
아래 수치는 모두 논문 저자가 보고한 결과이며 별도로 모델을 실행해 재현한 값은 아니다. GPU 측정은 TensorRT·FP16을 사용하고 데이터 전송 시간을 포함한다. 단일 이미지 지연시간과 초당 이미지 처리량은 서로 다른 지표이므로 구분해야 한다.
3.1. 고해상도 의미 분할
Cityscapes에서 입력은 모든 모델이 1024×2048이다. mIoU는 예측 영역과 정답 영역의 겹침을 클래스별로 평균한 분할 지표이며 높을수록 좋다. 아래는 논문 Table 3의 일부다. Orin 지연시간은 Jetson AGX Orin, 배치 크기 1에서 측정했다.
| 모델 | mIoU ↑ | 파라미터 | MACs | Orin 지연시간 ↓ |
|---|---|---|---|---|
| SegFormer-B1 | 78.5 | 14M | 244G | 146ms |
| SegNeXt-T | 79.8 | 4.3M | 51G | 93.2ms |
| EfficientViT-B1 | 80.5 | 4.8M | 25G | 24.3ms |
EfficientViT-B1은 이 비교에서 정확도가 더 높으면서 지연시간은 더 짧다. 다만 파라미터 수는 SegNeXt-T보다 많다. 모델 크기·연산량·속도가 하나의 척도로 정렬되는 것은 아니다. ADE20K에서도 EfficientViT-B1은 42.8 mIoU·4.0ms, SegFormer-B1은 42.2 mIoU·12.3ms를 보고한다. 이때는 짧은 변을 512로 맞춘 별도 평가이므로 Cityscapes 지연시간과 직접 비교하면 안 된다.
초록의 “최대 13.9배·6.2배”는 위 B1 비교에 공통으로 적용되는 값이 아니다. 모델 규모와 비교 쌍에 따라 달라진다. 또한 v6 본문의 분할 결과 설명에는 일부 최대 배율이 표의 확장된 모델 목록과 일치하지 않는 부분이 있어, 여기서는 해당 표의 모델별 원시 수치를 기준으로 읽는다.
3.2. 두 구성 요소가 모두 필요한가
논문 Table 1은 Cityscapes에서 사전학습 없이 처음부터 학습하고, 모델 폭을 조정해 연산량을 4.4G MACs로 맞춘 구성 요소 제거 실험이다.
| 멀티스케일 학습 | 전역 Attention | mIoU ↑ |
|---|---|---|
| 없음 | 없음 | 68.1 |
| 사용 | 없음 | 72.3 |
| 없음 | 사용 | 72.2 |
| 사용 | 사용 | 74.5 |
전역 연결이나 멀티스케일 집계 중 하나만 있어도 개선되지만 둘을 함께 쓸 때 가장 높다. 따라서 이 논문의 핵심은 단순히 “Softmax를 제거하면 된다”가 아니라, 선형 Attention에 부족한 공간 표현을 맞는 방식으로 보완해야 한다는 데 있다. 이 실험은 사전학습 백본을 쓰는 앞의 모델 간 비교와 학습 조건이 다르다.
3.3. 초해상도와 Segment Anything으로의 확장
초해상도는 저해상도 영상으로부터 더 큰 영상을 복원하는 작업이다. 논문 Table 5의 FFHQ 평가에서는 512×512를 1024×1024로 복원한다. A100·배치 1에서 Restormer는 43.43dB PSNR·92.0ms, EfficientViT w0.75는 43.54dB·14.3ms로 보고된다. 논문은 이를 약 6.4배 가속과 0.11dB 향상으로 요약한다. 다만 BSD100에서는 이 모델의 SSIM이 Restormer보다 낮으므로 모든 복원 품질 지표에서 우월하다고 일반화할 수는 없다.
EfficientViT-SAM은 SAM의 이미지 인코더를 EfficientViT로 교체하고, 가벼운 프롬프트 인코더와 마스크 디코더는 유지한다. 먼저 SAM 이미지 인코더를 교사로 학습한 뒤, SA-1B 전체 데이터로 end-to-end 학습한다. 단순한 추론 시점의 인코더 교체는 아니다.
아래는 ViTDet의 예측 박스를 프롬프트로 사용하는 zero-shot 인스턴스 분할 결과다. 처리량은 A100·TensorRT·FP16에서 이미지 인코더와 SAM 헤드를 포함한 값이다. 논문 Table 6에서 발췌했다.
| 모델 | A100 처리량(장/초) ↑ | COCO mAP ↑ | LVIS mAP ↑ |
|---|---|---|---|
| SAM-ViT-H | 11 | 46.5 | 44.2 |
| EfficientViT-SAM-L2 | 538 | 46.6 | 42.7 |
| EfficientViT-SAM-XL1 | 182 | 47.8 | 44.4 |
초록의 약 48.9배 처리량은 L2의 결과에 해당한다. COCO에서는 성능을 유지하지만 LVIS에서는 낮아진다. XL1은 두 데이터셋의 전체 mAP가 더 높지만 처리량 향상 폭은 약 16.5배다. “48.9배 빠르고 모든 데이터셋에서 더 정확하다”라고 합쳐 읽으면 안 된다.
4. 한계와 읽고 남는 점
- 선형이라는 표현의 조건: 토큰 수에 대해 선형이라는 뜻이다. 채널·헤드 차원의 비용까지 사라지거나 입력 크기와 무관하게 빨라진다는 의미는 아니다.
- 하드웨어와 실행 환경 의존성: TensorRT·FP16에서의 이득을 다른 프레임워크나 CPU에 그대로 대입할 수 없다. 특히 단일 이미지 지연시간과 배치 처리량을 구별해야 한다.
- 프롬프트 설정에 따른 성능 차이: 논문 Table 7에서 LVIS 단일 점 프롬프트 결과는 SAM-ViT-H가 59.2, EfficientViT-SAM-XL1이 56.6으로 기존 SAM이 더 높다. 저자들은 end-to-end 학습 중 상호작용 분할 설정을 사용하지 않은 점을 가능한 원인으로 든다.
이 논문은 Attention과 합성곱 중 하나를 선택하는 연구라기보다, 전역 문맥은 선형 Attention으로, 지역·멀티스케일 특징은 작은 합성곱으로 분담하는 연구로 읽는 편이 자연스럽다. 고해상도 모델을 경량화할 때 중요한 것은 FLOPs 하나가 아니라, 필요한 표현력을 어떤 연산으로 만들고 실제 장치에서 어떻게 실행하느냐다.
답글 남기기