[태그:] 3D Vision
-
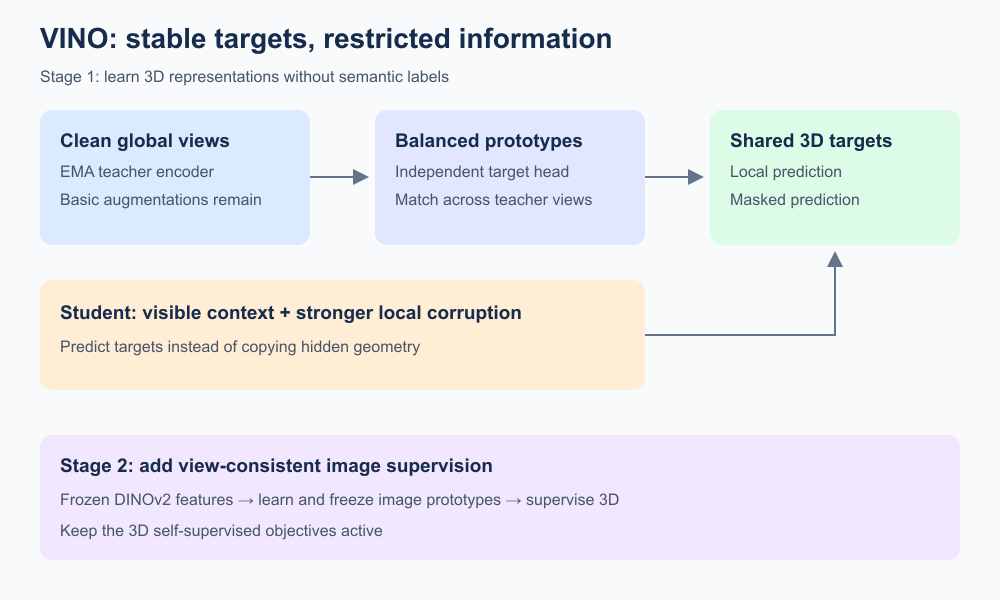
[논문정리] VINO: 3D 자기지도학습에서 정답과 마스킹을 다시 설계하다
논문: VINO: Revisiting 3D Representation Learning with Volume Transformers 저자: Adrian Kruse, Kadir Yilmaz, Daan de Geus, Francis Engelmann, Bastian Leibe 발표: 2026년 11월, arXiv 사전공개 논문 2611.07176v1 1. 배경과 핵심 요약 이미지에서는 DINO 계열처럼 정답 라벨 없이 학습한 표현을 고정하고 간단한 분류기만 붙여도 여러 작업에 활용할 수 있다. 하지만 3D 포인트 클라우드, 즉 공간에…