Enlightening Photographic Style Transfer with a Self-Supervised Photographic Embedding
Chengxuan Zhu, Jiacong Fang 외 · ECCV 2026
핵심 요약
- PETAL은 사진의 노출·대비·색조 같은 스타일을 표현하는 임베딩을 먼저 학습한다.
- 그 임베딩으로 가벼운 이미지 변환기를 조절해, 참조 사진의 분위기를 다른 사진에 옮긴다.
- 핵심은 두 부분이다. 어떤 분위기인지 읽는 모델과 그 분위기에 맞게 픽셀을 바꾸는 모델을 분리한다.
- 추론 때 입력 사진마다 모델을 다시 최적화할 필요가 없다. 다만 스타일 인코더까지 포함한 전체 시스템을 초경량 모델로 보아서는 안 된다.
1. Introduction: 사진에서 ‘무엇’과 ‘어떻게’는 다르다
1.1. 같은 장면도 다른 사진처럼 보이는 이유
- 한 풍경 사진을 밝고 따뜻하게 보정할 수도 있고, 어둡고 차갑게 보정할 수도 있다.
- 피사체와 구도는 같아도 노출·대비·채도·색조가 바뀌면 전달되는 인상이 달라진다.
- 여기서 다루는 Photographic Style Transfer는 참조 사진의 이런 보정 특성을 내용 사진에 옮기는 작업이다.
예를 들어 건물 사진의 차분한 색감을 해변 사진에 적용하더라도, 해변의 파도와 모래가 건물 형태로 바뀌기를 원하는 것은 아니다. 장면은 해변으로 남고, 표현 방식이 달라져야 한다.
1.2. 일반적인 이미지 임베딩으로 충분할까?
- 이미지 임베딩은 이미지를 비교하기 쉬운 벡터로 바꾼 표현이다.
- CLIP이나 DINO 계열의 표현은 객체·장면 등 의미적 내용을 다루는 데 유용하다.
- 하지만 ‘같은 장면인가’와 ‘같은 색감인가’는 다른 질문이다.
- PETAL은 일반 표현을 그대로 쓰는 대신, 사진 스타일의 차이에 민감한 표현을 학습한다.
공식 프로젝트는 같은 장면을 여러 보정 방향으로 편집한 FiveK-Concept 시각화로 이 차이를 설명한다. 스타일 표현이라면 서로 다른 장면이라도 같은 보정을 받은 사진끼리 가까워져야 한다는 것이다. 이것은 해당 평가에서의 관찰이며, 기존 모델이 모든 스타일 정보를 표현하지 못한다는 뜻은 아니다.
1.3. 왜 연속적인 표현이 필요한가?
- 밝기와 색온도는 몇 개의 이름으로만 나누기 어렵다.
- ‘따뜻한 사진’ 안에서도 어느 정도 따뜻한지, 밝은 부분과 어두운 부분의 톤이 어떤지가 달라진다.
- PETAL은 이러한 차이를 연속적인 임베딩으로 표현하고, 이를 실제 사진 변환의 조건으로 사용한다.
2. Overview: 스타일을 읽은 뒤 전이한다
PETAL은 Photographic Embedding for Transfer with an Adaptive LUT의 약자다.
내용 사진 Ic ──→ 스타일 인코더 M ──→ 내용 임베딩 mc ─┐
                                                     ├─→ 변환 조건
참조 사진 Is ──→ 스타일 인코더 M ──→ 참조 임베딩 ms ─┘

내용 사진의 Lab 색 + 위치 좌표 ──→ 변환기 ──→ 결과 사진
- Photographic Embedding 학습: 밝기·색·톤을 구분할 수 있는 표현을 자기지도 방식으로 학습한다.
- 조건부 스타일 전이: 학습한 인코더를 고정하고, 내용 사진과 참조 사진의 표현으로 변환기를 조절한다.
‘스타일을 얼마나 잘 구분하는가’와 ‘이미지를 얼마나 잘 바꾸는가’를 나누어 볼 수 있는 구조다.
3. Photographic Embedding: 사진의 색과 톤을 어떻게 읽는가?
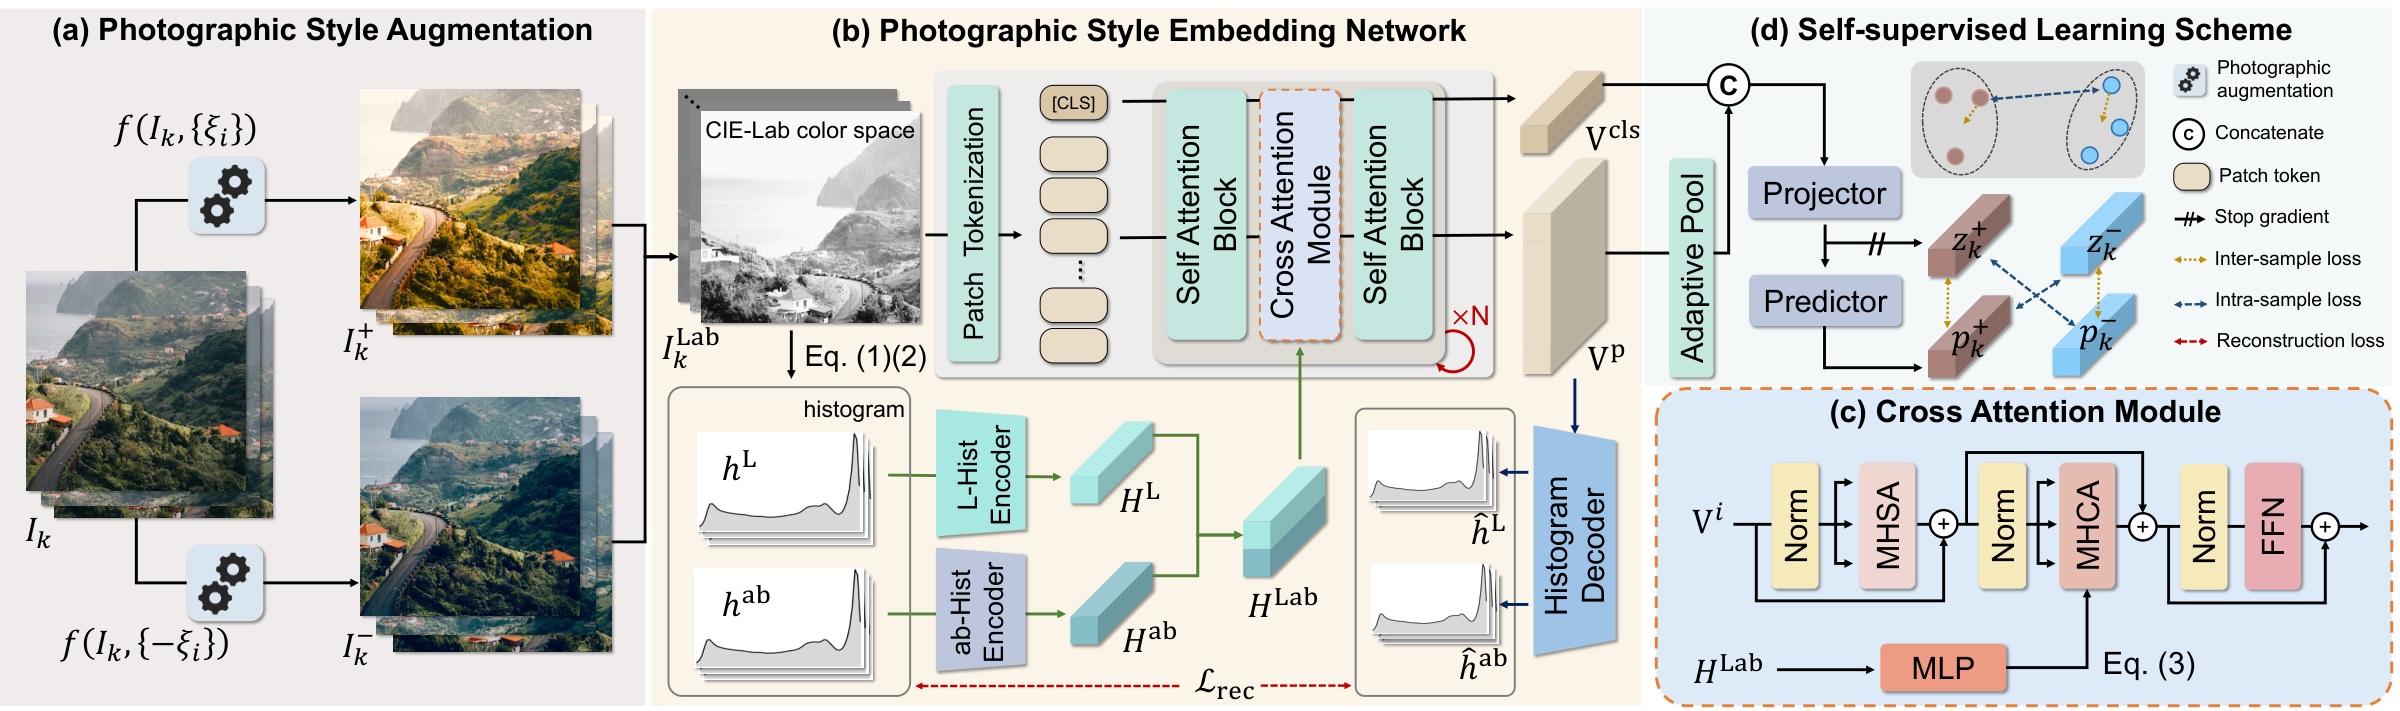
그림 1. 공식 프로젝트의 임베딩 학습 파이프라인. 왼쪽은 서로 반대 방향의 사진 보정, 가운데는 Lab 이미지와 히스토그램을 결합하는 인코더, 오른쪽은 자기지도 학습의 연결 관계다. 출처: PETAL 프로젝트.
3.1. RGB 대신 CIE-Lab을 사용하는 이유
- L*: 지각적 밝기를 나타내는 축.
- a*: 녹색과 적색 방향의 색 성분.
- b*: 청색과 황색 방향의 색 성분.
RGB에서 색과 밝기는 여러 채널에 함께 나타난다. Lab은 밝기 축과 색 성분 축을 구분해 다루기 편하므로, 사진의 톤과 색 분포를 명시적으로 제공하려는 설계에 잘 맞는다.
PETAL은 이미지 패치뿐 아니라 두 가지 통계를 사용한다.
| 입력 | 표현하는 정보 | 역할 |
|---|---|---|
| ViT의 이미지 토큰 | 패치와 장면의 시각적 특징 | 이미지의 구조와 맥락 제공 |
| L 히스토그램 | 밝기값의 분포 | 어두운 영역·밝은 영역이 차지하는 비중 제공 |
| ab 히스토그램 | 두 색 성분의 결합 분포 | 전체적인 색 분포 제공 |
히스토그램만으로는 색이 어디에 있는지 알기 어렵다. 반대로 이미지 토큰만 사용하면 원하는 보정 차이가 표현에서 충분히 강조되지 않을 수 있다. 두 정보를 결합하는 것이 설계의 요점이다.
3.2. 히스토그램을 Cross-Attention으로 결합한다
공개 코드의 HistogramEncoder와 DinoVisionTransformer에서 확인되는 흐름은 다음과 같다.
- L 히스토그램과 ab 히스토그램을 각각 CNN으로 인코딩한다.
- 두 결과를 히스토그램 토큰으로 만든다.
- ViT의 일부 블록에서 이미지 토큰이 히스토그램 토큰을 참조하도록 cross-attention을 적용한다.
- 마지막
[CLS]토큰과 패치 토큰의 attention pooling 결과를 연결한다. - Projector를 거쳐 사진 임베딩을 얻는다.
추론 코드의 공개 설정은 ViT-L/16, 인코더 입력 512×512, 출력 임베딩 1024차원이다. 이는 공개 추론 설정에서 확인한 값이며, 전체 학습 조건을 뜻하지는 않는다.
3.3. 스타일 차이는 어떻게 학습시키는가?
- 프로젝트는 겹치는 지역 뷰를 positive 관계로 활용한다고 설명한다.
- Photographic Style Augmentation(PSA)는 같은 패치에 반대 방향의 미분 가능한 사진 보정을 적용해 hard negative를 만든다.
- 같은 장면을 서로 다른 스타일로 만들어, 내용이 같다는 이유만으로 표현이 같아지는 것을 피하려는 접근이다.
- 학습에는 intra-sample·inter-sample 손실, stop-gradient와 히스토그램 복원 항을 사용한다.
용어를 풀어보면, positive는 가깝게 표현하려는 예시 쌍이고 hard negative는 구분하기 어려운 반대 예시다. Intra-sample과 inter-sample은 각각 한 샘플 안의 관계와 샘플 사이의 관계를 다룬다. Stop-gradient는 특정 분기를 통해 학습 기울기가 흐르지 않게 하는 연산이다.
설명을 위한 예시: 같은 풍경을 따뜻한 방향과 차가운 방향으로 보정하면 객체는 같아도 스타일은 다르다. 이런 차이를 학습 신호로 활용한다는 뜻이다. 실제 보정 연산의 전체 목록과 범위는 논문 본문에서 추가 확인이 필요하다.
파이프라인 그림에는 히스토그램을 다시 예측하는 decoder도 있다. 입력의 밝기·색 분포를 복원하도록 함으로써 표현에 관련 정보가 남도록 하는 역할로 이해할 수 있다. 정확한 손실식과 가중치는 공개 설명만으로 확정하지 않는다.
4. Adaptive Neural LUT: 읽은 스타일을 이미지에 적용한다
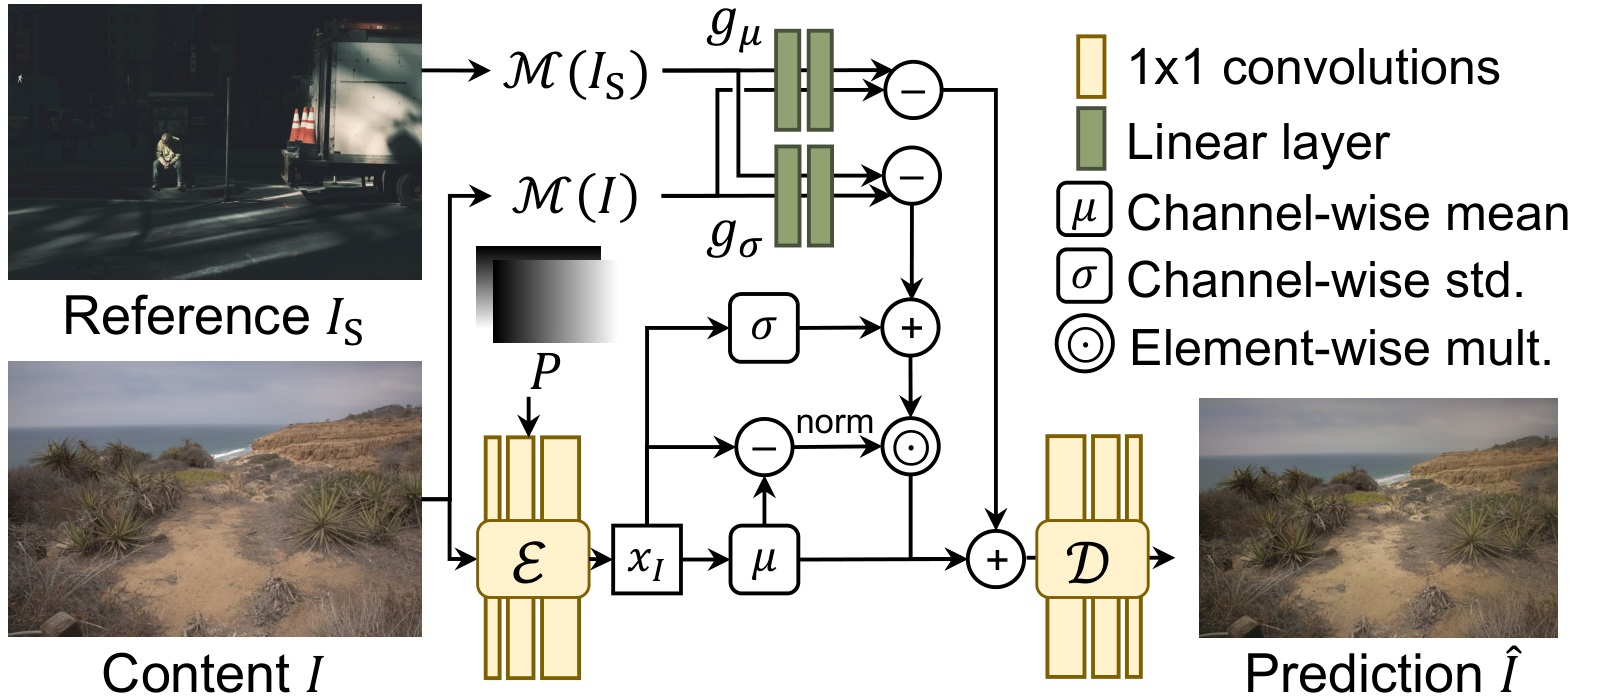
그림 2. 공식 프로젝트의 스타일 전이 구조. 두 사진의 임베딩을 평균·표준편차 조절 분기로 보내고, 그 차이를 내용 특징에 적용한다. 범례의 평균과 표준편차는 채널별 통계다. 출처: PETAL 프로젝트.
4.1. 5D Neural LUT란?
- 일반적인 색상 LUT는 입력 색을 출력 색으로 대응시키는 표로 이해할 수 있다.
- PETAL의 변환기는 Lab 색상 3개 값에 위치 좌표 2개를 더한 5채널 입력을 받는다.
- 위치를 포함하므로 같은 색이라도 이미지 내 위치에 따라 다른 변환을 표현할 수 있다.
- 공개 구현은 거대한 5차원 배열을 조회하는 코드가 아니라, 1×1 convolution으로 구성한 신경망이다.
공식 페이지가 이를 5D neural LUT라고 부르는 이유는 색과 위치를 입력으로 받는 변환 구조에 있다. 다만 코드에는 GroupNorm과 이미지 전체의 특징 통계도 있으므로, 고정된 표처럼 각 픽셀이 다른 위치의 정보와 완전히 독립적으로 처리된다고 해석하면 정확하지 않다.
4.2. 참조 스타일과 내용 스타일의 ‘변화량’을 사용한다
아래는 공개 구현의 LUT.forward를 설명용으로 정리한 식이다. 기본 guidance_scale=1을 기준으로 한다.
- I_s: 스타일을 가져올 참조 사진.
- I_c: 내용과 구도를 유지할 입력 사진.
- m_s,m_c: 전이에 사용하는 정규화된 사진 임베딩.
- P: 정규화된 두 위치 좌표.
- x_c: 내용 사진을 변환기에 넣어 얻은 특징.
공간 방향으로 계산한 x_c의 채널별 평균과 표준편차를 \mu_c,\sigma_c라고 하면, 조절할 통계는 다음과 같다.
- g_\mu,g_\sigma: 임베딩을 특징 통계의 조절값으로 변환하는 두 MLP.
- \odot: 원소별 곱. 채널별 조절값을 각 공간 위치에 적용한다.
- \mathcal{D}: 조절한 특징을 Lab 이미지로 되돌리는 decoder.
- 실제 추론에서는 출력 범위를 제한하고 RGB로 변환하는 후처리가 이어진다.
중요한 점은 두 임베딩을 각각 MLP에 통과시킨 뒤 뺀다는 것이다. 비선형 함수에서는 g(m_s)-g(m_c)와 g(m_s-m_c)가 같지 않다.
직관적으로는 입력 사진의 특징을 정규화한 다음, 참조와 입력의 스타일 차이만큼 통계를 옮기는 방식이다. AdaIN과 닮았지만 참조 특징의 통계로 단순 교체하는 것과는 구별된다.
4.3. 이미 스타일이 같다면?
- m_s=m_c라면 두 MLP 분기의 차이가 0이 된다.
- 따라서 통계 조절은 상쇄되고, 일반적인 수치 범위에서 decoder 앞의 특징은 원래 특징에 가까워진다.
- 하지만 결과는 여전히 \mathcal{D}(\mathcal{E}(I_c))를 통과한다. 입력 픽셀과 출력 픽셀이 항상 완전히 같다는 수학적 보장은 아니다.
공식 페이지는 같은 스타일을 반복 적용할 때 변화가 작다는 예시를 제시한다. 이를 ‘같은 스타일이면 큰 추가 변화가 생기지 않도록 설계했다’고 이해하는 편이 적절하다.
4.4. 구조와 질감을 보존하려는 설계
- 1×1 convolution은 인접 픽셀을 직접 섞는 공간 커널을 사용하지 않는다.
- 따라서 이웃의 내용을 섞어 질감을 재구성하는 방식과 다른 특성을 갖는다.
- 다만 색·대비 변환 자체가 질감의 지각에 영향을 줄 수 있으므로 ‘모든 조건에서 질감이 완전히 불변’이라고 단정할 수는 없다.
5. Experiments: 공개 결과에서 무엇을 확인할 수 있나?
아래는 연구진이 공개한 실험 결과를 정리한 것이다.
5.1. 사진 스타일 검색
검색 평가는 비슷한 내용이 아니라 비슷한 스타일의 사진을 찾는 능력을 본다. 아래는 여러 지표 중 R@1을 발췌한 것이다.
| 방법 | PPR10K R@1 ↑ | FiveK R@1 ↑ | InsRank R@1 ↑ |
|---|---|---|---|
| CLIP | 0.08 | 0.89 | 34.38 |
| DINOv3 | 1.48 | 0.02 | 43.75 |
| ALADIN | 32.44 | 27.67 | 46.88 |
| ColorD | 65.80 | 45.45 | 46.88 |
| DINOv3∗ | 59.30 | 34.72 | 34.38 |
| CLIP∗ | 54.42 | 34.66 | 50.00 |
| PETAL | 74.27 | 52.94 | 62.50 |
단위: %. ∗는 저자들의 데이터와 목적함수로 미세 조정한 비교 모델이다. 출처: 프로젝트 Table 1 데이터.
- R@1은 최상위 검색 결과가 평가 기준의 정답에 해당하는지를 보는 지표다. 정확한 정답 정의와 검색 후보 구성은 논문 본문 대조가 필요하다.
- PETAL은 이 표에서 세 데이터셋 모두 가장 높은 R@1을 기록한다.
- PPR10K에서는 미세 조정한 DINOv3보다 14.97퍼센트포인트 높다.
- 다만 이 차이만으로 특정 구성 요소 하나의 기여를 분리해 증명할 수는 없다. Lab·히스토그램·학습 구성의 개별 효과는 전체 ablation을 확인해야 한다.
5.2. 스타일 전이 품질
| 방법 | PPR LPIPS ↓ | PPR PSNR ↑ | PPR SSIM ↑ | PST50 LPIPS ↓ | PST50 PSNR ↑ | PST50 SSIM ↑ |
|---|---|---|---|---|---|---|
| SALUT | 0.2464 | 16.47 | 0.6307 | 0.1557 | 21.93 | 0.8733 |
| Deep Preset | 0.1717 | 20.88 | 0.8137 | 0.1365 | 23.40 | 0.8895 |
| Neural Preset | 0.1377 | 19.12 | 0.8048 | 0.1210 | 22.61 | 0.8975 |
| Pixelmator Pro | 0.1207 | 19.43 | 0.8825 | 0.1526 | 21.60 | 0.8684 |
| PETAL | 0.1027 | 21.80 | 0.8710 | 0.1021 | 24.63 | 0.9272 |
출처: 프로젝트 Table 2 중 일부 방법과 지표를 발췌. PPR은 PPR10K. PSNR의 단위는 dB.
- LPIPS: 학습된 특징으로 측정하는 지각적 차이. 낮을수록 좋다.
- PSNR: 정답 영상과의 픽셀 오차를 바탕으로 한 신호 대 잡음비. 높을수록 좋다.
- SSIM: 밝기·대비·구조를 고려한 유사도. 높을수록 좋다.
PETAL은 좋은 결과를 보이지만 모든 지표에서 최고는 아니다. PPR10K의 SSIM은 Pixelmator Pro가 더 높으며, 원래 표의 히스토그램 상관도에서도 PETAL보다 높은 방법이 있다. 하나의 지표가 모든 종류의 시각적 품질을 대표하지 않는다는 점을 함께 봐야 한다.
평가 결과 차이: 공식 코드 저장소의 PST50 결과는 LPIPS 0.0978, PSNR 24.64, SSIM 0.9332, RGB H-Corr 0.5221로 프로젝트 비교표와 다르다. 저장소에서는 공개된 paired prediction의 평가값으로 설명한다. 차이의 원인이 명확하지 않아 위 비교에서는 프로젝트 비교표의 값으로 통일했다.
5.3. 사용자 평가와 속도
공식 프로젝트는 34명의 참여자가 다음 세 항목을 1~5점으로 평가했다고 설명한다.
| 방법 | 내용 보존 ↑ | 스타일 일치 ↑ | 전체 시각 품질 ↑ |
|---|---|---|---|
| Deep Preset | 4.65 | 3.12 | 3.97 |
| Neural Preset | 4.32 | 4.15 | 4.35 |
| Nano Banana Pro | 3.74 | 4.31 | 4.47 |
| PETAL | 4.65 | 4.71 | 4.44 |
- PETAL의 스타일 일치 점수가 가장 높다.
- 내용 보존은 Deep Preset과 공동 최고다.
- 전체 시각 품질은 Nano Banana Pro가 조금 더 높다. 오차 범위나 유의성은 확보한 자료에서 확인하지 못했다.
- 실행 시간은 PETAL 0.2306초, Deep Preset 0.0329초로 보고된다. PETAL은 시간이 기재된 비교 방법 중 두 번째로 빠르다.
- 하드웨어·해상도·시간 측정 범위가 확인되지 않았으므로, 이 값을 그대로 특정 장치의 FPS나 실시간 처리 보장으로 바꾸지는 않는다.
6. 활용과 확인할 점
스타일 보간과 반복 편집
- 프로젝트는 두 참조 스타일 사이의 조건 임베딩을 보간하며 결과를 바꾸는 예시를 제공한다.
- 연속 표현을 사용하므로 두 스타일 사이를 조절할 수 있다는 활용 가능성이 있다.
- 같은 참조를 여러 번 적용해도 변화가 작다는 예시도 있다. 이는 저자들이 제공한 사례이며, 모든 이미지의 안정성을 독립 검증한 결과는 아니다.
공개 구현을 사용할 때
- 코드와 모델 가중치는 공개되어 있다.
- 내용 사진과 참조 사진을 파일명 기준으로 짝지어 추론하는 스크립트를 제공한다.
- 인코더는 축소된 이미지를 읽지만 전이기는 원본 해상도 내용 이미지를 받는다.
- 변환기 자체는 단순해도 스타일 인코더는 큰 ViT다. ‘LUT가 가볍다’는 말과 ‘전체 실행 비용이 작다’는 말은 구분해야 한다.
- 공식 코드 저장소에서는 학습 스크립트가 아직 공개 예정으로 표시되어 있다.
결과를 해석할 때 함께 볼 사항
- 자기지도 학습의 정확한 positive·negative 정의와 손실식·가중치.
- 전이기 학습 목표와 데이터 구성, 분할 방식.
- Lab·히스토그램·cross-attention·PSA 각각의 ablation.
- 검색 정답과 사용자 평가의 구체적인 프로토콜.
- 속도 측정 조건과 공개 평가 결과 사이의 수치 차이.
7. Conclusion
PETAL의 핵심은 사진 스타일을 잘 읽는 표현을 먼저 만들고, 그 표현의 차이로 이미지 변환을 조절한다는 데 있다.
- Lab 히스토그램과 ViT를 결합해 밝기·색 분포를 명시적으로 제공한다.
- 사진 보정의 차이를 자기지도 학습 신호로 활용한다.
- 스타일 임베딩에서 얻은 통계 조절값을 1×1 convolution 기반 전이기에 적용한다.
- 공식 공개 결과에서는 스타일 검색과 전이 품질에서 강점을 보이지만, 지표와 비교 조건에 따른 예외도 있다.
해석: 이 연구는 사진 스타일 전이의 어려움을 변환기 설계만의 문제로 보지 않는다. 먼저 무엇을 ‘비슷한 스타일’이라고 판단할지 학습한 뒤, 그 표현을 변환의 조건으로 연결했다는 점이 주목할 부분이다.
참고 자료
공개 자료 확인일: 2026-10-10.
답글 남기기