A Survey of the Recent Architectures of Deep Convolutional Neural Networks
Asifullah Khan, Anabia Sohail, Umme Zahoora, Aqsa Saeed Qureshi · Artificial Intelligence Review, 2020
핵심 요약
이 논문은 ImageNet 같은 대규모 이미지 데이터와 GPU 학습을 바탕으로 CNN 아키텍처가 빠르게 다양해지던 시기를 다룬다. 특히 AlexNet 이후인 2012~2020년의 주요 구조를 중심으로, 성능 향상을 이끈 설계 아이디어를 2020년 시점에서 정리한 서베이다.
- 새로운 단일 모델을 제안하기보다, 기존 CNN의 발전을 공간 활용·깊이·다중 경로·너비·특징 맵 활용·입력 채널 확장·attention의 일곱 범주로 분류한다.
- 초기에는 커널과 층 수를 조절하는 방법이 중심이었다면, 이후에는 블록 내부의 연산과 층 사이의 연결 방식이 중요한 연구 대상이 됐다.
- ResNet과 DenseNet은 정보 전달 방식을 바꾸고, SE와 CBAM은 이미 추출한 특징의 중요도를 조절한다. 같은 CNN이라도 성능을 높이려는 접근은 다르다.
- 분류는 서로 겹친다. 하나의 모델이 깊이·너비·다중 경로를 함께 활용할 수 있으며, 논문은 이를 여러 절에서 다룬다.
1. Introduction: CNN의 성능은 어떻게 발전했는가?
CNN은 이미지에서 특징을 추출하는 과정을 학습한다. 초기 층에서 얻은 단순한 패턴을 여러 단계에서 조합하면서 더 복잡한 표현을 만든다.
이러한 성능 향상에는 데이터와 하드웨어의 발전, 활성화 함수와 최적화 방법, 정규화 등 여러 요인이 기여했다. 이 서베이가 집중하는 것은 그중 아키텍처의 변화다. 어떤 연산을 배치하고, 층을 어떻게 연결하며, 특징을 어떻게 결합하는지가 핵심 주제다.
논문은 CNN의 기본 구성 요소와 발전 과정을 먼저 설명한 뒤, 주요 아키텍처를 일곱 범주로 분류한다. 마지막에는 응용 분야와 남은 과제, 향후 연구 방향을 다룬다. 이 글도 그 순서를 따라 정리한다.
2. Basic Components: CNN을 구성하는 연산
CNN의 중간 특징은 높이·너비·채널로 이루어진 텐서로 볼 수 있다. 공간 축은 특징이 나타난 위치를, 채널 축은 각 위치에서 표현하는 서로 다른 특징을 담는다.
합성곱은 주변 위치와 입력 채널의 정보를 결합해 새 특징을 만든다. 같은 커널을 여러 위치에서 공유하므로, 반복해서 나타나는 패턴을 위치마다 별도의 가중치를 두지 않고 학습할 수 있다.
| 구성 요소 | 동작 | 필요한 이유 |
|---|---|---|
| Convolution | 지역 영역에 같은 커널을 반복 적용하고 채널 정보를 결합 | 위치마다 별도의 가중치를 두지 않고 반복 패턴을 학습 |
| Pooling | 지역의 최대값·평균 등으로 반응을 요약 | 공간 크기와 계산량을 줄이고 작은 위치 변화의 영향을 완화 |
| Activation | ReLU 같은 비선형 함수를 적용 | 선형 변환의 반복만으로 표현하기 어려운 패턴을 학습 |
| Batch Normalization | 학습 배치의 통계로 활성값을 정규화 | 층 사이 신호의 규모를 조절하고 학습을 안정화 |
| Dropout | 학습 중 일부 활성값을 무작위로 생략 | 특정 특징이나 연결에 지나치게 의존하는 것을 완화 |
| Fully Connected Layer | 추출한 특징을 클래스 출력과 결합 | 여러 특징을 종합해 최종 예측을 만듦 |
이 구성 요소가 비슷하더라도 배치와 연결 방식에 따라 다른 모델이 된다. 예를 들어 큰 합성곱 하나를 작은 합성곱 여러 개로 바꿀 수도 있고, 같은 입력을 여러 경로에서 처리한 뒤 합칠 수도 있다.
Pooling이나 stride로 해상도를 줄이면 계산량은 감소하지만 세밀한 위치 정보도 줄어든다. 따라서 CNN의 구조는 어떤 정보를 추출할지뿐 아니라 어디에서 정보를 압축할지도 결정한다.
Batch Normalization과 dropout은 모두 학습에 도움을 주지만 작동 방식이 다르다. 전자는 활성값의 통계를 조절하고, 후자는 일부 정보를 일시적으로 생략해 의존성을 줄인다. 마지막 분류 부분도 완전연결층만 사용할 필요는 없다. 채널별 공간 평균을 구하는 global average pooling을 이용하면 큰 완전연결층에 드는 파라미터를 줄이는 구성이 가능하다.
3. Architectural Evolution: CNN의 발전 과정
서베이는 CNN의 역사를 다섯 시기로 구분한다.
| 시기 | 주요 흐름 |
|---|---|
| 1980년대 말~1999년 | ConvNet·LeNet이 지역 연결과 가중치 공유를 활용해 문자 인식에서 성과를 보임 |
| 2000년대 초 | 제한된 데이터와 계산 자원, 깊은 모델의 학습 어려움으로 발전이 정체 |
| 2006~2011년 | 학습 방법과 GPU 활용, 대규모 데이터 환경이 개선되며 연구가 다시 활발해짐 |
| 2012~2014년 | AlexNet 이후 VGG·Inception이 등장하며 깊이와 공간 연산의 구성이 다양해짐 |
| 2015년 이후부터 논문 작성 시점 | 잔차 연결·다중 경로·너비·채널·attention을 활용하는 구조가 확산 |
AlexNet 이후의 변화는 단순히 층 수가 증가했다는 것만으로 설명하기 어렵다. VGG는 작은 커널의 반복을, Inception은 병렬 경로를, ResNet은 우회 연결을 사용했다. 점차 개별 층보다 여러 연산과 연결을 묶은 블록이 설계의 기본 단위가 됐다.
4. Architectural Innovations: 일곱 가지 분류
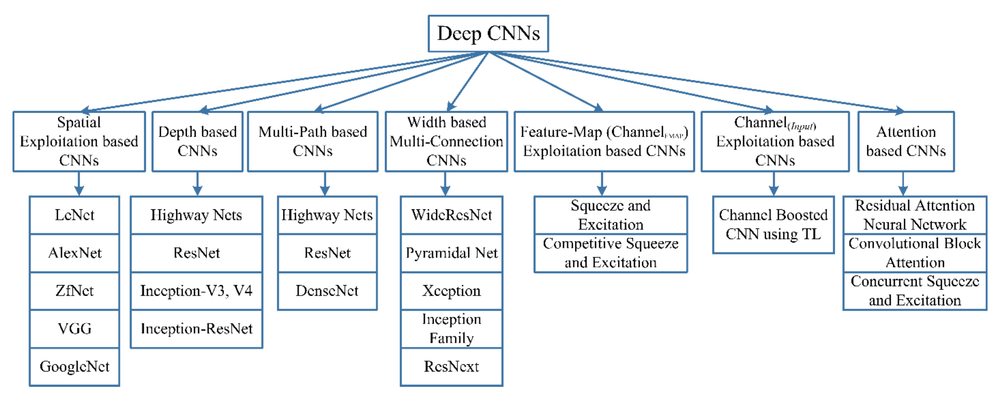
Figure 4, p.19. 논문이 제시한 CNN 아키텍처 분류. ResNet과 Highway처럼 여러 범주에 함께 등장하는 모델도 있다. 출처: Khan et al.
| 범주 | 중심 아이디어 | 대표 모델 |
|---|---|---|
| 공간 활용 | 커널 크기와 공간 규모를 조절 | LeNet, AlexNet, ZFNet, VGG, GoogLeNet |
| 깊이 | 변환을 여러 층에 걸쳐 누적 | Highway, ResNet, Inception 계열 |
| 다중 경로 | 층 사이에 추가 정보 전달 경로를 구성 | Highway, ResNet, DenseNet |
| 너비 | 채널 수와 병렬 변환을 확장 | Wide ResNet, PyramidNet, Xception, ResNeXt |
| 특징 맵 활용 | 중간 채널의 중요도를 조절 | SE, Competitive SE |
| 입력 채널 확장 | 보조 표현을 입력 채널에 추가 | Channel Boosted CNN |
| Attention | 채널·공간의 중요한 반응을 강조 | Residual Attention, CBAM, scSE |
이 분류는 서로 배타적이지 않다. 깊은 네트워크를 학습하기 위해 다중 경로를 사용할 수 있고, 넓은 병렬 구조에 잔차 연결을 추가할 수도 있다. 각 모델에서 강조한 설계 아이디어를 구분하는 관점으로 이해하면 된다.
4.1. Spatial Exploitation: 공간 정보를 어떻게 추출할까?
공간 활용 계열은 커널의 크기와 배치, stride 등을 바꾸며 이미지의 지역 구조를 더 잘 포착하려는 접근이다.
- LeNet: 합성곱과 공간 축소를 반복해 문자 특징을 학습했다. 같은 커널이 여러 위치를 처리하므로, 픽셀마다 별도의 가중치를 갖는 완전연결 방식보다 이미지의 지역 구조를 활용하기 좋았다.
- AlexNet: 더 큰 모델에 ReLU·dropout·GPU 학습 등을 결합해 복잡한 이미지 분류로 CNN의 활용을 넓혔다. 큰 초기 커널과 stride는 넓은 영역을 빠르게 처리하지만 세밀한 정보를 일찍 잃을 가능성도 있다.
- ZFNet: 중간 특징을 시각화해 어떤 반응이 학습되는지 살펴보고 초기 커널 크기와 stride를 조정했다. 층 수만 늘리기보다, 정보를 너무 빨리 줄이는 설계가 없는지 관찰한 사례다.
VGG는 주로 3×3 커널을 반복하는 단순한 구조를 사용했다. Stride 1·dilation 1에서 두 개의 3×3 합성곱을 연속으로 적용하면 이론적 수용 영역은 5×5가 된다. 작은 커널 사이에 비선형 함수도 추가할 수 있다. 다만 큰 완전연결층을 포함한 전체 모델의 계산·저장 비용은 여전히 높았다.
여기서 수용 영역은 한 출력이 영향을 받을 수 있는 입력의 범위다. 작은 커널을 쌓으면 범위를 단계적으로 넓히면서 중간 변환을 추가할 수 있다. 따라서 큰 커널 하나와 보는 범위가 같더라도 완전히 같은 연산은 아니다.
GoogLeNet의 Inception 블록은 같은 입력을 여러 공간 규모에서 병렬로 처리한다.
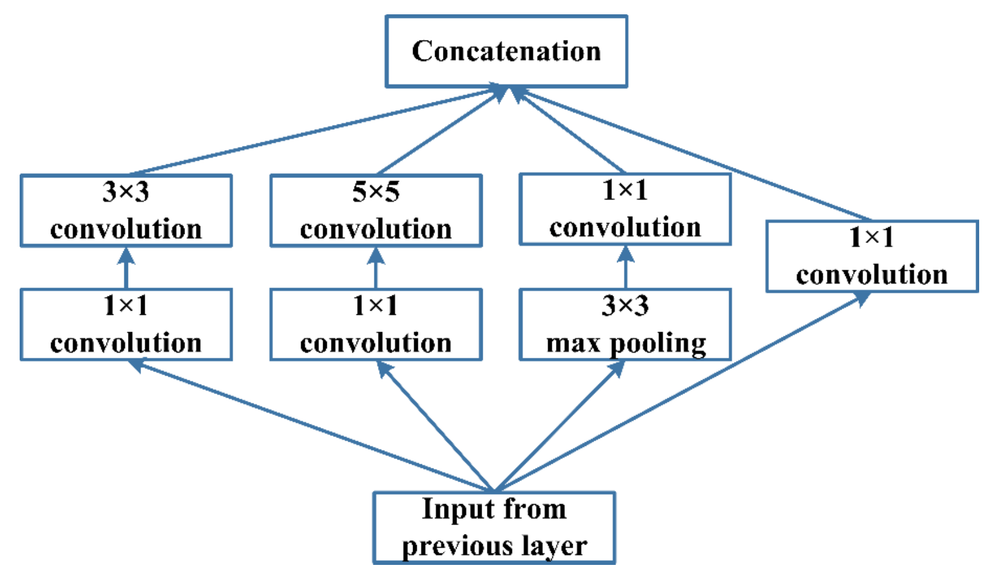
Figure 6, p.26. 입력을 나누고, 서로 다른 경로에서 변환한 뒤, 결과를 연결하는 split–transform–merge 구조. 출처: Khan et al.
3×3·5×5 합성곱과 pooling 등으로 얻은 결과를 채널 방향으로 연결한다. 큰 커널 앞의 1×1 합성곱은 채널 수를 줄여 연산 비용을 조절한다. 서로 다른 크기의 패턴을 함께 다룰 수 있지만, branch별 설정이 복잡하고 채널을 지나치게 줄이면 유용한 표현을 잃을 수 있다.
1×1 합성곱도 학습 가능한 연산이다. 공간적으로 이웃 픽셀을 보지는 않지만, 같은 위치의 여러 채널을 새 조합으로 바꾼다. Inception에서는 이 변환을 이용해 비용이 큰 공간 합성곱 앞의 채널 수를 조절한다.
4.2. Depth: 더 깊은 표현을 학습한다
깊은 구조는 여러 단계의 변환을 통해 복잡한 특징을 표현할 수 있다. 그러나 층을 추가하는 것과 그 층들을 효과적으로 학습하는 것은 별개의 문제다. 깊이가 늘면서 최적화가 어려워지고, 경우에 따라 학습 오차까지 커질 수 있다.
낮은 수준의 패턴을 조합해 더 복잡한 특징을 만드는 것이 깊이의 이점이라면, 여러 연산을 거쳐 손실의 신호를 앞쪽 층으로 전달해야 한다는 점은 학습상의 부담이다. 학습 오차까지 커지는 현상은 테스트 성능만 나빠지는 과적합과 구분해야 한다.
서베이는 Highway와 ResNet을 깊은 네트워크의 학습을 가능하게 한 주요 구조로 다룬다. 두 모델은 모두 정보가 여러 층을 우회해 전달될 수 있는 경로를 사용한다. 구체적인 연결 방식은 다음 다중 경로 분류에서 설명한다.
Inception-V3·V4는 작은 커널과 비대칭 커널 등으로 연산 구성을 개선했고, Inception-ResNet은 Inception 구조에 잔차 연결을 결합했다. 이처럼 깊이의 증가는 다른 구조적 변화와 함께 이루어졌다.
4.3. Multi-Path: 이전 정보를 어떻게 전달할까?
다중 경로 구조는 순차적인 층 사이에 추가 연결을 만든다. 특징과 기울기가 전달되는 경로를 바꾸어 깊은 네트워크의 학습을 돕는다.
Highway Networks는 변환된 정보와 입력을 그대로 전달하는 정보의 비중을 게이트로 조절한다.
y=T(x)\odot H(x)+(1-T(x))\odot x
는 변환 경로, 는 transform gate, 는 원소별 곱이다. 게이트가 변환 경로를 적게 선택하면 입력이 큰 변화 없이 전달될 수 있다. 위 식은 Highway 원 논문의 식 (3)에 맞춰 간단히 재표기했다.
게이트 값이 0에 가까우면 입력을 그대로 보내는 비중이 커지고, 1에 가까우면 변환 결과의 비중이 커진다. 이 비율을 입력에 맞게 학습할 수 있지만, 그만큼 게이트를 계산하는 파라미터와 연산도 필요하다.
ResNet은 게이트 대신 입력과 잔차 변환을 더한다.
y=x+F(x)
는 입력에 더할 변화를 학습한다. 위 식은 덧셈 직후의 출력이며, 실제 블록에는 이후 활성화가 적용될 수 있다. 입력과 출력의 크기가 다르면 projection 등으로 차원을 맞춘다.
기본 identity shortcut은 Highway처럼 입력별로 열고 닫는 게이트를 계산하지 않는다. 같은 크기의 두 표현을 더하므로 채널 수가 연결할 때처럼 누적되지 않으며, 기존 정보를 전달하는 경로와 변화를 학습하는 경로가 함께 존재한다.
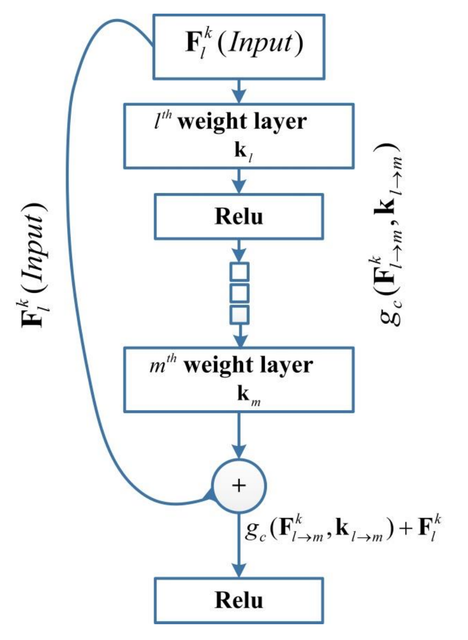
Figure 7, p.28. 입력이 왼쪽 경로로 직접 전달되고 변환 결과와 더해진다. 이 그림에는 덧셈 뒤 ReLU가 있다. 출처: Khan et al.
DenseNet은 이전 특징을 더하는 대신 채널 방향으로 연결한다.
x_l=H_l\left(\operatorname{Concat}(x_0,\ldots,x_{l-1})\right)하나의 dense block 안에서 이전 층들의 특징을 다음 변환의 입력으로 사용한다. 특징 재사용에 유리하지만, 누적되는 특징을 저장하고 연결하는 메모리 비용도 고려해야 한다.
ResNet이 두 표현을 같은 채널 공간에 더한다면, DenseNet은 이전 특징을 서로 다른 채널 묶음으로 남겨 다음 층이 사용할 수 있게 한다. 각 층이 새로 만들어 추가하는 채널 수를 growth rate라고 부른다. 이전 특징의 재사용과 새 특징의 추가량을 함께 설계하는 방식이다.
세 모델의 차이는 게이트를 통한 선택, 잔차 덧셈, 특징 연결로 요약할 수 있다. 모두 정보를 잘 전달하려는 구조이지만 결합하는 연산은 다르다.
4.4. Width: 채널과 병렬 변환을 확장한다
너비 기반 구조는 깊이를 늘리는 것 외의 방법으로 표현력을 높인다. 여기서 너비는 주로 채널 수나 병렬 변환의 구성을 뜻한다.
| 모델 | 주요 변화 |
|---|---|
| Wide ResNet | 잔차 블록의 채널 수를 늘려 더 넓은 표현을 학습 |
| PyramidNet | 잔차 단위마다 채널 수를 점진적으로 증가 |
| ResNeXt | 같은 형태의 변환을 여러 경로로 구성하고 결합 |
| Xception | 공간 합성곱과 채널 결합을 분리 |
Wide ResNet은 매우 깊고 가는 모델만 늘리는 대신 각 잔차 블록이 더 많은 채널을 처리하도록 한다. 한 단계의 표현 용량을 키울 수 있지만 파라미터와 계산량도 증가한다. 깊이와 너비 중 어느 쪽에 자원을 배분할지에 대한 선택이다.
PyramidNet은 채널 수를 특정 단계에서 크게 늘리기보다 잔차 단위마다 점진적으로 늘린다. 표현 용량의 증가를 여러 블록에 나누어 배치하려는 설계다. 여기서 너비는 이미지의 가로 해상도가 아니라 특징 채널 수를 뜻한다.
ResNeXt의 cardinality는 병렬 변환 경로의 수를 가리킨다. 경로 안의 채널 수를 늘리는 것과는 다른 설계 변수다. 같은 형태의 변환을 반복하는 균일한 구성을 사용하며, grouped convolution으로 구현할 수 있다.
Inception이 서로 다른 크기의 필터 경로를 조합했다면, ResNeXt는 같은 형태의 변환을 여러 갈래로 구성하는 데 집중한다. ‘한 경로를 넓게 만들기’와 ‘변환 경로를 더 많이 두기’를 구분한 것이다.
Xception은 depthwise separable convolution을 사용한다. 채널마다 공간 합성곱을 적용하는 depthwise 연산 다음에, 1×1 pointwise 합성곱으로 채널을 결합한다. 서베이는 이를 너비 기반 계열에 넣지만, 연산의 핵심은 공간과 채널 관계를 분리해 계산한다는 것이다.
일반 합성곱은 공간의 이웃과 여러 입력 채널을 한꺼번에 결합한다. Xception의 분리된 연산에서는 먼저 채널마다 공간 패턴을 처리하고, 다음 단계에서 채널 간 관계를 만든다. 같은 계산을 그대로 빠르게 수행하는 것이 아니라, 표현을 만드는 방식 자체를 분해한 접근이다.
너비·경로 수·연산 분해는 서로 다른 선택이다. 모델의 성능과 비용은 이들을 어떻게 조합하느냐에 따라 달라진다.
4.5. Feature-Map Exploitation: 중요한 채널을 강조한다
앞선 구조들이 특징을 만드는 방식을 바꿨다면, 이 계열은 이미 추출된 특징 맵의 중요도를 조절한다. 대표적인 방법은 Squeeze-and-Excitation이다.
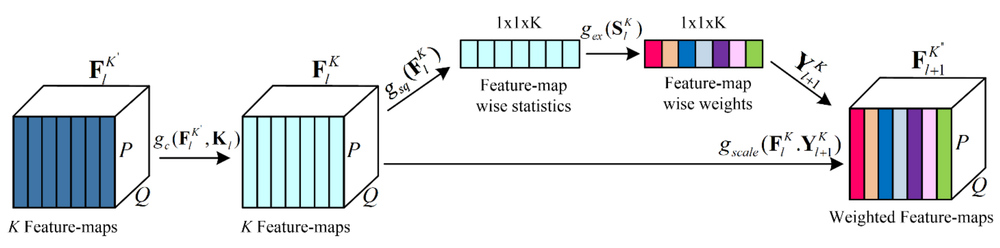
Figure 10, p.39. 위쪽 경로에서 채널 통계와 가중치를 구하고, 이를 아래쪽의 특징 맵에 곱한다. 출처: Khan et al.
SE는 세 단계로 동작한다.
- Squeeze: global average pooling으로 각 채널의 공간 전체 반응을 요약한다.
- Excitation: 두 개의 학습 가능한 변환과 ReLU·sigmoid로 채널별 가중치를 구한다.
- Scale: 가중치를 각 채널에 곱한다.
공간 평균은 다음과 같이 표현할 수 있다.
z_c=\frac{1}{HW}\sum_{i=1}^{H}\sum_{j=1}^{W}U_{i,j,c}는 입력 특징, H와 W는 공간 크기, 는 c번째 채널을 요약한 값이다. 전체 채널 요약 벡터를 z라고 하면 가중치는 다음과 같이 구한다.
s=\sigma\left(W_2\operatorname{ReLU}(W_1z)\right)과 는 차원을 줄였다가 복원하는 학습 가능한 변환이고, 는 sigmoid다. 계산된 를 c번째 특징 맵에 곱한다. 채널별로 같은 가중치를 공간 전체에 적용하므로, 기본 SE는 위치별 마스크와 구분된다.
이 가중치는 현재 입력의 특징에서 계산되므로 이미지에 따라 달라진다. 같은 채널이라도 어떤 이미지에서는 더 강조되고 다른 이미지에서는 약해질 수 있다. 여러 채널이 함께 중요할 수 있어, sigmoid는 가중치 합을 1로 맞추는 경쟁을 강제하지 않는다.
Competitive SE는 가중치를 구할 때 잔차 경로와 identity 경로 양쪽의 특징 통계를 사용한다. 어떤 특징을 강조할지 결정하는 데 두 경로의 관계를 함께 반영하려는 접근이다.
잔차 특징만 보면 새로 계산한 정보가 원래 입력과 어떤 관계인지 충분히 반영하기 어렵다는 문제의식이다. 양쪽의 전역 통계를 함께 사용해, 기존 정보와 새 정보의 관계까지 보고 잔차 채널을 재조정한다.
4.6. Channel Boosting: 입력에 보조 표현을 추가한다
Channel Boosted CNN은 보조 학습기가 생성한 채널을 원래 입력과 결합한다. 기존 특징의 비중을 바꾸는 SE와 달리, 주 네트워크가 받는 입력 표현을 확장한다.
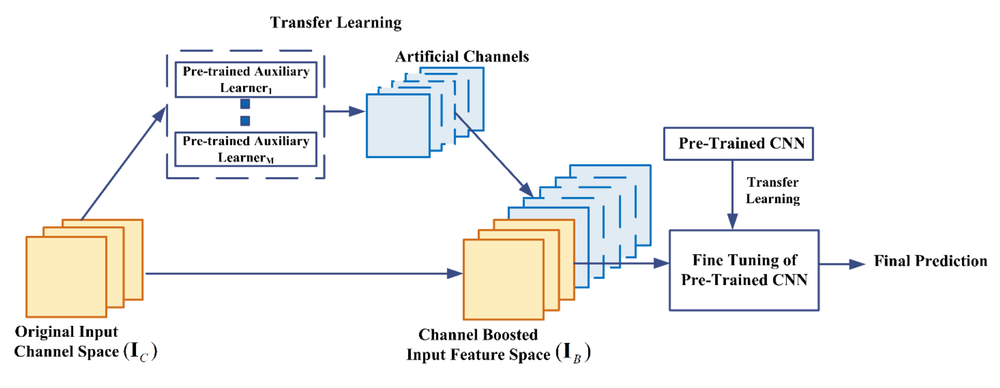
Figure 11, p.42. 보조 모델의 출력이 원래 입력 채널과 연결된 뒤 CNN에 전달된다. 출처: Khan et al.
서베이는 autoencoder 등의 보조 학습기와 transfer learning을 활용하는 방법을 소개한다. 구조의 핵심은 다음과 같다.
I_B=\operatorname{Concat}(I,A_1,\ldots,A_M)는 원래 입력이고, 은 m번째 보조 학습기가 만든 표현이다. 이를 채널 방향으로 연결해 확장 입력 를 만든다.
흐름은 보조 모델로 표현 생성 → 원래 채널과 결합 → 주 CNN으로 예측이다. 보조 모델이 학습한 표현을 추가한다는 점에서, 같은 모델 내부의 기존 채널에 가중치를 곱하는 SE와 다르다. 원래 입력에서 계산한 보조 표현일 수도 있으므로 새로운 센서 관측을 추가한 것과는 구분해야 한다.
논문 Table 4는 mitosis 데이터셋의 F-score를 다음과 같이 보고한다.
| 기반 모델 | 기존 CNN | Channel Boosted CNN |
|---|---|---|
| 26층 CNN | 0.47 | 0.53 |
| VGG | 0.55 | 0.71 |
| ResNet | 0.44 | 0.54 |
출처: 서베이 p.42, Table 4를 모델별로 재구성. F-score는 높을수록 좋다.
표에서는 세 모델 모두 개선됐지만, 이를 다른 데이터셋의 성능으로 일반화할 수는 없다. 보조 모델이 필요한 만큼 추가되는 계산 비용도 함께 봐야 한다.
4.7. Attention: 무엇과 어디를 강조할까?
Attention 계열은 입력에 따라 중요한 채널이나 위치에 더 큰 비중을 부여한다.
- Residual Attention Network: trunk branch가 특징을 계산하고 mask branch가 어떤 반응을 강조할지 정한다. Mask branch는 낮은 해상도에서 문맥을 모은 뒤 공간적으로 촘촘한 가중치를 만드는 bottom-up·top-down 구성을 활용한다. 특징 생성과 중요도 계산을 별도 경로로 맡기는 방식이다.
- CBAM: 채널 attention으로 ‘무엇을 볼지’를 조정한 다음, 공간 attention으로 ‘어디를 볼지’를 조정한다. Average pooling은 전체적인 반응을, max pooling은 강한 반응을 요약하는 데 사용한다. 채널과 위치의 중요도를 순서대로 계산하므로 기본 SE보다 공간 정보를 더 직접적으로 다룬다.
- scSE: cSE는 공간 정보를 요약해 채널 가중치를 만들고, sSE는 채널 정보를 모아 위치별 가중치를 만든다. 두 경로를 병렬적으로 결합해 채널과 공간을 함께 강조한다. 순차적으로 적용하는 CBAM과 달리 두 종류의 excitation을 나란히 사용하는 구성이며, 픽셀별 판단이 필요한 분할과 연결된다.
SE와 attention 계열의 경계도 겹친다. SE는 채널 재가중에 집중하고, CBAM과 scSE는 공간 축까지 함께 고려한다. 논문의 분류는 이런 강조점의 차이를 보여준다.
5. Applications: CNN의 활용 범위
논문은 CNN의 응용을 이미지 분류에 한정하지 않는다.
| 분야 | 논문이 소개하는 활용 |
|---|---|
| 컴퓨터 비전 | 얼굴 인식, 자세 추정, 행동 인식 |
| 검출·분할 | 객체 위치 추정, 의미·인스턴스 분할 |
| 의료영상 | 조직 이미지 분류, 세포 검출, 영상 분할 |
| 언어·음성 | 문장 모델링, 음성 인식, 감정 인식 |
| 영상·신호 | 시공간 특징 분석, ECG 등 1차원 신호 처리 |
| 임베디드 시스템 | 제한된 자원에서의 영상 인식 |
응용에 따라 필요한 표현은 다르다. 분류는 이미지 전체를 요약한 특징을 사용할 수 있지만, 검출과 분할은 위치와 경계도 보존해야 한다. 영상이나 신호에서는 시간적 문맥까지 다루게 된다.
6. Challenges: 구조가 발전해도 남는 문제
서베이가 제시하는 주요 과제는 다음과 같다.
- 해석 가능성: 어떤 특징과 근거로 판단하는지 설명하기 어렵다.
- 입력 교란에 대한 취약성: 작은 입력 변화에도 예측이 달라질 수 있다.
- 데이터 의존성: 충분한 학습 데이터와 주석을 확보하는 비용이 크다.
- 설정의 민감성: 커널, 층 수, 활성화 함수 등 여러 선택이 결과에 영향을 준다.
- 계산 자원: 깊고 넓은 모델의 학습·실행에는 메모리와 계산량이 필요하다.
성능표를 읽을 때도 평가 조건을 구분해야 한다. 서베이 Table 2에는 ImageNet·CIFAR·MNIST 등 서로 다른 데이터셋과 모델 설정이 함께 들어 있다. 단일 모델과 앙상블, 입력 크기와 crop 조건도 달라질 수 있어 표의 숫자만으로 구조 전체의 우열을 정하기는 어렵다.
7. Future Directions: 더 좋은 블록과 효율적인 계산
논문은 앞으로의 방향으로 채널·attention의 활용, 보조 학습기, 자동 구조 탐색, 하드웨어 친화적 설계 등을 제시한다. 압축·양자화·가속기·분산 학습도 계산 자원의 제약을 완화하는 방법으로 논의한다.
이 흐름의 공통점은 모델의 크기를 늘리는 것에서 나아가, 특징을 더 유용하게 만들고 전달하는 블록을 설계하는 것이다. 반복 가능한 블록은 복잡한 네트워크를 구성하면서도 각 부분의 역할을 구분하게 해준다.
여기서 말하는 향후 방향은 2020년 논문 작성 시점의 전망이다. 이후 연구 전체를 정리한 최신 서베이로 해석해서는 안 된다.
8. Conclusion: CNN의 발전은 연결과 처리 방식의 발전이다
이 서베이는 CNN 아키텍처의 변화를 일곱 범주로 정리한다. 큰 흐름은 공간 특징을 추출하는 방법에서 출발해, 깊은 네트워크의 학습, 다중 경로와 너비, 채널과 attention의 활용으로 확장된다.
VGG의 작은 커널, Inception의 병렬 처리, ResNet의 잔차 연결, DenseNet의 특징 연결, SE의 채널 재조정은 각각 다른 문제에 대한 해법이다. 이들은 서로 대체되기만 한 것이 아니라 후속 구조에서 함께 결합되기도 했다.
논문의 핵심은 CNN의 발전을 단순한 층 수 증가가 아니라, 연산과 연결을 어떻게 구성해왔는지의 관점에서 정리했다는 데 있다.
참고 자료
- A Survey of the Recent Architectures of Deep Convolutional Neural Networks: 본문의 중심 서베이. 일곱 분류, 발전 과정, 응용·한계와 Figures 4·6·7·10·11을 참조했다.
- Highway Networks: transform·carry gate의 결합 수식을 대조했다.
- Xception: Deep Learning with Depthwise Separable Convolutions: depthwise·pointwise 연산의 순서를 확인했다.
- Squeeze-and-Excitation Networks: squeeze·excitation 연산의 표기를 확인했다.
답글 남기기