An Image is Worth 16×16 Words: Transformers for Image Recognition at Scale
Alexey Dosovitskiy, Lucas Beyer, Alexander Kolesnikov 외 · Google Research, Brain Team · ICLR 2021
논문 · 원문 · 공식 구현·사전학습 모델
핵심 요약
이 논문이 처음 공개된 2020년에는 자연어 처리에서 Transformer의 대규모 사전학습이 확산된 반면, 이미지 인식에서는 CNN이 중심이었다. 비전에 attention을 적용하는 연구도 있었지만 CNN과 결합하거나 이미지 전용 attention 구조를 설계하는 경우가 많았다. ViT는 이미지를 패치의 시퀀스로 바꾸면 표준 Transformer를 거의 그대로 사용할 수 있는가를 검토한 연구다.
- 이미지를 일정 크기의 패치로 나누고, 각 패치를 벡터로 바꿔 Transformer encoder에 입력한다.
- 패치의 위치를 나타내는 임베딩과 이미지 전체를 대표할 학습 가능한
class token을 추가한다. - 주요 결과는 대규모 데이터에서 지도 사전학습한 뒤 다른 이미지 분류 작업으로 전이한 성능이다. 작은 데이터만으로 처음부터 학습해도 CNN보다 항상 좋다는 주장은 아니다.
- 실험에서는 데이터 규모가 커질수록 큰 ViT의 장점이 뚜렷해졌다. 단순한 구조와 대규모 사전학습의 조합이 논문의 핵심이다.
1. Introduction: 이미지에도 표준 Transformer를 사용할 수 있을까?
NLP에서 Transformer는 문장을 토큰의 시퀀스로 처리하며, 큰 데이터에서 사전학습한 표현을 다른 작업에 활용하는 방식으로 발전했다. 비전에서는 ResNet 같은 합성곱 구조가 널리 사용되고 있었다.
이미지에 self-attention을 적용하는 데는 계산상의 문제가 있다. 각 픽셀이 다른 모든 픽셀과 관계를 계산하면 시퀀스가 지나치게 길어진다. 기존 연구들은 지역 attention이나 희소 연결처럼 이미지에 맞춘 구조를 사용했지만, 효율적인 구현과 확장이 복잡해질 수 있었다.
ViT의 선택은 attention 구조를 복잡하게 바꾸기보다 입력 단위를 패치로 바꾸는 것이다. 그 위에 익숙한 Transformer encoder를 배치하고, 데이터와 모델 크기를 늘렸을 때 어떤 결과가 나오는지 살펴본다.
2. Related Work: 새로운 점은 attention의 최초 도입이 아니다
논문은 이미지에 attention을 사용한 선행 연구, CNN과 Transformer를 결합한 모델, 이미지 패치를 처리하는 연구를 함께 소개한다. 따라서 ViT의 기여를 ‘이미지에 처음으로 attention을 썼다’고 정리하면 부정확하다.
핵심은 이미지 전용 변경을 최소화한 Transformer도 충분한 사전학습 규모에서 강력한 이미지 인식 모델이 될 수 있음을 보여준 것이다. 구조의 단순함과 확장 가능성, 전이 성능을 함께 확인했다는 점이 중요하다.
3. Method: 패치에서 이미지 분류까지
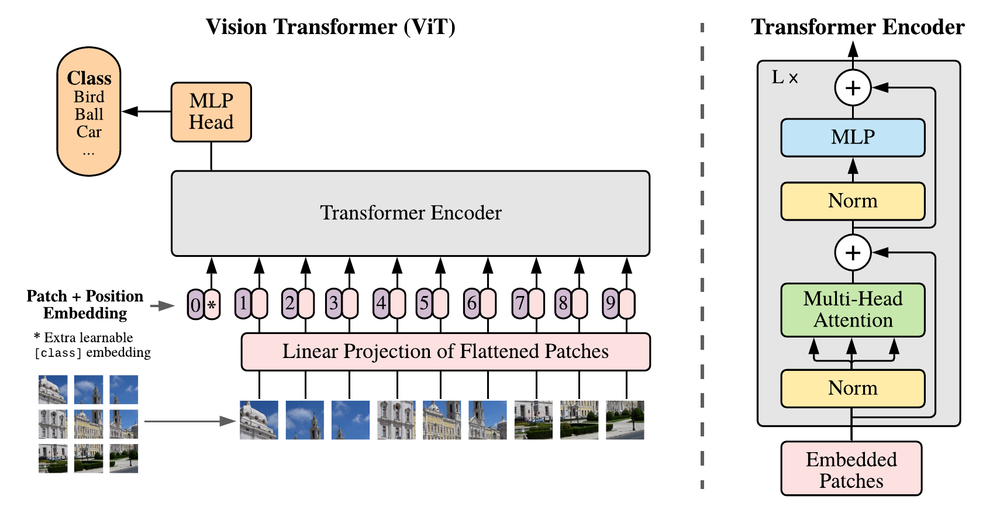
Figure 1, p.3. 왼쪽은 패치를 시퀀스로 바꾸어 분류하는 전체 흐름, 오른쪽은 반복되는 Transformer encoder 블록이다. 출처: Dosovitskiy et al.
3.1. Patch Embedding: 이미지 조각을 토큰으로 바꾼다
입력 이미지의 높이와 너비를 H, W, 채널 수를 C, 정사각형 패치의 한 변을 P라고 하자. 이미지를 겹치지 않는 패치로 나누면 패치 수는 다음과 같다. H와 W가 P로 나누어떨어지는 경우다.
N=\frac{HW}{P^2}각 패치를 펼치면 차원의 벡터가 된다. 같은 학습 가능한 선형 투영을 모든 패치에 적용해 D차원의 patch embedding으로 바꾼다. Transformer는 이 N개의 패치 벡터를 시퀀스로 처리한다.
패치는 단어처럼 미리 의미가 정해진 항목은 아니다. 위치별 이미지 조각을 모델이 처리할 수 있는 벡터로 변환한 것이다. 제목의 ‘16×16 Words’는 이런 입력 방식의 비유이며, 논문은 16×16 외의 패치 크기도 실험한다.
3.2. Class Token과 Position Embedding
논문의 입력 시퀀스는 다음과 같다.
z_0=[x_{\mathrm{class}};x_p^1E;\ldots;x_p^NE]+E_{\mathrm{pos}}- : 펼친 i번째 이미지 패치.
- : 패치를 D차원으로 바꾸는 공유 투영 행렬. 크기는 다.
- : 시퀀스 앞에 붙이는 학습 가능한 벡터. 특정 패치에서 가져온 값이 아니다.
- : 각 토큰의 위치를 나타내는 학습 가능한 임베딩. 크기는 다.
- 세미콜론은 벡터를 토큰 축으로 이어 붙임을 뜻한다. 위치 임베딩은 그 결과에 더한다.
Class token은 여러 층의 attention을 거치며 패치들의 정보를 반영한다. 마지막에는 이 토큰의 표현을 분류기에 전달한다.
Position embedding은 패치들 사이의 위치 정보를 제공한다. 논문은 기본적으로 학습 가능한 1차원 위치 임베딩을 사용했다. 패치를 순서대로 나열하되, 그 순서에 해당하는 임베딩을 학습하는 방식이다.
3.3. Transformer Encoder: 먼저 정규화하고 잔차를 더한다
각 encoder 층은 Multi-Head Self-Attention과 MLP로 구성된다. 원 논문 식 (2)·(3)의 흐름은 다음과 같다.
z'_\ell=\operatorname{MSA}(\operatorname{LN}(z_{\ell-1}))+z_{\ell-1}z_\ell=\operatorname{MLP}(\operatorname{LN}(z'_\ell))+z'_\ellLN: Layer Normalization.MSA: 여러 head에서 토큰 사이 관계를 계산하는 self-attention.MLP: 각 토큰에 같은 방식으로 적용되는 두 층의 변환. 중간 활성화 함수는 GELU다.- 각 하위 블록의 출력에 입력을 더하는 residual connection을 사용한다.
정규화를 연산 앞에 적용하는 Pre-LN 구조라는 점을 구분해야 한다. 이미지 분류를 위한 encoder이므로, 번역 모델의 decoder나 미래 토큰을 가리는 causal mask는 사용하지 않는다.
하나의 attention head는 다음과 같은 방식으로 정보를 모은다.
\operatorname{Attention}(Q,K,V)=\operatorname{softmax}\left(\frac{QK^\top}{\sqrt{d_h}}\right)VQ·K·V는 같은 입력 시퀀스에서 서로 다른 투영으로 만든 Query·Key·Value다. 는 head의 Query·Key 차원이다. 각 토큰은 다른 토큰과의 관련성에 따라 Value를 가중합하고, 여러 head의 결과를 결합한다.
마지막 층에서 얻은 class token을 정규화한 표현은 다음과 같다.
y=\operatorname{LN}(z_L^0)위첨자 0은 class token의 위치를 뜻한다. 이 y에 분류 head를 연결한다. 논문은 사전학습에서는 한 개의 hidden layer가 있는 MLP head를, 다른 데이터셋으로 미세조정할 때는 새 선형 분류기를 사용한다.
3.4. Inductive Bias: 이미지 구조를 얼마나 미리 넣어둘까?
귀납적 편향은 모델이 어떤 종류의 패턴을 쉽게 학습하도록 구조에 넣어둔 가정을 뜻한다. 합성곱의 지역 연결과 위치 간 가중치 공유는 이미지에 유용한 편향이다.
ViT는 이런 이미지 특화 구조를 상대적으로 적게 사용한다. Self-attention은 첫 층부터 모든 패치 사이의 관계를 계산할 수 있고, 패치들의 공간적 관계도 데이터에서 학습해야 한다.
이 차이는 데이터가 적을 때 불리할 수 있다. 반면 충분한 데이터가 있다면 구조에 강하게 고정하지 않은 관계를 유연하게 학습할 여지가 있다. 논문은 이 가설을 데이터 규모를 바꾸는 실험으로 확인한다.
ViT에 이미지 관련 가정이 전혀 없는 것은 아니다. 입력을 2차원 패치로 나누며, 해상도를 바꿀 때도 패치의 2차원 배치를 이용한다. 논문은 CNN 특징 맵을 입력으로 사용하는 hybrid 모델도 별도로 비교한다.
3.5. Fine-tuning: 해상도가 달라지면 위치 임베딩도 조정한다
사전학습 후에는 기존 분류 head를 제거하고, 목표 데이터셋의 클래스 수에 맞는 선형층을 연결한다. 이때 사전학습 때보다 높은 해상도로 미세조정하는 설정도 사용한다.
패치 크기는 유지한 채 이미지 해상도를 높이면 패치 수가 증가한다. 기존 위치 임베딩을 그대로 붙일 수 없으므로, 패치의 원래 2차원 배치에 맞춰 위치 임베딩을 보간한다.
작은 패치나 높은 해상도는 더 세밀한 정보를 제공하지만 계산 비용도 늘린다. Self-attention의 토큰 간 점수 행렬은 토큰 수에 대해 제곱으로 커진다. 다만 이는 attention 부분의 비용이며, 모델 전체에는 선형 투영과 MLP의 연산도 포함된다.
4. Experiments: 구조와 데이터 규모를 함께 본다
4.1. 데이터와 모델 구성
논문은 다음 세 규모의 데이터로 사전학습을 비교한다.
| 사전학습 데이터 | 이미지 수 | 클래스 수 | 구분 |
|---|---|---|---|
| ImageNet | 약 130만 | 1,000 | ILSVRC-2012 |
| ImageNet-21k | 약 1,400만 | 약 21,000 | 공개 대규모 데이터 |
| JFT-300M | 약 3억 300만 | 약 18,000 | Google 내부 데이터 |
원 논문 §4.1의 표기 기준. JFT-300M은 데이터셋 이름이며 본문에서는 303M 이미지로 설명한다.
전이 성능은 ImageNet, CIFAR-10/100, Pets, Flowers, VTAB 등에서 평가한다. VTAB는 19개 작업으로 구성되며 작업마다 1,000개의 학습 예제를 사용한다. 이는 큰 데이터에서 사전학습한 뒤 소량 데이터로 전이하는 설정이다.
모델 크기는 Table 1처럼 구분한다.
| 모델 | 층 수 | Hidden 차원 | MLP 차원 | Head 수 | 파라미터 |
|---|---|---|---|---|---|
| ViT-Base | 12 | 768 | 3072 | 12 | 약 86M |
| ViT-Large | 24 | 1024 | 4096 | 16 | 약 307M |
| ViT-Huge | 32 | 1280 | 5120 | 16 | 약 632M |
ViT-L/16은 Large 모델에 16×16 패치를 사용한다는 뜻이다. 모델 크기와 패치 크기를 함께 봐야 계산 규모를 이해할 수 있다.
비교 모델인 ResNet(BiT)는 단순한 기본 ResNet과 다르다. 전이 학습에 맞춰 Group Normalization과 standardized convolution을 사용한 설정이다.
4.2. 학습 설정: 사전학습과 미세조정을 구분한다
- 사전학습은 Adam, 배치 크기 4096, 입력 해상도 224×224를 사용한다.
- 정규화와 학습 스케줄은 데이터셋마다 다르다. 부록 Table 3에서 JFT의 weight decay는 0.1, ImageNet-21k는 0.03, ImageNet은 0.3으로 제시된다.
- 미세조정은 SGD with momentum 0.9, 배치 크기 512를 사용하며, 기본 해상도는 별도 언급이 없으면 384×384다.
- Table 2의 ImageNet 결과에는 더 높은 해상도를 사용했다. ViT-L/16은 512×512, ViT-H/14는 518×518이며 가중치 평균화도 적용했다.
평가 방식도 두 가지다. Fine-tuning 정확도는 목표 작업에 맞춰 모델을 조정한 결과이고, linear few-shot 정확도는 특징 추출부를 고정한 채 소수 예제의 특징으로 선형 예측기를 맞춘 결과다. 뒤의 그래프에서 두 지표를 같은 숫자로 비교하면 안 된다.
4.3. 주요 결과: 대규모 사전학습 후의 전이 성능
다음은 원 논문 Table 2에서 주요 데이터셋을 발췌한 것이다.
| 모델 | 사전학습 | ImageNet ↑ | CIFAR-100 ↑ | VTAB ↑ |
|---|---|---|---|---|
| ViT-H/14 | JFT-300M | 88.55 ± 0.04 | 94.55 ± 0.04 | 77.63 ± 0.23 |
| ViT-L/16 | JFT-300M | 87.76 ± 0.03 | 93.90 ± 0.05 | 76.28 ± 0.46 |
| ViT-L/16 | ImageNet-21k | 85.30 ± 0.02 | 93.25 ± 0.05 | 72.72 ± 0.21 |
| BiT-L: ResNet152×4 | JFT-300M | 87.54 ± 0.02 | 93.51 ± 0.08 | 76.29 ± 1.70 |
정확도(%), 세 번의 미세조정 실행에 대한 평균 ± 표준편차. ImageNet은 원래 검증 레이블 기준이며, VTAB는 19개 작업의 결과를 집계한 점수다.
JFT에서 사전학습한 ViT-H/14는 표의 세 평가에서 BiT-L보다 높은 평균 성능을 보인다. ImageNet 정확도 차이는 1.01%p다.
반면 ViT-L/16의 VTAB 평균은 76.28로 BiT-L의 76.29와 비슷하다. 공개 ImageNet-21k로 사전학습한 모델은 JFT 모델보다 낮다. ViT라는 구조 이름만으로 성능을 설명하지 말고, 모델 크기·사전학습 데이터·평가 작업을 함께 봐야 한다.
4.4. 데이터가 적을 때도 같은 결과가 나올까?
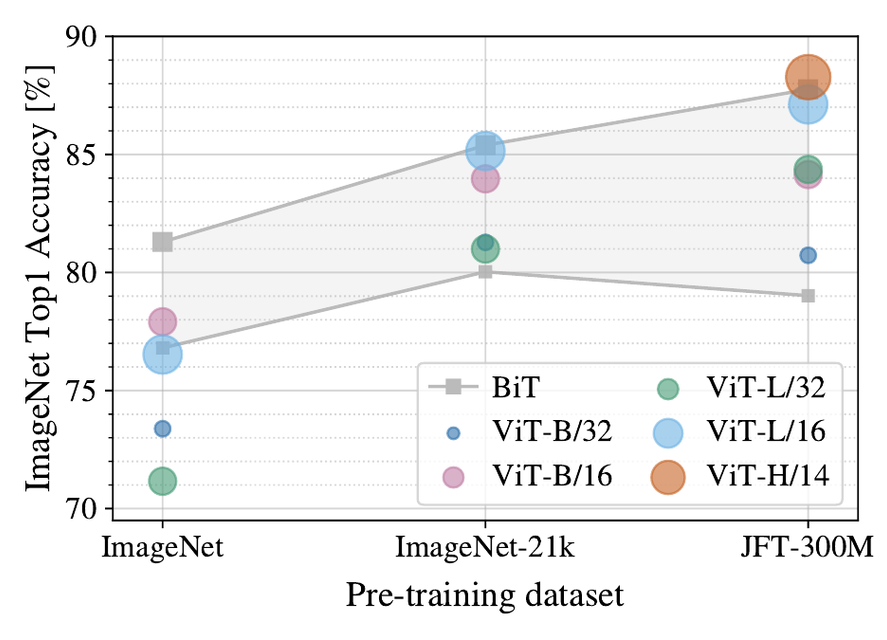
Figure 3, p.7. 가로축은 사전학습 데이터, 세로축은 ImageNet으로 미세조정한 뒤의 Top-1 정확도다. 회색 영역은 여러 크기의 BiT 모델이 보인 성능 범위다. 출처: Dosovitskiy et al.
논문이 강조하는 변화는 다음과 같다.
- ImageNet만 사용한 설정에서는 CNN이 유리했고, 큰 ViT-L이 작은 ViT-B보다도 낮은 성능을 보일 수 있었다.
- ImageNet-21k에서는 더 큰 ViT의 이점이 나타나기 시작한다.
- JFT-300M에서는 큰 모델의 장점이 뚜렷해진다.
여기서도 ImageNet 사전학습 모델은 해상도를 높이는 미세조정 과정을 거친다. ‘ImageNet으로 처음부터 한 번 학습한 결과’와 그대로 동일시해서는 안 된다.
추가로 논문은 JFT의 900만·3,000만·9,000만 이미지 부분집합과 전체 데이터로 비교했다. 이 실험의 Figure 4는 ImageNet 5-shot 선형 평가다. 작은 사전학습 데이터에서는 ResNet이 유리하지만, 데이터가 커지면 ViT가 더 잘 확장되는 경향을 보였다.
이 결과는 원 논문의 학습 설정에서 얻은 관찰이다. 모든 Transformer가 어떤 학습법을 써도 반드시 수억 장을 필요로 한다는 일반 법칙은 아니다.
4.5. 성능과 사전학습 비용
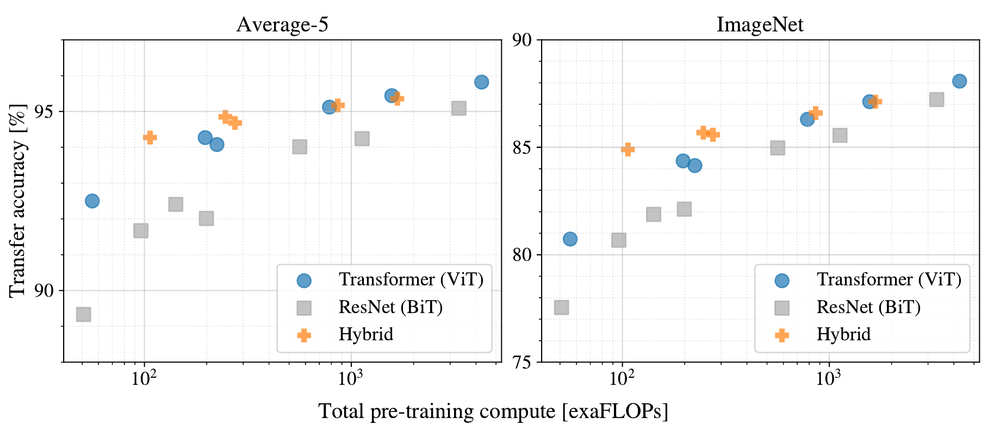
Figure 5, p.7. 가로축은 총 사전학습 계산량(exaFLOPs), 세로축은 전이 정확도다. 왼쪽은 5개 데이터셋 평균, 오른쪽은 ImageNet 결과다. 출처: Dosovitskiy et al., v2.
동일한 JFT-300M에서 모델 크기와 학습 기간을 바꿔 비교한 scaling study에서는, ViT가 5개 데이터셋 평균 기준으로 비슷한 성능에 도달하는 데 약 2~4배 적은 계산량을 사용했다고 보고한다. 작은 계산 예산에서는 hybrid가 유리한 경우가 있었지만, 큰 모델에서는 그 차이가 줄었다.
Table 2에는 사전학습 비용을 TPUv3-core-days로도 제시한다. 사용한 TPU 코어 수에 학습 일수를 곱한 값으로, 단순한 실제 경과 일수는 아니다. ViT-H/14는 약 2,500, JFT로 학습한 ViT-L/16은 약 680, BiT-L은 약 9,900이다.
이 비교가 ‘모든 환경에서 ViT가 더 빨리 실행된다’는 뜻은 아니다. 학습 비용에는 구조뿐 아니라 학습 기간과 최적화 설정도 영향을 준다. 논문 역시 실제 하드웨어 속도와 이론적 연산량이 항상 일치하지 않는다고 구분한다.
4.6. 모델 내부와 구성 요소를 살펴본 결과
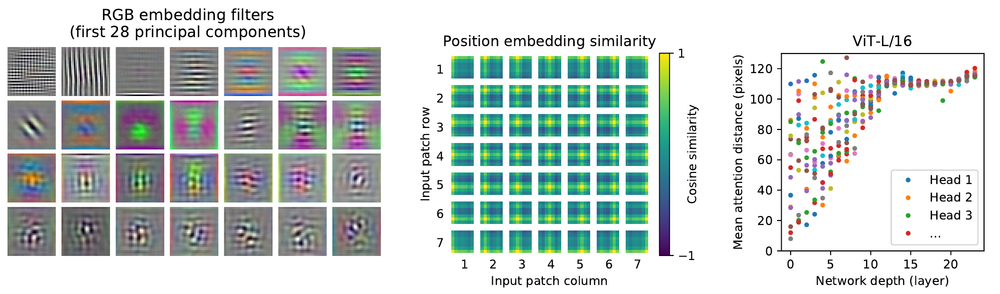
Figure 7, p.9. 왼쪽은 ViT-L/32의 패치 투영 필터에 대한 주성분, 가운데는 위치 임베딩의 유사도, 오른쪽은 ViT-L/16의 층·head별 평균 attention 거리다. 출처: Dosovitskiy et al.
- 패치 투영: 학습한 필터의 주요 성분에서 패치 내부의 방향·색상 패턴을 표현하는 형태가 관찰된다.
- 위치 임베딩: 가까운 패치나 같은 행·열의 임베딩이 비슷해지는 구조를 학습한다.
- Attention 거리: 낮은 층에서는 가까운 영역을 보는 head와 넓은 영역을 보는 head가 함께 나타나며, 깊어질수록 전역 정보를 활용하는 경향이 커진다.
‘전역 attention을 계산할 수 있다’는 것과 ‘모든 head가 처음부터 똑같이 전역 정보를 쓴다’는 것은 다르다. 이 분석은 학습된 모델이 국소·전역 관계를 어떻게 활용하는지 보여준다.
부록의 두 비교도 유용하다.
| 비교 | 논문에서 확인한 점 |
|---|---|
| Class token 대 Global Average Pooling | 학습률을 맞게 조정하면 두 방식 모두 비슷하게 동작한다. Class token 자체가 성능의 필수 조건이라고 단정할 수 없다 |
| 위치 임베딩 없음·1D·2D·상대 위치 | 위치 정보가 없는 경우는 불리했지만, 비교한 위치 임베딩 방식 사이의 차이는 작았다 |
두 비교는 부록 D.3·D.4의 few-shot 선형 평가를 바탕으로 한다. Table 2의 최종 미세조정 정확도와 직접 섞어 비교하지 않는다. 또한 attention 시각화만으로 모델 판단의 원인을 완전히 설명했다고 볼 수는 없다.
4.7. Self-supervision은 예비 실험이다
논문은 일부 패치를 가리고 복원 정보를 예측하는 자기지도 사전학습도 탐색했다. 이 설정에서 ViT-B/16은 ImageNet 정확도 79.9%를 보고하며, 처음부터 학습하는 것보다 나았지만 지도 사전학습에는 미치지 못했다.
따라서 이 논문의 높은 대표 성능을 모두 자기지도 학습의 결과로 소개하면 안 된다. 주요 실험은 지도 사전학습이며, masked patch prediction은 후속 연구 가능성을 살펴본 예비 실험이다.
5. Conclusion: 패치 표현과 대규모 학습의 조합
ViT는 이미지를 패치 시퀀스로 바꾸고 표준 Transformer encoder로 처리하는 단순한 접근이, 충분한 사전학습 규모에서 강력한 이미지 분류 성능을 낼 수 있음을 보여줬다.
이 결과를 이해할 때는 세 가지를 함께 기억할 필요가 있다.
- 구조: 패치 임베딩·위치 임베딩·class token을 통해 이미지를 시퀀스로 처리한다.
- 조건: 이미지 특화 귀납적 편향을 줄인 대신 사전학습 데이터의 규모가 중요하게 작용했다.
- 범위: 원 논문의 주된 검증 대상은 이미지 분류다. 검출·분할, 더 효과적인 자기지도 학습, 추가적인 규모 확장은 후속 과제로 제시한다.
이 논문의 메시지는 CNN이 모든 조건에서 불필요하다는 선언보다, 이미지 인식에서도 단순하고 확장 가능한 Transformer 설계가 유효한 선택지가 될 수 있다는 실증으로 읽는 편이 정확하다.
답글 남기기