Attention Is All You Need
Ashish Vaswani, Noam Shazeer, Niki Parmar, Jakob Uszkoreit, Llion Jones, Aidan N. Gomez, Łukasz Kaiser, Illia Polosukhin · NIPS 2017
핵심 요약
이 논문이 발표된 2017년의 기계 번역 연구에서는 RNN·LSTM 기반 인코더·디코더에 attention을 결합하는 방식이 널리 사용됐다. 그러나 토큰을 순서대로 처리하는 구조는 학습 병렬화와 멀리 떨어진 단어 사이의 관계 학습에 제약이 있었다. 이 논문은 순환 연산 없이 attention을 중심으로 구성한 Transformer를 제안하고, 영어·독일어와 영어·프랑스어 번역에서 성능과 학습 효율을 평가했다.
- Transformer는 문장을 순서대로 처리하는 순환 신경망의 의존성을 제거하고, attention을 중심으로 입력과 출력의 관계를 계산한다.
- 각 토큰은 다른 토큰을 참조해 자신의 표현을 갱신한다. 여러 head를 사용하면 서로 다른 표현 공간에서 관계를 동시에 계산할 수 있다.
- 위치 정보는 따로 더하고, 디코더에는 미래 정답을 보지 못하게 하는 마스크를 적용한다.
- 학습 단계의 병렬화와 출력 생성의 순차성은 구분해야 한다. 원 논문의 디코더는 여전히 토큰을 하나씩 생성한다.
- 핵심 기여는 attention의 최초 발명이 아니라, 순환·컨볼루션 기반 시퀀스 처리를 대체하는 인코더·디코더 전체 구조를 만들고 번역 성능과 학습 효율을 함께 보여준 것이다.
1. Introduction: 문장을 반드시 한 단어씩 처리해야 할까?
1.1. RNN의 구조적인 제약
당시 기계 번역에서는 입력 문장을 읽는 인코더와 번역 문장을 만드는 디코더를 RNN·LSTM·GRU로 구성하는 방식이 널리 쓰였다.
- RNN은 현재 위치의 상태를 계산할 때 이전 위치의 상태를 사용한다.
- 뒤쪽 토큰을 처리하려면 앞쪽 계산이 진행되어야 하므로, 한 문장 안의 위치들을 동시에 계산하기 어렵다.
- 멀리 떨어진 단어의 관계를 전달하려면 여러 순차 단계를 거쳐야 한다.
예를 들어 문장의 앞부분에 있는 주어가 뒷부분의 동사와 연결된다면, 그 관계를 표현하는 정보가 중간의 여러 위치를 통과해야 한다.
1.2. Attention을 중심에 놓는다는 발상
Attention은 현재 필요한 정보를 다른 위치에서 찾아 가중합하는 연산이다. Transformer 이전에도 번역 모델의 인코더와 디코더를 연결하는 데 사용되고 있었다.
이 논문은 한 걸음 더 나아간다.
문장 내부의 관계를 계산하는 역할도 attention이 맡으면, 순환 구조를 유지할 필요가 있을까?
이 질문에서 출발한 모델이 Transformer다. 서로 멀리 떨어진 위치도 직접 연결하고, 이미 주어진 시퀀스의 여러 위치를 병렬로 계산한다.
2. Background: Self-Attention이 바꾸는 정보의 이동 경로
- Self-Attention은 같은 시퀀스 안의 위치들이 서로를 참조하는 연산이다.
- RNN처럼 이웃한 시간 단계를 차례로 통과하거나, 좁은 컨볼루션 창을 여러 층 쌓아 연결 범위를 넓힐 필요가 없다.
- 한 attention 층에서 각 위치가 다른 모든 위치를 직접 참조할 수 있다.
다만 여러 위치의 정보를 가중평균하면 서로 다른 관계가 하나의 표현에 섞일 수 있다. Transformer는 이를 보완하기 위해 Multi-Head Attention을 사용한다.
3. Model Architecture: 인코더와 디코더는 어떻게 구성되는가?
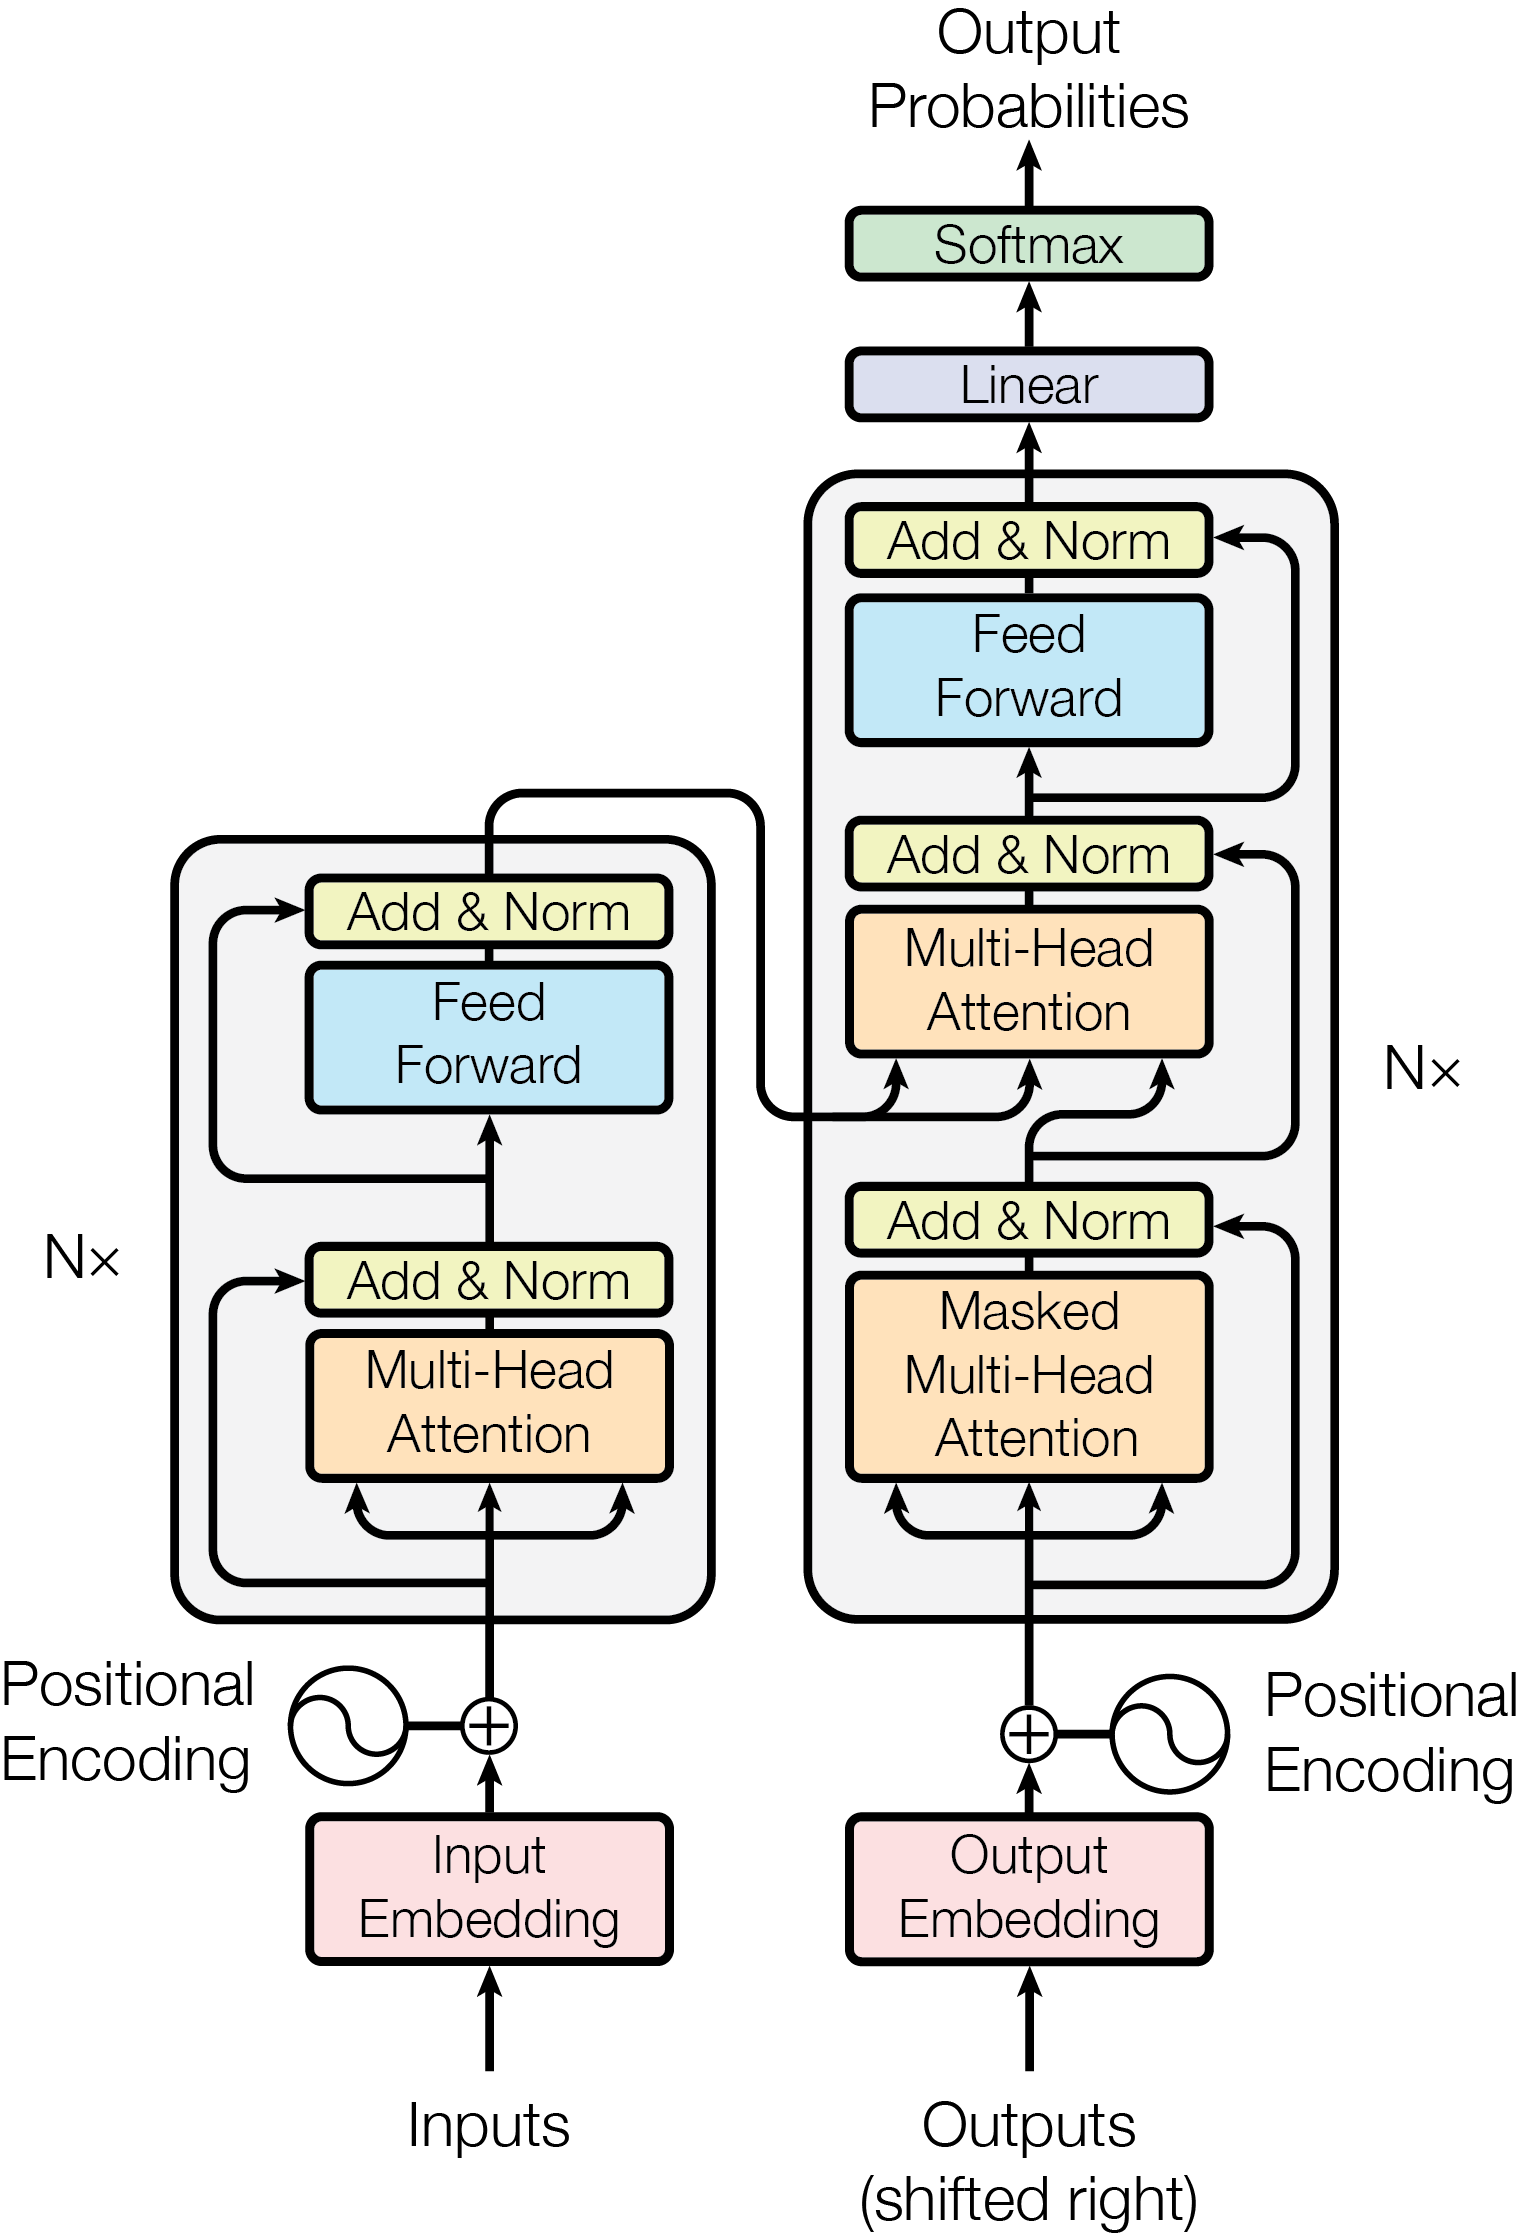
Figure 1. Transformer의 전체 구조. 왼쪽은 입력 문장을 표현하는 인코더, 오른쪽은 이전 출력과 인코더 결과를 사용해 다음 토큰을 예측하는 디코더다. 출처: Vaswani et al., Attention Is All You Need.
3.1. 전체 흐름
- 입력 토큰을 임베딩 벡터로 바꾸고 위치 인코딩을 더한다.
- 인코더가 입력 토큰 사이의 관계를 반영한 표현을 만든다.
- 디코더는 이전 출력 토큰들과 인코더 표현을 참조한다.
- 디코더의 출력에 선형 변환과 softmax를 적용해 다음 토큰의 확률을 계산한다.
- 추론에서는 선택한 토큰을 다음 단계의 입력으로 사용한다.
원 논문의 기본 모델은 인코더 6층과 디코더 6층으로 구성된다. 각 층은 같은 형태를 반복하지만 가중치까지 공유하는 구조는 아니다.
3.2. 인코더 층
각 인코더 층에는 두 개의 하위 블록이 있다.
- Multi-Head Self-Attention: 입력 시퀀스의 다른 위치에서 정보를 가져온다.
- Position-wise Feed-Forward Network: 모은 정보를 위치별 비선형 변환으로 가공한다.
각 하위 블록에는 residual connection과 layer normalization을 적용한다.
\operatorname{LayerNorm}\bigl(x+\operatorname{Sublayer}(x)\bigr)- : 하위 블록으로 들어가는 표현.
Sublayer: attention 또는 feed-forward 연산.- Residual connection: 기존 표현을 새로 계산한 결과에 더하는 연결.
- Layer normalization: 토큰 표현의 특징 차원을 정규화하는 연산.
이것이 원 논문의 Post-LN 구조다. 정규화를 하위 블록 앞에 두는 후속 모델의 Pre-LN과는 순서가 다르다. 실제 학습에서는 하위 블록 출력에 dropout을 적용한 뒤 residual을 더한다.
3.3. 디코더 층
디코더에는 attention 블록이 하나 더 있다.
- Masked Self-Attention: 현재 위치까지의 디코더 입력만 참조한다.
- Encoder-Decoder Attention: 인코더가 만든 입력 문장의 표현을 참조한다.
- Feed-Forward Network: 각 위치의 표현을 가공한다.
따라서 제목의 ‘Attention Is All You Need’를 모델 안에 attention 연산만 있다는 뜻으로 읽으면 안 된다. 임베딩, FFN, 정규화, residual connection, 출력 투영도 중요한 구성 요소다.
4. Scaled Dot-Product Attention: Q, K, V는 무엇인가?
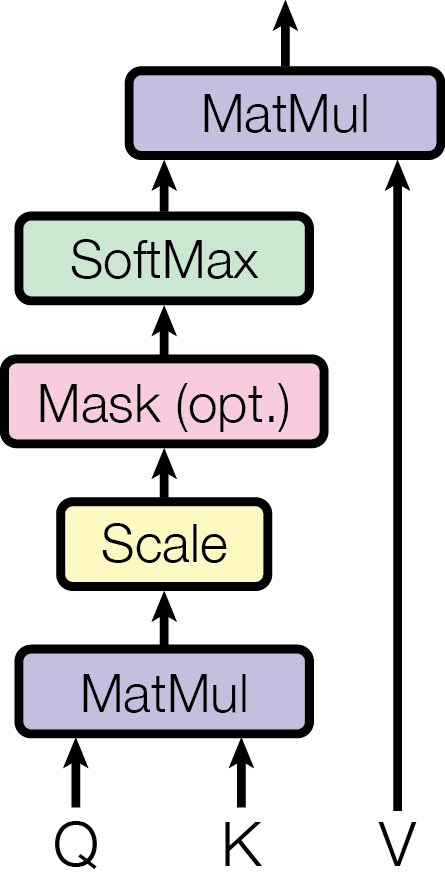
Figure 2 왼쪽. Scaled Dot-Product Attention. 아래에서 위로 내적 → 스케일 조절 → 필요한 경우 마스크 → softmax → Value 가중합 순서로 계산한다. 출처: Vaswani et al.
4.1. Query, Key, Value의 역할
| 구성 요소 | 역할 | 직관적인 설명 |
|---|---|---|
| Query(Q) | 현재 위치에서 필요한 정보를 표현 | 무엇을 찾아야 하는가 |
| Key(K) | 참조할 위치와의 관련성을 계산 | 이 위치는 어떤 정보와 관련되는가 |
| Value(V) | 실제로 모아서 전달할 정보 | 관련성이 높을 때 무엇을 가져오는가 |
Self-attention에서는 같은 입력 표현에서 Q·K·V를 만들지만, 서로 다른 학습 가능한 선형 변환을 사용한다. 같은 시퀀스에서 나왔다고 해서 세 벡터의 값이나 역할이 같은 것은 아니다.
4.2. 핵심 수식
논문의 식 (1)은 다음과 같다.
\operatorname{Attention}(Q,K,V)
=\operatorname{softmax}\left(\frac{QK^\top}{\sqrt{d_k}}\right)V
배치와 head 축을 생략하고, query 개수를 , key·value 개수를 라고 두면 행렬 크기는 다음과 같다.
| 행렬 | 크기 | 의미 |
|---|---|---|
| Query를 행으로 쌓은 행렬 | ||
| Key를 행으로 쌓은 행렬 | ||
| Value를 행으로 쌓은 행렬 | ||
| 각 query와 모든 key 사이의 점수 | ||
| Attention 출력 | 각 query가 가져온 정보 |
계산을 단계별로 풀어보면 다음과 같다.
- 로 query와 key의 내적 점수를 구한다.
- 점수를 로 나누어 크기를 조절한다.
- 각 query에 대해 key 방향으로 softmax를 적용한다.
- 얻은 가중치로 V의 행들을 더한다.
결과는 가장 높은 점수의 Value 하나를 고르는 것이 아니라, 여러 Value의 가중합이다.
4.3. 왜 key 차원의 제곱근으로 나누는가?
- Query와 key의 차원이 커지면 내적에 더 많은 항이 더해진다.
- 논문은 각 성분이 독립이고 평균 0, 분산 1이라고 가정하면 내적의 분산이 가 된다고 설명한다.
- 점수 크기가 지나치게 커지면 softmax가 한쪽으로 치우쳐 기울기가 매우 작아질 수 있다.
- 제곱근 스케일링은 차원 증가에 따른 점수 크기를 조절하려는 장치다.
이는 실제 학습 벡터가 항상 그 확률 가정을 정확히 만족한다는 주장이 아니라, 스케일링의 필요성을 설명하는 직관이다.
5. Multi-Head Attention: 여러 관점에서 관계를 계산한다
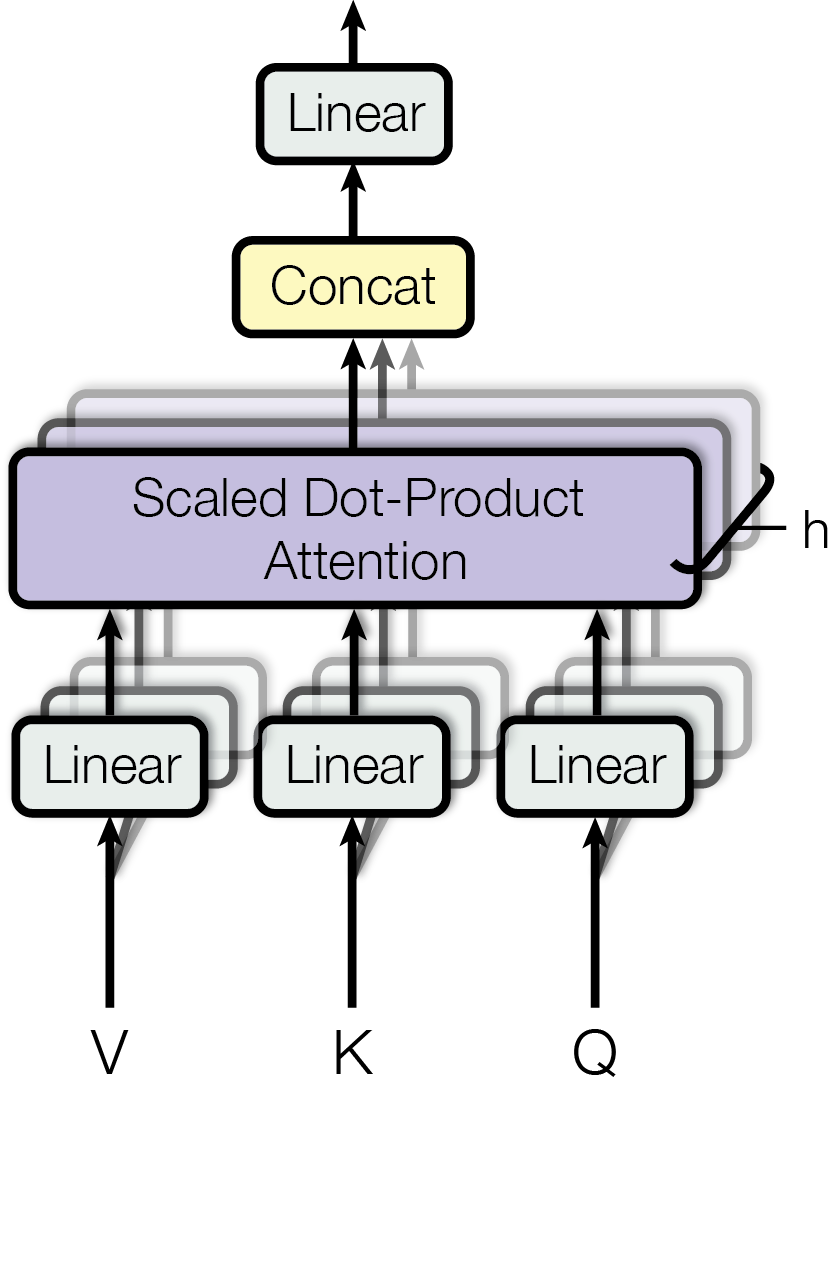
Figure 2 오른쪽. 여러 head가 각자의 Q·K·V 투영을 사용해 attention을 계산하고, 결과를 연결한 뒤 출력 차원으로 다시 투영한다. 출처: Vaswani et al.
5.1. Head별 투영과 결과 결합
하나의 큰 attention을 계산하는 대신 여러 개의 작은 표현 공간에서 attention을 계산한다.
\operatorname{head}_i
=\operatorname{Attention}(QW_i^Q,KW_i^K,VW_i^V)
\operatorname{MultiHead}(Q,K,V)
=\operatorname{Concat}(\operatorname{head}_1,\ldots,\operatorname{head}_h)W^O- : head 개수.
- : i번째 head의 학습 가능한 투영 행렬.
- : 연결된 head 출력을 모델 차원으로 바꾸는 출력 투영.
기본 모델에서는 모델 차원 512를 유지하면서 head 8개를 사용하고, head별 query·key·value 차원을 64로 둔다. 각 head가 전체 512차원으로 계산하는 것은 아니므로, head 수만큼 연산량이 단순히 배로 늘어나는 구조는 아니다.
5.2. Head마다 어떤 정보를 보게 되는가?
- 서로 다른 투영을 학습하므로 다른 위치와 다른 특징을 참조할 수 있다.
- 논문의 attention 시각화에는 먼 위치의 의존 관계나 문장 구조와 관련되어 보이는 사례가 있다.
- 다만 ‘1번 head는 주어, 2번 head는 동사를 담당한다’처럼 역할이 고정된 것은 아니다.
- Attention 가중치만으로 모델 판단의 원인이 완전히 설명된다고 단정하기도 어렵다.
5.3. 세 종류의 Attention 구분
| 위치 | Query의 출처 | Key·Value의 출처 | 참조 범위 |
|---|---|---|---|
| 인코더 self-attention | 이전 인코더 표현 | 같은 인코더 표현 | 입력 시퀀스 전체 |
| 디코더 masked self-attention | 이전 디코더 표현 | 같은 디코더 표현 | 현재 위치까지 |
| 인코더·디코더 attention | 디코더 표현 | 인코더의 최종 출력 | 입력 시퀀스 전체 |
세 경우의 계산 원리는 같고, 어디에서 Q·K·V를 가져오는지와 어떤 연결을 허용하는지가 다르다.
6. 위치, 마스크, FFN: Attention을 모델로 만드는 구성 요소
6.1. 미래 토큰을 보지 못하게 하는 마스크
학습에서는 정답 문장을 알고 있지만, 다음 토큰을 예측할 때 그 이후의 정답을 미리 보면 안 된다.
논문은 허용하지 않는 연결의 점수를 softmax 전에 음의 무한대로 만든다. 이를 마스크 행렬 M으로 풀어 쓰면 다음과 같다.
\operatorname{MaskedAttention}(Q,K,V)
=\operatorname{softmax}\left(\frac{QK^\top}{\sqrt{d_k}}+M\right)V
M_{ij}=\begin{cases}
0 & j\le i\\
-\infty & j>i
\end{cases}미래 위치의 softmax 가중치가 0이 되므로 해당 Value의 정보가 출력에 섞이지 않는다. Value를 먼저 지우는 것이 아니라 attention 점수를 마스킹한다.
6.2. Shifted Right와 학습 병렬화
디코더 입력은 예측할 정답보다 한 위치 뒤로 밀어 넣는다.
| 위치 | 디코더에 주는 입력 | 예측할 정답 |
|---|---|---|
| 1 | 시작 토큰 | 첫 번째 출력 토큰 |
| 2 | 첫 번째 출력 토큰 | 두 번째 출력 토큰 |
| 3 | 두 번째 출력 토큰 | 세 번째 출력 토큰 |
- 학습 중에는 정답의 이전 토큰을 알고 있으므로, 마스크를 적용한 여러 위치의 계산을 병렬로 수행할 수 있다.
- 추론 중에는 다음 토큰이 아직 정해지지 않았으므로, 이전까지 생성한 토큰을 사용해 순서대로 진행한다.
RNN의 위치별 상태 전달을 제거했다고 해서 문장 생성의 자기회귀 의존성까지 사라진 것은 아니다.
6.3. Positional Encoding: 순서는 따로 알려준다
토큰의 의미 벡터만으로 관계를 계산하면 입력의 순서를 충분히 표현할 수 없다. Transformer는 인코더와 디코더 입력 임베딩에 위치 인코딩을 더한다.
PE_{(pos,2i)}=\sin\left(\frac{pos}{10000^{2i/d_{\mathrm{model}}}}\right)PE_{(pos,2i+1)}=\cos\left(\frac{pos}{10000^{2i/d_{\mathrm{model}}}}\right)- : 토큰의 위치.
- : 사인·코사인 쌍을 구성하는 차원 인덱스.
- : 모델 표현의 전체 차원.
차원마다 다른 주파수의 사인·코사인을 사용해 위치를 벡터로 표현한다. 모델 차원과 같으므로 임베딩에 그대로 더할 수 있다.
논문은 고정된 위치 차이를 선형 관계로 표현할 수 있다는 점과, 학습에서 보지 못한 길이로 확장할 가능성을 선택 이유로 든다. 하지만 임의로 긴 문장에서도 성능이 유지된다는 보장은 아니다. 실험에서는 학습 가능한 위치 임베딩과 거의 비슷한 성능을 보였다.
6.4. Position-wise FFN
Attention으로 다른 위치의 정보를 모은 뒤에는 각 위치에 동일한 FFN을 적용한다. 논문의 식 (2)다.
\operatorname{FFN}(x)=\max(0,xW_1+b_1)W_2+b_2- 두 선형 변환 사이에 ReLU를 적용한다.
- 기본 모델은 512차원을 2048차원으로 넓혔다가 다시 512차원으로 줄인다.
- 같은 층 안에서는 모든 위치가 같은 FFN 가중치를 사용한다.
- 층이 달라지면 FFN의 가중치도 달라진다.
Attention이 위치 사이의 정보를 섞는다면, FFN은 각 위치의 특징을 비선형적으로 가공한다.
6.5. 임베딩과 출력 확률
- 입력 토큰과 디코더 토큰은 학습 가능한 임베딩으로 바뀐다.
- 논문은 임베딩 층의 가중치에 모델 차원의 제곱근을 곱한다.
- 디코더의 최종 표현은 선형 변환과 softmax를 거쳐 어휘별 다음 토큰 확률이 된다.
- 원 논문은 임베딩과 출력 투영의 가중치를 공유하는 구성도 사용한다.
7. Why Self-Attention: 계산 비용과 정보 전달 경로
논문은 연산량뿐 아니라 순차적으로 수행해야 하는 단계 수와 먼 위치 사이의 경로 길이를 비교한다.
| 층 종류 | 층별 복잡도 | 최소 순차 단계 | 최대 경로 길이 |
|---|---|---|---|
| Self-Attention | |||
| Recurrent | |||
| 제한된 Self-Attention |
논문 Table 1에서 발췌. n은 시퀀스 길이, d는 표현 차원, r은 참조하는 이웃 범위다.
- Self-attention은 먼 위치 사이도 직접 연결하므로 정보 전달 경로가 짧다.
- 여러 위치를 행렬 연산으로 묶어 계산할 수 있다.
- 대신 길이가 늘면 attention 점수의 크기가 제곱으로 증가한다.
표의 복잡도는 attention 연산을 비교하는 맥락이다. 실제 Transformer 블록에는 Q·K·V 선형 투영과 FFN의 계산도 있으므로 전체 비용을 이 항 하나로 설명해서는 안 된다. 또한 순차 단계가 일정하다는 말은 입력 길이가 늘어도 실행 시간이 일정하다는 뜻이 아니다.
8. Training: 어떻게 학습했는가?
8.1. 데이터와 모델 크기
| 항목 | Base | Big |
|---|---|---|
| 인코더·디코더 층 수 | 각각 6 | 각각 6 |
| 모델 차원 | 512 | 1024 |
| FFN 내부 차원 | 2048 | 4096 |
| Attention head 수 | 8 | 16 |
| 학습 step | 100,000 | 300,000 |
| 논문 보고 학습 시간 | 약 12시간 | 약 3.5일 |
| 파라미터 수 | 약 65M | 약 213M |
구조·파라미터는 Table 3, 학습 시간은 §5.2 기준. 장비는 NVIDIA P100 GPU 8개다.
- 영어·독일어 번역은 WMT 2014의 약 450만 문장 쌍을 사용한다. BPE로 약 37,000개 토큰의 공유 어휘를 구성한다.
- 영어·프랑스어 번역은 더 큰 약 3,600만 규모의 데이터와 32,000개 word-piece 어휘를 사용한다.
- 길이가 비슷한 문장 쌍을 묶어, 배치당 입력 약 25,000토큰과 출력 약 25,000토큰을 구성한다.
8.2. Warmup과 학습률
Adam을 사용하며 설정은 다음과 같다.
\beta_1=0.9,\qquad\beta_2=0.98,\qquad\epsilon=10^{-9}논문 식 (3)의 step 수를 t, warmup 길이를 w로 표기하면 학습률은 다음과 같다.
\operatorname{lr}(t)
=d_{\mathrm{model}}^{-1/2}\min\left(t^{-1/2},t\cdot w^{-3/2}\right),\qquad w=4000- 처음 4,000 step 동안은 학습률을 선형으로 높인다.
- 이후에는 step 수의 제곱근에 반비례하도록 낮춘다.
8.3. Dropout과 Label Smoothing
- Base 모델은 residual 경로에 더하기 전의 하위 블록 출력과 임베딩·위치 인코딩의 합에 dropout 0.1을 사용한다.
- Label smoothing은 정답에 확률을 지나치게 몰아주는 것을 완화하는 기법이며, 논문 설정은 0.1이다.
- 논문은 label smoothing이 perplexity에는 불리해도 정확도와 BLEU에는 도움이 되었다고 보고한다.
- Big 모델의 기본 dropout은 0.3이지만 영어·프랑스어 번역에는 0.1을 사용한다.
9. Results: 번역 성능과 구성 요소의 효과
9.1. 기계 번역 결과
| 모델 | 영어 → 독일어 BLEU ↑ | 영어 → 프랑스어 BLEU ↑ |
|---|---|---|
| GNMT + RL | 24.60 | 39.92 |
| ConvS2S | 25.16 | 40.46 |
| MoE | 26.03 | 40.56 |
| GNMT + RL Ensemble | 26.30 | 41.16 |
| ConvS2S Ensemble | 26.36 | 41.29 |
| Transformer Base | 27.30 | 38.10 |
| Transformer Big | 28.40 | 41.80 |
논문 Table 2, WMT 2014 newstest2014 테스트 결과.
- BLEU는 생성 번역과 참조 번역 사이의 n-gram 일치를 바탕으로 하는 지표다. 높을수록 좋지만 점수를 번역 정답률로 읽어서는 안 된다.
- 영어·독일어에서 Big은 표의 ConvS2S 앙상블보다 2.04 BLEU 높다.
- 영어·독일어에서는 Base도 표의 기존 모델들을 앞서지만, 영어·프랑스어 Base 점수까지 모두 우수한 것은 아니다.
- Big은 두 번역 방향 모두에서 높은 성능을 보인다.
수치 기준: 영어·프랑스어 Big은 초록과 Table 2의 41.8을 사용했다. 같은 개정본의 §6.1 설명에는 41.0도 기재되어 있어 비교표 기준을 명확히 했다.
9.2. 학습 비용과 평가 조건
- Table 2는 Base와 Big의 학습 비용을 각각 약 3.3×10¹⁸, 2.3×10¹⁹ FLOPs로 보고한다.
- 이 비용은 학습 시간·GPU 수·GPU 처리량 추정치로 산출한 값이다. 서로 다른 환경에서 직접 재측정한 동일 조건 벤치마크는 아니다.
- 테스트 결과는 Base의 마지막 5개, Big의 마지막 20개 체크포인트를 평균한 모델로 평가한다.
- 번역 추론에는 beam size 4와 length penalty 0.6을 사용한다.
여기서 체크포인트 평균은 여러 모델이 각각 예측한 결과를 합치는 앙상블과 구별된다.
9.3. Ablation: head는 많을수록 좋은가?
아래는 영어·독일어 개발 세트 newstest2013에서의 결과다. 위 테스트 점수와 구분해야 한다.
| 변경 | 개발 세트 BLEU ↑ | 읽을 수 있는 점 |
|---|---|---|
| Base: head 8개 | 25.8 | 비교 기준 |
| head 1개 | 24.9 | 단일 head에서는 성능 감소 |
| head 4개 | 25.5 | 기준보다 소폭 낮음 |
| head 16개 | 25.8 | 기준과 같은 수준 |
| head 32개 | 25.4 | 너무 늘려도 개선되지 않음 |
| FFN 내부 차원 4096 | 26.2 | FFN 용량 증가의 효과 |
| dropout 제거 | 24.6 | 정규화의 중요성 |
| 학습 가능한 위치 임베딩 | 25.7 | 사인·코사인과 거의 유사 |
논문 Table 3에서 발췌. Head 수 비교에서는 head별 차원을 함께 조절해 연산량을 맞췄으며, 개발 세트 실험에는 체크포인트 평균을 사용하지 않았다.
핵심은 ‘head가 많으면 무조건 좋다’가 아니다. 여러 표현 공간으로 나누는 이점과 head별 표현 용량 사이에서 균형이 필요하다.
9.4. 번역 외의 작업에도 적용되는가?
- 논문은 문장의 구문 트리를 예측하는 영어 constituency parsing에도 4층 Transformer를 적용한다.
- WSJ 학습 데이터만 사용하는 설정에서는 F1 91.3, 추가 데이터를 활용한 반지도 설정에서는 92.7을 보고한다.
- 구조화된 출력을 생성하는 다른 작업으로 전이할 수 있음을 보여주지만, Table 4의 모든 학습 방식과 모델을 능가한 결과는 아니다.
10. 의의와 한계: 이 논문에서 가져갈 것
10.1. 모델의 중심을 순환에서 관계 계산으로 바꿨다
- 순환 구조가 없어도 강력한 시퀀스 변환 모델을 만들 수 있음을 보였다.
- 먼 위치를 직접 참조하는 경로와 대규모 행렬 연산의 병렬성을 결합했다.
- 서로 다른 시퀀스를 연결하는 cross-attention과 같은 시퀀스를 처리하는 self-attention을 하나의 계산 틀로 정리했다.
10.2. 남는 비용과 제약
- 긴 시퀀스의 비용: 모든 위치 쌍을 비교하는 attention은 길이에 대해 제곱 비용이 든다.
- 순차적인 생성: 원형 디코더는 여전히 이전 생성 결과에 의존한다.
- 위치 표현의 필요성: 순서를 활용하려면 별도의 위치 정보를 주입해야 한다.
- 관계 시각화의 한계: attention map이 직관적인 패턴을 보여도 그것만으로 모델의 전체 동작을 설명할 수는 없다.
논문은 결론에서 이미지·음성·비디오로의 확장과, 큰 입력을 효율적으로 다루기 위한 제한된 attention, 덜 순차적인 생성을 후속 방향으로 제시한다.
10.3. 원 논문과 후속 모델을 구분해서 읽기
이 글에서 다룬 것은 2017년의 인코더·디코더 Transformer다. 모든 현대 모델이 인코더 6층·디코더 6층, ReLU, 사인·코사인 위치 인코딩, Post-LN을 그대로 사용한다는 뜻은 아니다.
해석: 이 논문의 중요한 변화는 새로운 연산 하나보다 계산 구조의 재배치에 있다. 토큰을 순서대로 전달하던 경로를 학습 가능한 관계 계산으로 바꾸고, 그 위에 위치·마스크·정규화·FFN을 조합해 실제로 학습할 수 있는 모델을 완성했다.
답글 남기기