[태그:] Attention
-
[논문정리] Axial Attention: 축별 attention으로 이미지 전체 문맥을 연결하는 Transformer
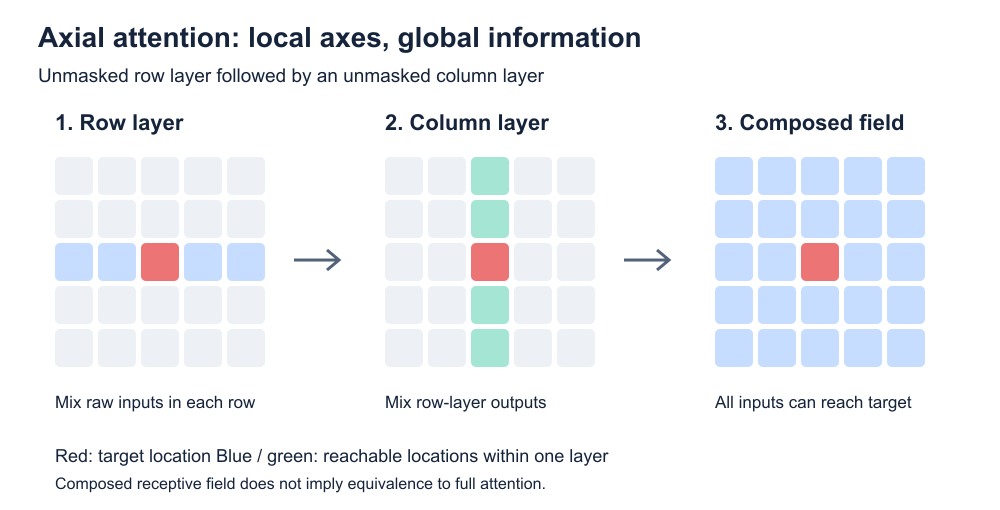
논문: Axial Attention In Multidimensional Transformers 저자: Jonathan Ho, Nal Kalchbrenner, Dirk Weissenborn, Tim Salimans 발표: 2019년, arXiv 1912.12180v1 원문: 논문 읽기 1. 핵심 요약: 전체를 보되, 한꺼번에 연결하지 않는다 이미지·영상 생성에서는 멀리 떨어진 픽셀 사이의 관계를 이해해야 한다. Self-attention(자기 주의)은 이를 직접 연결할 수 있지만, 이미지를 긴 토큰열로 펼치면 위치 수에 대해 계산량이 제곱으로…
-
[논문 정리] Attention Is All You Need: Transformer의 구조와 핵심 원리
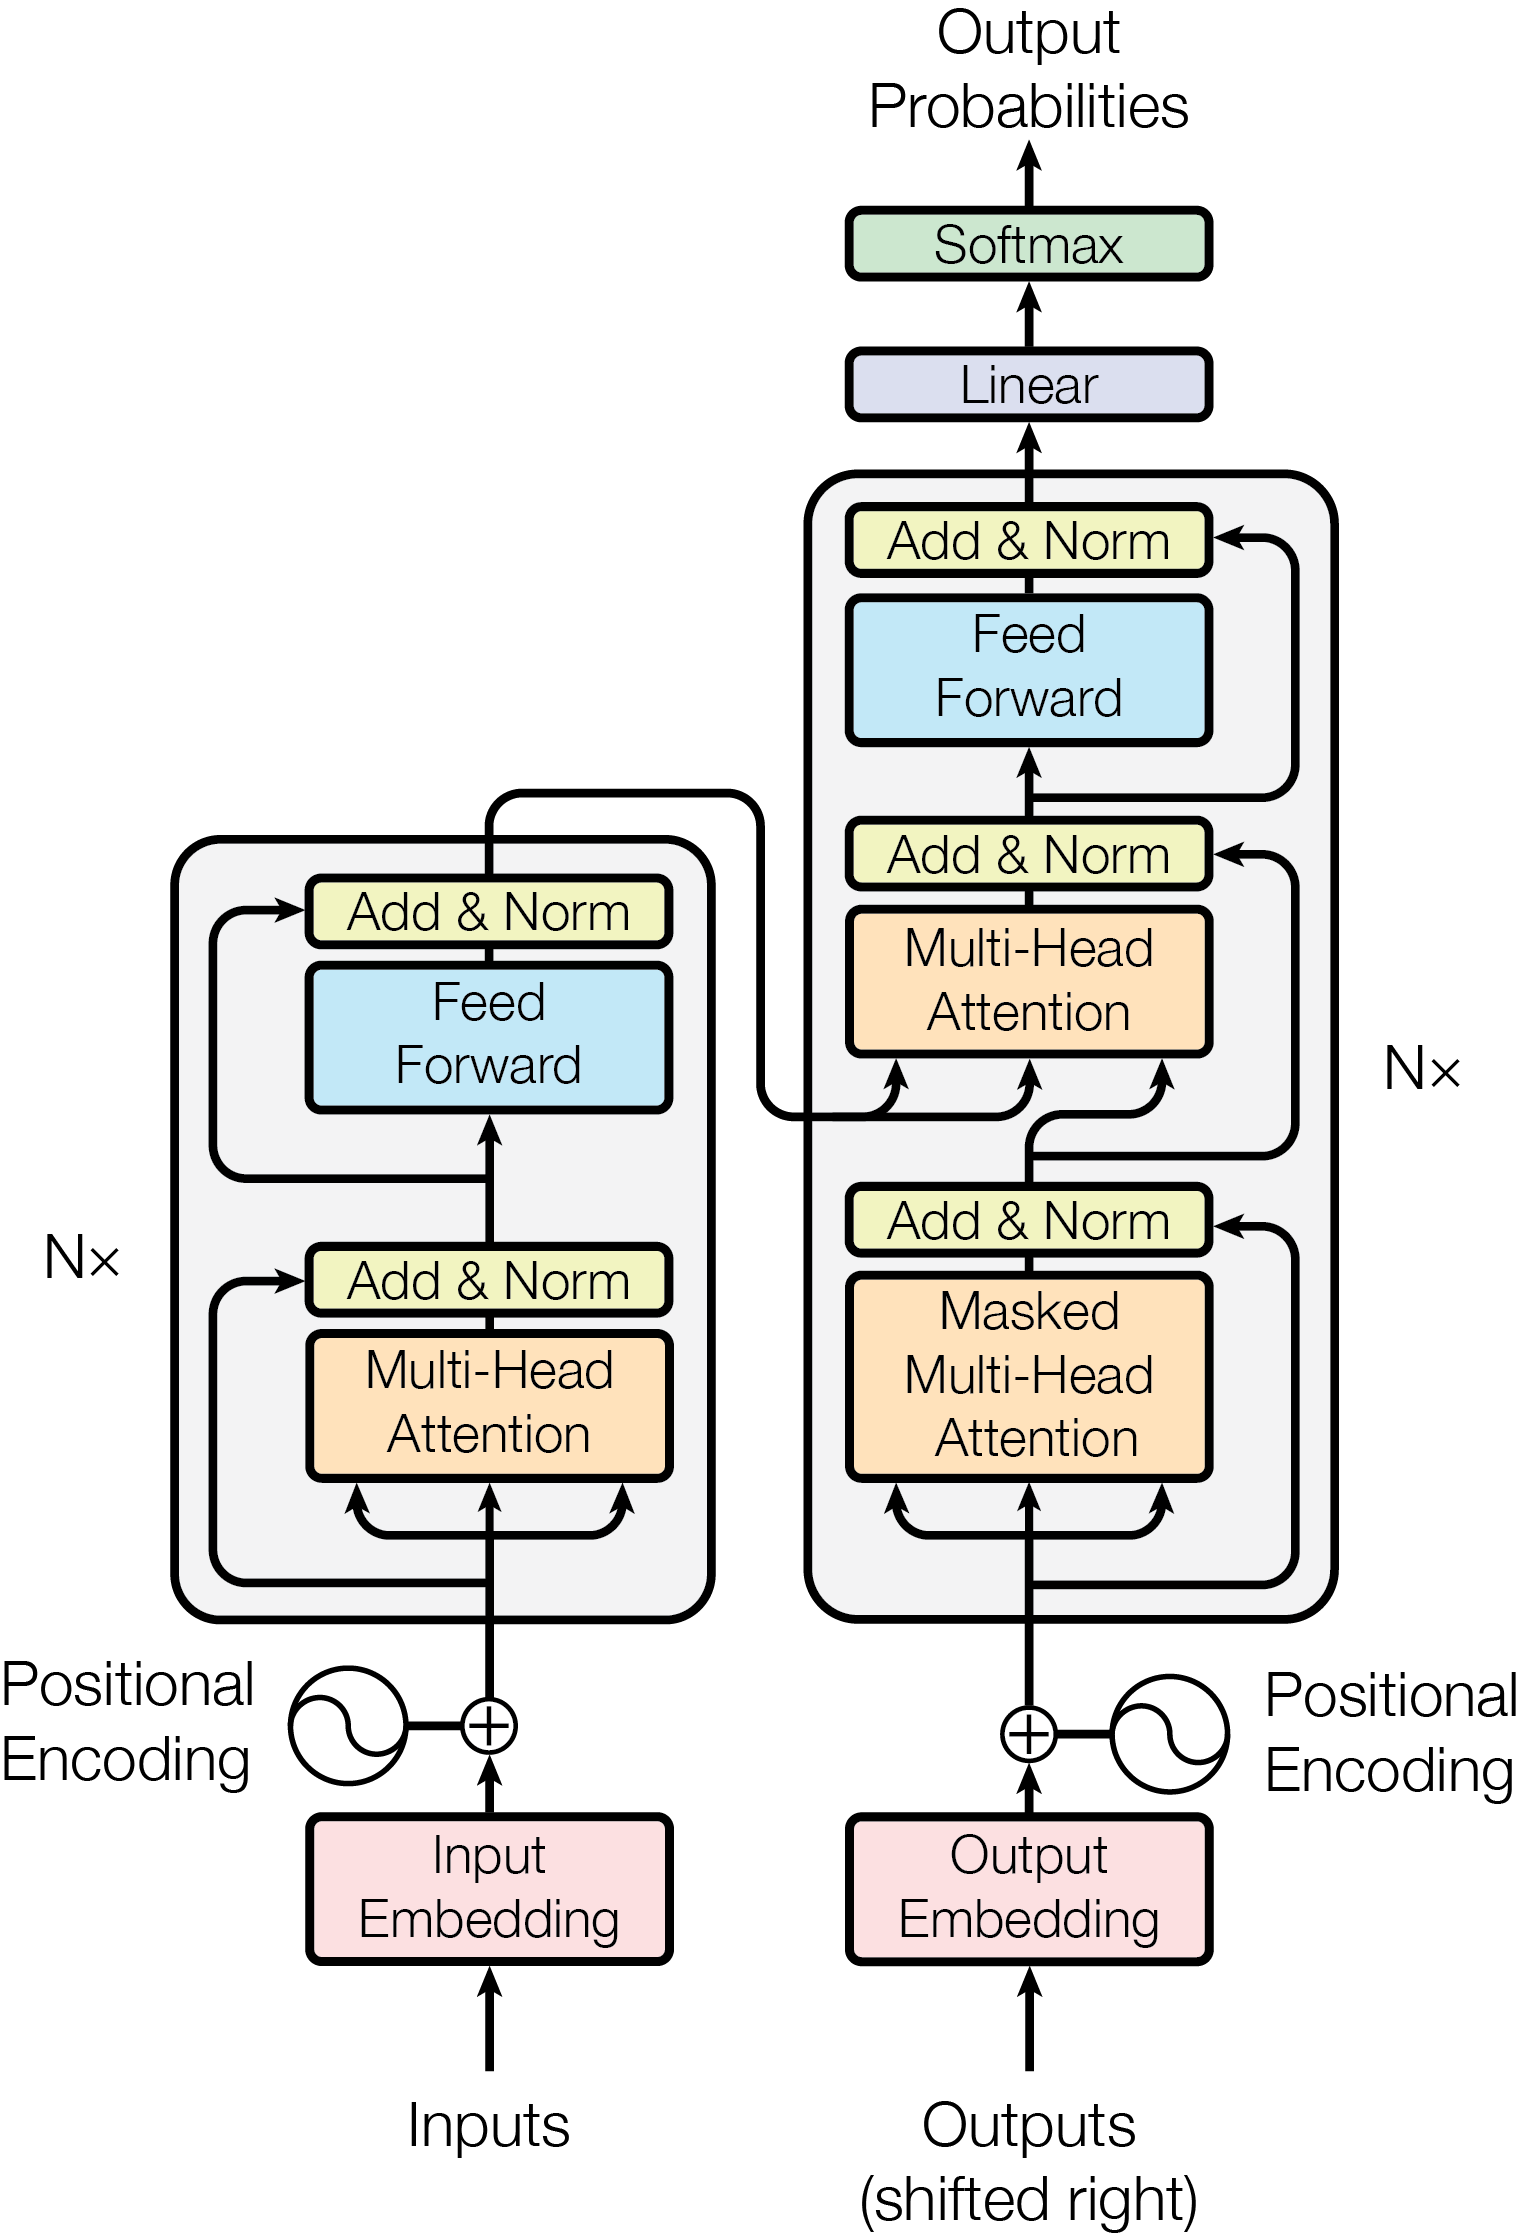
Attention Is All You Need Ashish Vaswani, Noam Shazeer, Niki Parmar, Jakob Uszkoreit, Llion Jones, Aidan N. Gomez, Łukasz Kaiser, Illia Polosukhin · NIPS 2017 논문 · 본문 · 공식 구현 핵심 요약 이 논문이 발표된 2017년의 기계 번역 연구에서는 RNN·LSTM 기반 인코더·디코더에 attention을 결합하는 방식이 널리 사용됐다. 그러나 토큰을 순서대로 처리하는 구조는 학습 병렬화와…