논문: Axial Attention In Multidimensional Transformers
저자: Jonathan Ho, Nal Kalchbrenner, Dirk Weissenborn, Tim Salimans
발표: 2019년, arXiv 1912.12180v1
원문: 논문 읽기
1. 핵심 요약: 전체를 보되, 한꺼번에 연결하지 않는다
이미지·영상 생성에서는 멀리 떨어진 픽셀 사이의 관계를 이해해야 한다. Self-attention(자기 주의)은 이를 직접 연결할 수 있지만, 이미지를 긴 토큰열로 펼치면 위치 수에 대해 계산량이 제곱으로 늘어난다. 이 논문은 이미지의 격자 구조를 유지하고 가로축과 세로축으로 attention을 나누는 axial attention을 제안한다. 각 층의 연결은 줄이되 층 사이로 정보를 전달해 전체 문맥에 접근하는 방법이다.
- 축별 계산: 같은 행 또는 같은 열에 속한 위치끼리만 attention을 수행한다. 다른 축을 보는 층을 이어 붙이면 전체 이미지로 정보가 퍼진다.
- 인과적인 생성: 위쪽 행의 문맥을 모으는 outer decoder와 현재 행을 순차 생성하는 inner decoder를 분리한다. 아직 생성하지 않은 픽셀을 보지 않으면서 이전 픽셀 전체에 접근한다.
- 반병렬 처리: 무거운 위쪽 문맥 계산을 행 단위로 재사용한다. 모든 픽셀을 동시에 만드는 방식은 아니다.
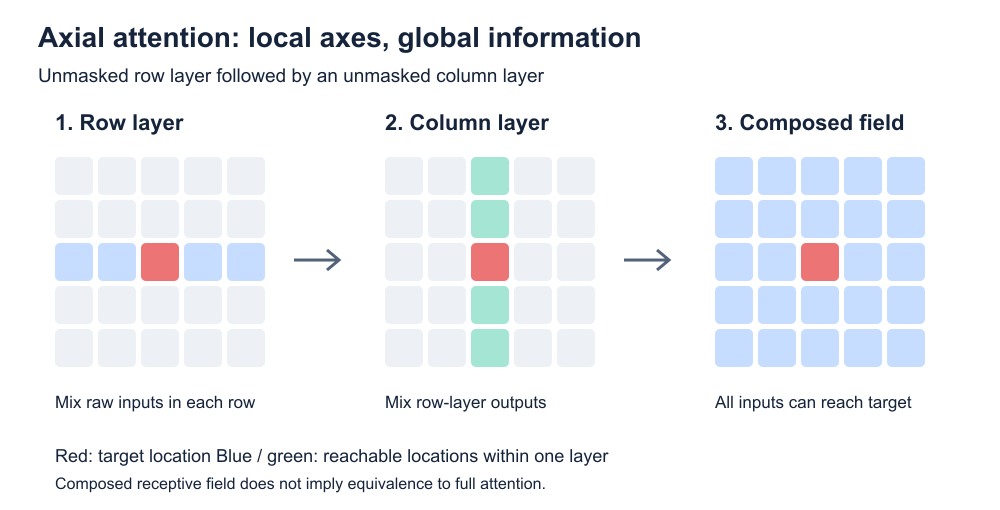
그림 1. §3.1을 바탕으로 직접 그린 설명도. 비마스킹 행 attention과 열 attention을 차례로 적용했을 때의 정보 전달을 보여준다. 실제 자기회귀 생성에는 뒤에서 설명할 마스크와 이동 연산이 필요하다.
2. Axial attention: 격자의 축을 짧은 시퀀스로 쓴다
높이와 너비가 각각 인 단일 채널 이미지에서 전체 위치 수를 라고 하자. Full attention은 전체 위치 쌍을 비교하지만, 행 attention은 길이 인 시퀀스 개를 각각 처리한다. 특징 차원과 head 수를 고정하고 attention의 위치 간 계산을 비교하면 다음과 같다.
\text{Full attention}: O(N^2),\qquad
\text{Axial attention}: O(S\cdot S^2)=O(N\sqrt{N})
행 attention 뒤에 열 attention을 적용해도 같은 차수다. 예를 들어 한 열의 각 위치는 이미 자기 행 전체의 정보를 담고 있으므로, 그 열을 따라 정보를 모으면 모든 행에서 온 정보가 하나의 출력 위치에 도달할 수 있다. 여기서 receptive field(수용 영역)는 출력이 영향을 받을 수 있는 입력 범위를 뜻한다.
다만 전역 수용 영역이 생긴다는 것과 full attention 한 층과 동일한 계산을 한다는 것은 다르다. 정보는 중간 표현을 거쳐 전달되며, 계산량도 선형이 아닌 초선형으로 남는다. 위 비교는 attention 부분의 점근적 분석이지 네트워크 전체의 실측 실행 시간을 뜻하지 않는다.
구현은 특별한 희소 행렬 커널 없이도 가능하다. attention할 축 외의 축들을 배치 차원으로 묶어 표준 attention을 실행하고 원래 모양으로 되돌린다. 이 단순한 구현 방식도 논문의 주요 장점이다.
3. Axial Transformer: 미래 픽셀을 보지 않고 전체 과거를 읽는다
이 논문은 축별 attention을 자기회귀 생성 모델로 확장한다. 단일 채널 이미지를 위에서 아래로, 각 행에서는 왼쪽에서 오른쪽으로 생성할 때 필요한 조건부 분포는 다음과 같다. 여기서 는 행, 는 열이다.
p(x)=\prod_{i=1}^{H}\prod_{j=1}^{W}
p(x_{i,j}\mid x_{<i,:},x_{i,<j})
현재 픽셀은 위쪽 모든 행과 같은 행의 왼쪽 픽셀에 의존할 수 있어야 한다. 단순히 행과 열 attention을 교대로 적용하면 오른쪽·아래쪽의 정답 정보가 새어 들어갈 수 있으므로, 모델을 두 부분으로 나눈다.
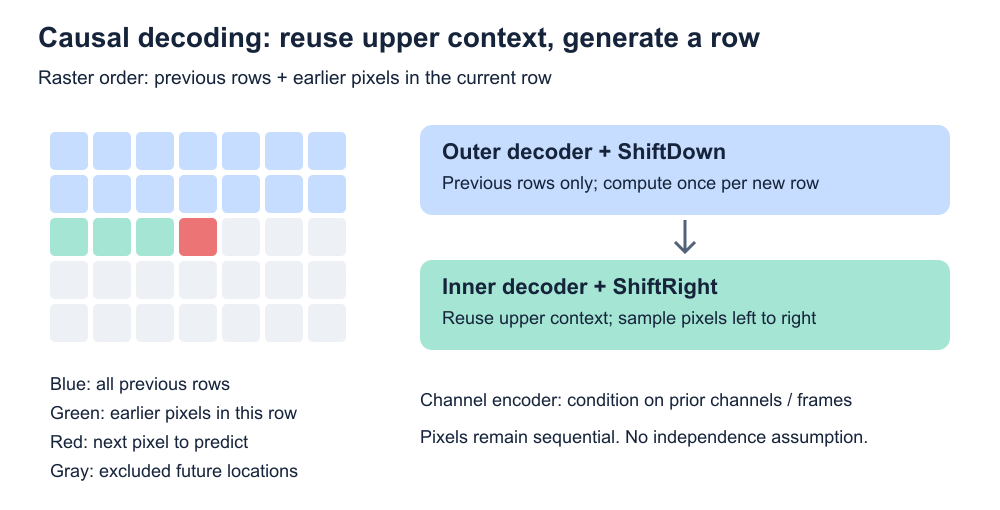
그림 2. §3.2.1을 바탕으로 직접 그린 설명도. 파란색은 위쪽 행, 초록색은 현재 행의 왼쪽, 빨간색은 예측 대상이다. 회색 위치는 아직 조건으로 쓸 수 없다.
Outer decoder: 위쪽 행들의 문맥
Outer decoder는 비마스킹 행 attention으로 각 행의 좌우 정보를 모으고, 마스킹 열 attention으로 현재 행과 그 위쪽 행들의 정보를 모은다. 이후 이 표현을 한 행 아래로 이동하는 ShiftDown을 적용한다. 이동 후 현재 행이 받는 표현에는 위쪽 행의 정보만 남는다.
위쪽 행에서는 오른쪽 열에 있는 픽셀까지 보아도 된다. 현재 픽셀을 생성할 시점에는 이전 행 전체가 이미 생성되어 있기 때문이다.
Inner decoder: 현재 행의 왼쪽 문맥
Inner decoder는 현재 행에서 왼쪽에 있는 픽셀들을 읽는다. 입력 임베딩을 한 칸 오른쪽으로 이동하는 ShiftRight와 마스킹 행 attention을 함께 써서 현재 정답 픽셀을 제외한다. 두 문맥이 만나는 입력을 원문의 연산에 맞춰 간단히 쓰면 다음과 같다.
h_{\mathrm{in}}=\mathrm{ShiftDown}(u)
+\mathrm{ShiftRight}(h)+E는 outer decoder가 만든 표현, 는 픽셀 임베딩, 는 위치 임베딩이다. 이 입력을 masked row attention으로 처리해 픽셀 값의 확률을 예측한다. 마스크만이 아니라 이동 연산까지 함께 있어야 현재 픽셀의 누출을 막을 수 있다.
컬러 이미지와 영상은 이전 채널·프레임을 별도 encoder로 처리해 추가 조건으로 넣는다. 각 채널은 앞서 생성된 채널들을 조건으로 하는 단일 채널 이미지처럼 생성하므로, 공간축의 attention 길이를 채널·시간 수만큼 직접 늘리는 방식을 피한다.
4. 반병렬 생성: 순차적인 부분을 작게 남긴다
픽셀 하나를 생성할 때마다 전체 네트워크를 다시 계산하면 매우 비싸다. 이 구조에서는 한 행을 시작할 때 위쪽 문맥을 계산해 두고, 그 행을 생성하는 동안 현재 행의 inner decoder만 반복 실행할 수 있다.
- 이전 채널·프레임은 encoder로 처리해 둔다.
- 새 행을 시작할 때 이전 행들의 문맥을 outer decoder로 계산한다.
- 그 문맥을 재사용하며 현재 행의 픽셀을 왼쪽부터 순차 생성한다.
따라서 반병렬이라는 말은 문맥 계산을 병렬화하고 재사용한다는 뜻이다. 픽셀 사이에 독립성을 가정해 한꺼번에 샘플링하는 방식이 아니다. 저자의 속도 분석도 매 픽셀마다 전체 모델을 재평가하는 단순 구현과의 비교이므로, 현대의 캐시·최적화 구현 대비 실측 배속으로 읽어서는 안 된다.
5. 실험: 이미지에서는 경쟁력, 영상에서는 뚜렷한 개선
평가 지표인 bits/dim은 데이터의 각 차원을 설명하는 데 필요한 평균 비트 수로, 낮을수록 높은 likelihood(가능도)를 뜻한다. 아래는 저자가 보고한 결과이며 직접 재현한 값은 아니다.
이미지 생성
| 모델 | ImageNet-32 | ImageNet-64 |
|---|---|---|
| PixelSNAIL | 3.80 | 3.52 |
| SPN | 3.79 | 3.52 |
| Image Transformer | 3.77 | 미보고 |
| Strided Sparse Transformer | 미보고 | 3.44 |
| Axial Transformer + LSTM inner decoder | 3.77 | 3.46 |
| Axial Transformer | 3.758 | 3.439 |
출처: 원문 Table 2. Axial 행은 괄호 안의 더 정밀한 값을 사용했다. 원문은 무조건부·클래스 조건부 결과를 함께 수록하며, 동일한 모델 크기·학습 예산으로 통제한 비교표는 아니다.
ImageNet-32에서는 비교표 중 가장 낮은 값을 기록했다. ImageNet-64의 3.439는 Sparse Transformer의 3.44와 보고 정밀도상 거의 같은 수준이므로, 큰 폭의 개선이라고 해석하기 어렵다.
실험의 Axial Transformer는 encoder 8층, outer decoder 8층, inner decoder 4층, hidden size 2048과 16개 attention head를 사용했다. 약 20만 스텝 학습했으며, 저자는 ImageNet-32에서 과적합이 가능하다고 보고했다. 계산 구조가 효율적이라는 말이 작은 모델이라는 뜻은 아니다.
영상 생성
| 모델 | BAIR bits/dim | 입력 조건 |
|---|---|---|
| VideoFlow | 1.87 | 이전 3프레임 |
| Video Transformer | 1.35 | 이전 1프레임 |
| Axial Transformer | 1.29 | 이전 1프레임 |
출처: 원문 Table 3. 다음 15프레임을 모델링한다. VideoFlow는 입력 프레임 수가 달라 같은 조건의 직접 비교로 볼 수 없다.
같은 1프레임 조건인 Video Transformer와 비교하면 1.35에서 1.29로 낮아졌다. 별도의 복잡한 영상 전용 구조 없이 채널·프레임 조건부 설계를 확장해 얻은 결과라는 점이 중요하다.
구성 요소 분석에서는 inner decoder를 단일 LSTM으로 바꾸어도 비교적 좋은 결과를 얻었지만, 표의 기본 Axial 모델보다 likelihood가 나빠지고 학습도 느려졌다. 위쪽 문맥을 잘 만드는 것과 현재 행을 효율적으로 처리하는 것 모두 성능에 기여한다는 근거다.
6. 의의와 한계
이 논문의 의의는 전역 정보를 쓰기 위해 모든 위치를 직접 연결할 필요는 없다는 점을 구체적인 생성 구조로 보여준 데 있다. 축별 정보 전달, 미래 정보 누출을 막는 마스크와 이동, 반복되는 문맥의 재사용이 한 설계 안에서 맞물린다.
읽을 때는 다음 범위를 구분해야 한다.
- 전체 과거에 접근 가능하다는 것은 완벽한 표현을 보장하지 않는다. 구조적으로 이전 위치를 배제하지 않는다는 뜻이지, 유한한 크기의 모델이 모든 분포를 정확히 표현한다는 증명은 아니다.
- 생성은 여전히 순차적이다. 문맥 계산 비용을 줄였지만 픽셀·행·채널의 생성 순서가 사라진 것은 아니다.
- 결과는 2019년 당시의 벤치마크다. 낮은 bits/dim을 지각적 화질이나 오늘날 이미지 생성 모델 전반의 우위로 확대할 수 없다.
결국 핵심은 attention 수식을 바꾸는 것이 아니라, 데이터 구조에 맞춰 연결 경로와 계산 시점을 설계하는 것이다.
답글 남기기