Cosmos 3: Omnimodal World Models for Physical AI
NVIDIA · 2026년 기술 보고서 · 보고서 표기일: 2026년 6월 22일
기술 보고서 · 공식 프로젝트 · 모델 모음 · 공식 코드
핵심 요약
로봇이 식탁을 치우려면 물체를 알아보는 것만으로는 부족하다. 어떤 순서로 움직일지 판단하고, 팔을 움직였을 때 장면이 어떻게 달라질지 예상하며, 실제 제어 명령까지 만들어야 한다. 기존에는 장면 이해 모델, 영상 생성 모델, 행동 모델을 따로 연결하는 경우가 많았다. Cosmos 3는 언어·이미지·영상·오디오·행동을 하나의 모델 구조에서 다루면, 이해한 내용을 미래 장면과 행동 예측으로 더 자연스럽게 연결할 수 있는가를 탐구한다.
- 문장은 다음 토큰을 하나씩 예측하고, 이미지·영상·오디오·행동은 노이즈를 제거하는 방식으로 생성한다. 서로 다른 생성 원리를 Mixture-of-Transformers(MoT) 구조 안에서 연결한다.
- 행동도 핵심 모달리티다. 행동을 주고 미래 영상을 예측하거나, 영상을 보고 행동을 추정하거나, 행동과 미래 영상을 함께 생성할 수 있다.
- 대규모 일반 데이터로 시작한 뒤 물리적 상호작용·제어 데이터를 추가하고, 이미지 생성이나 로봇 정책처럼 특정 용도에 맞게 후속 학습한다.
- 여러 벤치마크에서 좋은 결과를 보이지만, 기본 모델·전문 체크포인트·추론 보조 절차의 성과를 구분해야 한다. 그럴듯한 영상 생성이 정확한 물리 시뮬레이션을 보장하는 것도 아니다.
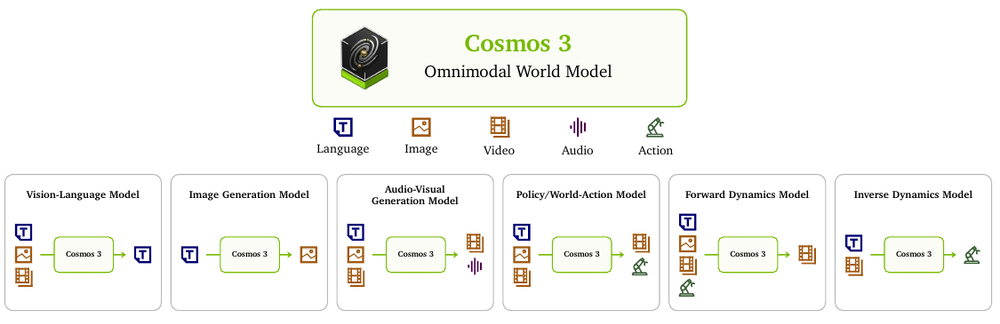
Figure 1. 같은 모델 구조에서 입력과 출력의 조합을 바꿔 서로 다른 과제를 구성한다. 출처: NVIDIA, Cosmos 3 기술 보고서 p.5. 그림 영역을 발췌했다.
1. Introduction: 세상을 이해하는 모델과 움직이는 모델을 왜 합칠까?
Physical AI는 로봇이나 자율주행 시스템처럼 물리적 환경을 관찰하고 그 안에서 행동하는 AI를 가리킨다. 이런 시스템에서 이해와 예측은 긴밀하게 연결된다. 컵이 어디 있는지 알아야 집을 수 있고, 컵을 기울이면 무엇이 일어날지 예상해야 적절한 행동을 고를 수 있다.
Cosmos 3가 말하는 월드 모델은 이 관계를 데이터에서 학습하는 모델이다. 관찰한 장면에 설명이나 행동 조건을 주고, 이후의 관찰과 행동을 생성한다. 단순히 보기 좋은 동영상을 만드는 데서 더 나아가 어떤 행동이 어떤 장면 변화와 연결되는지를 함께 다루려는 것이다.
통합의 의미도 구체적으로 볼 필요가 있다. 모든 데이터를 같은 방식으로 토큰화하거나 모든 가중치를 공유하는 설계는 아니다. 모달리티별 입출력 변환과 이해·생성 전용 경로를 두되, 공통된 시퀀스 구성과 어텐션을 통해 연결한다.
2. MoT 구조: 문장은 순서대로, 영상과 행동은 함께 다듬는다
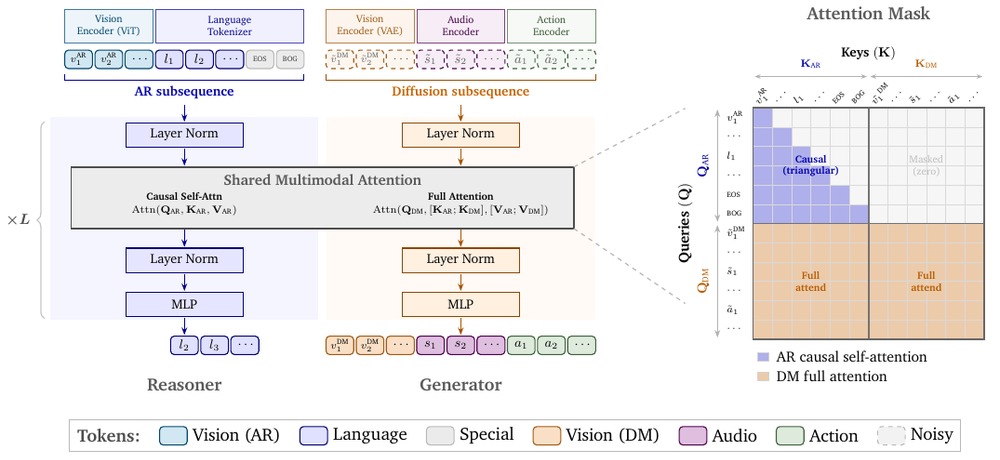
Figure 5. 왼쪽은 Reasoner와 Generator의 레이어 구조, 오른쪽은 어텐션 마스크다. Generator는 두 경로의 정보를 참조하지만 Reasoner는 생성 중인 확산 토큰을 참조하지 않는다. 출처: 보고서 p.11.
2.1. 이해용 표현과 생성용 표현을 나눈다
이미지를 읽고 질문에 답할 때와 이미지를 만들어 낼 때 필요한 표현은 다르다. Cosmos 3는 이를 위해 시각 입력에 두 인코더를 사용한다.
- 이해 경로: ViT가 이미지·영상 특징을 추출한다. 이 특징과 언어 토큰을 Reasoner가 읽어 설명·질문 응답·위치 추론 등을 수행한다.
- 생성 경로: VAE가 이미지·영상을 압축된 연속 표현으로 바꾼다. Generator는 이 잠재 표현을 생성하고, 디코더가 실제 이미지나 영상으로 변환한다.
- 오디오·행동: 각각의 인코더와 투영층을 통해 생성 경로에 들어간다. 행동은 로봇이나 차량 등 몸체의 종류에 맞는 입출력 변환을 사용한다.
Reasoner는 앞선 문맥을 바탕으로 다음 토큰을 생성하는 자기회귀 경로다. Generator는 이미지·영상·오디오·행동의 연속 토큰을 반복적으로 다듬는 확산 경로다. 두 경로는 정규화층·어텐션 투영·MLP의 가중치를 별도로 가진다.
2.2. 연결은 비대칭이다
Reasoner의 토큰은 자기회귀 시퀀스 내부의 이전 토큰만 볼 수 있다. 반면 Generator의 토큰은 Reasoner의 문맥과 생성 경로의 다른 토큰을 함께 참조한다. 영상·오디오·행동 사이의 관계는 생성 경로 내부의 양방향 어텐션으로 연결된다.
따라서 ‘통합 모델’이라고 해서 모든 토큰이 서로를 무제한 참조하는 것은 아니다. 언어 이해 경로를 안정적으로 유지하면서, 생성 경로가 그 의미 정보를 활용하도록 만든 비대칭 결합이다. 생성 중 조건이 바뀌지 않는 경우에는 Reasoner의 결과를 한 번 계산해 캐시하고 여러 확산 스텝에서 재사용할 수도 있다.
2.3. 같은 시간의 영상·소리·행동을 맞춘다
영상 프레임, 오디오 토큰, 로봇 제어 명령은 서로 다른 빈도로 만들어진다. 토큰 번호가 같다는 이유만으로 같은 시점이라고 보면, 물체가 충돌하는 순간과 소리가 나는 순간이 어긋날 수 있다.
Cosmos 3는 시간·높이·너비를 표현하는 3차원 MRoPE 위치 임베딩을 확장해, 각 모달리티의 시간 좌표를 실제 시간 간격에 맞춘다. 영상의 FPS가 달라지면 시간 좌표 간격도 바뀌고, 오디오·행동은 같은 시간축에 정렬된다. 이는 단순히 프롬프트에 “24 FPS”라고 적는 것과 별개로 모델 내부에 시간 정보를 넣는 장치다.
모델 크기는 보고서 기준으로 Edge 4B, Nano 16B, Super 64B다. Nano와 Super는 각각 Qwen3-VL 8B·32B 계열을 바탕으로 두 경로를 구성한다. Nano 전체가 8B인 것은 아니다. 보고서가 공개 대상으로 명시한 기본 모델은 Nano와 Super이며, Edge는 당시 후속 공개 예정이었다.
3. 행동을 토큰으로 만들면 무엇이 가능해질까?
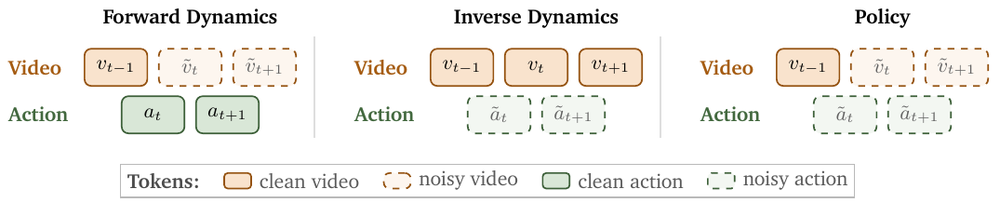
Figure 4. 실선은 관측된 조건, 점선은 노이즈에서 생성할 대상이다. 어떤 토큰을 조건으로 두는지에 따라 학습 과제가 달라진다. 출처: 보고서 p.10.
| 모드 | 주어지는 정보 | 생성하는 정보 | 풀려는 질문 |
|---|---|---|---|
| 정방향 동역학: Forward Dynamics | 현재 관찰 + 행동 | 미래 영상 | 이렇게 움직이면 장면이 어떻게 변할까? |
| 역방향 동역학: Inverse Dynamics | 관찰된 영상 변화 | 행동·이동 궤적 | 이 변화를 설명하는 움직임은 무엇일까? |
| 정책: Policy | 현재 관찰 + 지시 등의 조건 | 행동 + 미래 영상 | 어떻게 움직이고, 그 결과 무엇을 보게 될까? |
핵심은 세 가지를 각각 별개의 네트워크로만 구현하지 않는다는 점이다. 같은 영상·행동 데이터에서도 관측된 토큰과 예측할 토큰을 바꿔 다른 학습 방향을 만든다. 정책 모드에서는 행동과 예상 영상이 함께 생성되어, 움직임과 그 결과를 연결하는 학습 신호를 얻는다.
몸체마다 제어 형식이 다르다는 문제는 공통적인 기하 구조로 풀어낸다. 카메라나 차량의 이동, 로봇 말단 장치의 이동은 위치·회전 변화로 표현하고, 손가락이나 그리퍼 상태를 추가한다. 여러 길이의 벡터는 몸체별 투영층을 거쳐 공통 백본에 들어간다.
이때 일반 행동 학습의 포즈 변화는 저수준 모터 명령 그 자체가 아니라 상태 차이에서 만든 의사 행동(pseudo-action)이다. 실제 로봇 정책에는 해당 플랫폼의 관측·관절 명령·제어기에 맞춘 후속 학습이 필요하다.
4. 학습: 먼저 이해를 배우고, 생성과 제어를 확장한다
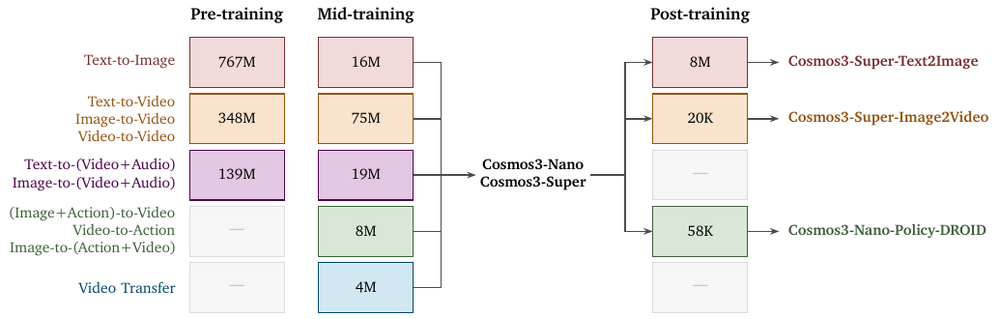
Figure 8. 중간 학습에서 기본 Nano·Super 모델을 얻고, 이후 용도별로 독립적인 전문 모델을 만든다. 수치는 단계별 데이터 샘플 규모이며, 오디오가 포함된 영상처럼 겹치는 집합도 있다. 출처: 보고서 p.20.
4.1. Reasoner를 준비한 뒤 Generator를 학습한다
먼저 이미지·영상·언어 데이터로 Reasoner를 학습하고, 로봇·자율주행·공간 이해 과제로 미세조정한다. 이후 학습된 Reasoner 가중치로 Generator를 초기화한다. 생성기 사전학습에서는 Reasoner 경로를 고정하고 생성 전용 가중치를 갱신한다.
Generator의 학습은 다음 흐름으로 진행된다.
- 사전학습: 이미지·영상·오디오에서 일반적인 생성 능력을 배운다. 보고서는 이미지 7억 6,700만 장과 영상 클립 약 3억 4,770만 개를 사용했다고 설명한다. 사용 가능한 오디오가 있는 약 1억 3,890만 클립은 이 영상 풀에서 나온 부분집합이다.
- 중간 학습: 물리적 상호작용·로봇·주행 장면을 강화하고 행동과 제어 조건을 추가한다. 행동 데이터는 약 840만 에피소드·6만 1,300시간이다. 경계선·깊이·분할 지도 등의 조건을 영상으로 바꾸는 transfer 과제도 포함한다.
- 후속 학습: 이미지 생성, 이미지 기반 영상 생성, DROID 로봇 정책처럼 목적을 좁혀 전문 체크포인트를 만든다. 구조는 이어받지만 같은 기본 모델의 결과와 구분해야 한다.
실제 영상만으로 드문 충돌·변형·로봇 상호작용을 충분히 모으기 어려워, 물리 시뮬레이션·로봇·주행·사람·창고의 다섯 합성 데이터 계열도 활용한다. 다만 합성 데이터가 모든 영역에 이득을 준 것은 아니다. 부록 C의 ablation에서는 사람 관련 점수가 모든 합성 데이터 설정에서 내려갔으며, 저자들은 현실과 합성 영상 사이의 차이를 원인으로 해석한다.
4.2. 생성 목표는 픽셀을 한 번에 맞히는 것이 아니다
Generator는 rectified flow matching으로 학습한다. 깨끗한 잠재 표현에 가우시안 노이즈를 섞고, 그 둘을 연결하는 경로의 속도를 예측하게 한다. 보고서 §4.2의 핵심 관계는 다음과 같다.
x_\sigma=(1-\sigma)x_0+\sigma\epsilon,
\qquad v^*=\epsilon-x_0
여기서 x₀는 깨끗한 이미지·영상·오디오·행동의 잠재 표현, ε은 노이즈, σ는 노이즈 수준이다. 모델은 조건과 노이즈 수준을 보고 목표 속도에 가까운 값을 출력하도록 학습하며, 생성 시에는 노이즈 쪽에서 데이터 쪽으로 경로를 따라간다. 이미 주어진 첫 프레임 같은 조건 토큰은 생성 손실에서 제외한다.
여러 해상도와 길이를 함께 학습하기 위해 서로 다른 샘플을 74,000토큰 길이의 학습 시퀀스에 채워 넣는 패킹도 사용한다. 이 값은 학습 배치를 구성하는 길이이며, 모든 사용 모드의 입력 한도가 같다는 뜻은 아니다.
4.3. 프롬프트도 장면 명세로 바꾼다
“로봇이 컵을 집는다”처럼 짧은 문장에는 물체 배치·동작 순서·카메라·시간·소리 정보가 부족하다. Cosmos 3는 학습 캡션을 구조화된 JSON으로 만들고, 추론 시에도 짧은 요청을 장면과 시간 흐름을 담은 명세로 확장하는 프롬프트 보강(prompt upsampling)을 사용한다.
자체 Reasoner가 이 역할을 할 수 있지만, 보고서의 대표 이미지·영상 벤치마크에는 외부 Claude 모델을 이용한 보강도 사용된다. 따라서 표의 성능을 짧은 원문 프롬프트를 기본 모델에 그대로 넣은 결과로 해석하면 안 된다.
5. 실험: 무엇이 좋아졌고, 비교 조건은 무엇인가?
5.1. 장면 이해: Physical AI 영역에서 강점이 크다
보고서는 48개 이해 벤치마크를 일반·로봇·스마트 인프라·주행 영역으로 묶어 평가한다. 아래는 Table 10의 영역별 평균 점수다.
| 모델 | 일반 이해 | 로봇 관련 이해 | 스마트 인프라 | 주행 관련 이해 |
|---|---|---|---|---|
| Cosmos3-Super | 73.7 | 57.8 | 62.6 | 79.3 |
| Cosmos3-Nano | 69.6 | 55.1 | 61.0 | 76.0 |
| Qwen3-VL-32B | 72.8 | 52.6 | 56.1 | 40.7 |
| Gemini 3.1 Pro | 77.5 | 58.2 | 58.6 | 47.2 |
출처: Table 10, p.51. 일반 19개·로봇 17개·스마트 인프라 9개·주행 3개의 서로 다른 벤치마크 평균이다. 로봇 작업 성공률이나 실제 도로 주행 성공률이 아니다.
Super는 스마트 인프라와 주행 관련 이해에서 높은 점수를 얻지만, 일반 이해와 로봇 관련 평균에서는 Gemini 3.1 Pro보다 낮다. 특히 주행 항목에는 충돌 상황과 정지 표지판 대응을 분류하는 자체 벤치마크가 포함된다. 이 결과는 주행 장면을 잘 해석한다는 근거이지 자율주행 제어 전체의 성능 검증은 아니다.
5.2. 이미지 생성: 전문화 효과와 평가 범위를 함께 본다
| 모델 | UniGenBench 전체 | 원래 프롬프트 집합 | Physical AI 추가 집합 |
|---|---|---|---|
| Cosmos3-Super-Text2Image | 91.36 | 93.34 | 89.54 |
| Cosmos3-Super | 87.33 | 85.21 | 89.64 |
| Gemini 3 Pro Image | 90.69 | 92.81 | 89.74 |
출처: 상세 결과 Table 11, p.55. 600개 원래 프롬프트에 570개 Physical AI 프롬프트를 더한 1,170개 평가이며, 기준별 통과 여부를 평가 모델이 판정한다. 1024×1024 이미지와 구조화된 프롬프트 보강을 사용한다.
이미지 전용 후속 학습은 전체 점수를 87.33에서 91.36으로 높인다. 하지만 Physical AI 추가 집합에서는 기본 Super의 89.64보다 약간 낮은 89.54다. 특정 용도로 더 학습하면 모든 하위 능력이 동시에 개선되는 것은 아니다. 보고서 앞부분 요약 표의 Gemini 전체 점수는 90.85로 상세 표와 달라, 여기서는 평가 조건이 설명된 Table 11의 90.69를 사용했다.
5.3. 영상 생성: 자동 지표와 사람 평가가 같은 결론은 아니다
| 모델 | PAIBench-G 이미지→영상 | Cosmos HUE 이미지→영상 | Physics-IQ 이미지→영상 |
|---|---|---|---|
| Cosmos3-Super | 82.8 | 89.6 | 43.8 |
| Cosmos3-Nano | 82.7 | 88.6 | 40.2 |
| Wan2.2-A14B | 81.3 | 88.4 | 38.3 |
출처: Tables 12·14·13. 각 열은 서로 다른 평가이며, Physics-IQ는 여러 후보를 생성한 뒤 고르는 WMReward+best-of-N을 쓰지 않은 행이다. 세 점수를 직접 합산하거나 하나의 성공률로 해석하지 않는다.
- PAIBench-G: 영상의 품질과 도메인 적합성을 함께 본다. 보고서의 평가에는 Qwen2.5-VL-72B 심사 모델을 사용하며, 심사 모델이 다른 공개 리더보드 점수와 그대로 비교하기 어렵다.
- Cosmos HUE: 사람 평가자가 의미·물리 법칙·기하·시각적 완전성에 관한 세부 질문을 판정한다. Super의 89.6은 Veo-3.1의 89.7보다 약간 낮다.
- Physics-IQ: 실제 관찰 이후 생성한 움직임이 참조 물리 결과와 얼마나 맞는지 본다. Super는 기본 이미지 조건에서 43.8, 3초 영상 조건에서는 59.7이었다. 초기 움직임 정보가 있는 조건이 더 유리하며, 후보 재선택까지 사용한 점수는 또 다른 설정이다.
오디오도 단순히 붙이는 것이 아니라 보이는 사건과 소리의 관계를 평가한다. 다만 Cosmos-SoundBench의 종합 시청각 품질은 Super 7.31, Nano 7.34로, Seedance-1.5-Pro 7.64와 Veo-3.1 7.45보다 낮았다. 영상·소리의 의미 정렬에서는 강점이 있었지만 전반적인 음질까지 항상 앞선 것은 아니다.
6. 로봇 정책: 영상 예측이 실제 행동 학습에 도움이 되는가?
이 보고서에서 중요한 실험은 생성 품질뿐 아니라 다양한 행동 데이터를 먼저 배운 것이 로봇 정책의 출발점으로 유용한가다.
Cosmos3-Nano-Policy-DROID는 중간 학습된 Nano를 DROID 데이터로 추가 학습한 모델이다. 세 카메라의 관찰과 로봇 자체 상태를 받아, 미래의 절대 관절 위치 명령 32개와 보조 영상을 예측한다. 일반 행동 표현의 포즈 변화와 실제 DROID 제어용 관절 명령을 구분해야 한다.
| 모델 | 모호한 지시 | 기본 지시 | 구체적인 지시 |
|---|---|---|---|
| Cosmos3-Nano-Policy-DROID | 20.6% | 36.8% | 39.7% |
| Cosmos3-Nano: PT-init | 16.7% | 28.1% | 30.2% |
| π₀.₅ | 15.2% | 28.0% | 28.1% |
출처: Table 19, p.68. RoboLab-120 시뮬레이션의 작업 성공률이다. 비교 정책은 DROID로 학습한 체크포인트를 사용한다. PT-init은 행동 중간 학습을 거치지 않은 사전학습 체크포인트에서 정책 후속 학습을 시작한 경우다.
구체적인 지시에서 최종 정책의 39.7%는 PT-init의 30.2%보다 9.5%p 높다. 같은 표에서 π₀.₅는 28.1%다. 이는 행동 중간 학습이 도움이 된다는 결과지만, 39.7%를 어떤 로봇·어떤 환경에서도 얻는 성공률로 일반화할 수는 없다.
새 환경 적응에서도 차이가 있었다. LIBERO-10에서 중간 학습 모델로 시작하면 후속 학습 500회 시점에 24.6%, 사전학습 모델에서 바로 시작하면 0.0%였고, 2,000회에는 각각 97.4%와 95.2%였다. Table 20은 체크포인트마다 500회 rollout으로 평가했으며, 차이는 특히 초기 적응 속도에서 크게 나타난다.
실제 로봇에서는 확산 스텝을 4회로 줄이고 영상 잠재 표현의 디코딩을 생략하는 등의 최적화를 적용했다. 보고서의 정책 서버는 RTX Pro 6000 GPU 2개를 사용하고, 예측한 행동은 별도 제어기가 15Hz로 실행한다. 행동 실행 주기가 15Hz라는 사실을 모델 전체가 매번 15Hz로 새 추론을 끝낸다는 뜻으로 읽으면 안 된다.
7. 한계와 의미: 통합된 기반이지, 완성된 물리 엔진은 아니다
Cosmos 3의 성과는 서로 다른 문제를 하나의 입출력·학습 구조로 묶고, 그 기반에서 이해·생성·행동의 여러 능력을 확장했다는 데 있다. 반면 다음 구분은 필요하다.
- 하나의 구조와 하나의 완성 제품은 다르다. 최고 성능으로 소개되는 이미지·영상·정책 결과에는 각각의 후속 학습 체크포인트가 포함된다. Artificial Analysis의 이미지 결과에는 에이전트형 보조 절차도 사용됐다. 리더보드 순위는 보고서에 적힌 당시 시점의 결과다.
- 모달리티를 섞으면 이득과 손실이 함께 생길 수 있다. 부록 E.4의 PushT 실험에서는 공동 학습이 역방향 행동 오차와 정책 coverage를 개선했지만, 정방향 영상 예측의 PSNR은 낮아졌다. 모든 과제가 자동으로 함께 좋아지는 구조는 아니다.
- 물리적 정확성을 보장하지 않는다. 공식 모델 카드도 명시적인 물리 시뮬레이터가 없으며, 물체 소실·변형, 접촉 오류, 시간적 불일치와 행동·상태의 어긋남이 남는다고 설명한다. 긴 시간 범위의 예측이나 학습 분포 밖 환경에서는 특히 주의해서 해석해야 한다.
이 글에서 읽은 핵심은 ‘하나의 거대한 영상 모델이 로봇까지 해결했다’가 아니다. 장면을 해석하는 표현, 가능한 미래를 생성하는 능력, 행동과 결과의 관계를 같은 학습 틀 안에서 연결하고, 필요한 용도에 맞게 적응시키는 기반을 제시했다는 것이다.
답글 남기기