논문: Hist2Style: Histogram-Guided Stylization with Bilateral Grids
저자: Dekel Galor, Adam Pikielny, Zhoutong Zhang, Ke Wang, Laura Waller, Jiawen Chen, Ilya Chugunov
발표: CVPR 2026 · Adobe Nextcam, UC Berkeley
관련 자료: 공식 프로젝트와 시연 · 공식 저장소
1. 사진을 다시 그리지 않고 분위기만 옮길 수 있을까
노을 사진의 따뜻한 색감이나 야경의 차가운 톤을 다른 사진에 적용하고 싶을 때, 바꾸고 싶은 것은 장면 자체가 아니라 색과 명암이다. 대형 이미지 편집 모델은 이런 요구를 자연어로 받을 수 있지만, 처리 비용이 크고 원래 없던 질감이나 구조를 만들기도 한다. 반대로 단순한 전역 색상 매칭은 빠르지만, 하늘과 인물처럼 서로 다른 영역을 구별하기 어렵다.
Hist2Style은 이 두 접근 사이에 있다. 대형 편집 모델로 학습용 사진을 만들되, 실제 편집을 수행하는 작은 모델은 새 이미지를 자유롭게 생성하지 못하게 제한한다. 대신 원본 픽셀에 적용할 공간별 색 변환을 예측한다. 스타일은 해석하기 어려운 잠재벡터 대신 채널별 히스토그램으로 전달하므로 사용자가 밝기나 색 분포를 직접 조절할 수 있다.
- 작은 모델로 능력을 압축한다: 대형 모델의 여러 기능 중 사진의 색과 톤을 바꾸는 능력만 학습한다.
- 출력 공간을 제한한다: bilateral grid에 담긴 국소 색 변환을 원본에 적용해, 구조를 다시 생성하는 경로를 피한다.
- 스타일을 편집 가능한 조건으로 만든다: 히스토그램 조작을 이미지 내용에 맞는 국소 보정으로 바꾼다.
- 품질과 속도를 함께 평가한다: 사진 전문가의 선호도에서 강점을 보이지만, 모든 해상도와 모든 수치 지표에서 최고인 것은 아니다.
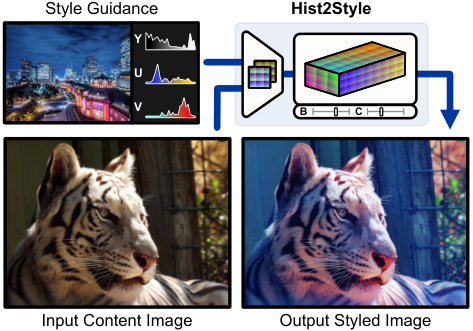
그림 1. 스타일 사진의 장면을 복사하는 것이 아니라 색과 톤을 전달한다. 호랑이의 형태는 유지하면서 야경의 색감을 적용한 저자 예시다. 출처: Galor et al., Hist2Style, Figure 1.
2. 핵심 구조: 저해상도에서 변환을 예측하고 원본에 적용한다
2.1 히스토그램과 이미지가 맡는 역할
히스토그램은 어떤 밝기나 색 값이 얼마나 자주 나타나는지를 세는 분포다. 이 논문은 채널마다 따로 계산한 주변 히스토그램을 사용한다. 사용자가 다루는 Y’CbCr 공간에서는 Y’가 밝기 성분, Cb와 Cr이 색차 성분을 표현한다.
히스토그램에는 위치 정보가 없다. “푸른색이 많다”는 사실은 알 수 있어도 그 색이 하늘에 있는지 옷에 있는지는 알려 주지 않는다. 따라서 Hist2Style은 히스토그램만으로 출력을 정하지 않고, 콘텐츠 이미지의 공간적 특징과 스타일의 전역 분포를 함께 읽는다.
콘텐츠 분기는 축소한 이미지를 2차원 ConvNeXt 계열 인코더로 처리한다. 스타일 분기는 원본과 목표의 채널별 색 히스토그램을 1차원 CNN으로 처리해 편집 조건을 만든다. 두 정보는 교차 어텐션(cross-attention)으로 결합되고, 작은 출력 헤드가 위치에 따라 다른 색 변환을 예측한다. 그림의 스타일 입력은 간단히 표현되어 있지만, 본문 §3.4는 원본과 목표 히스토그램을 함께 인코딩한다고 설명한다.
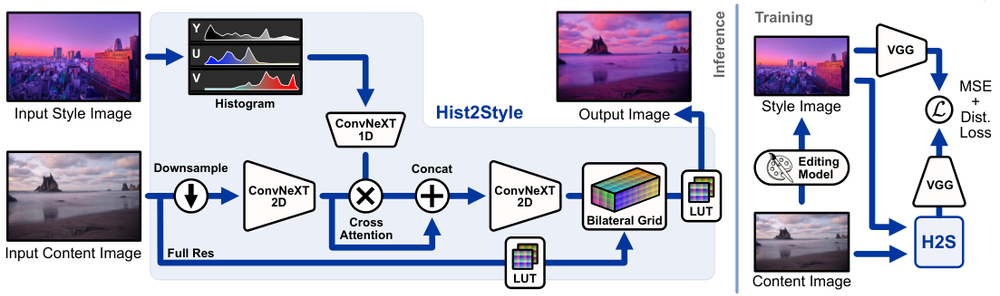
그림 2. 왼쪽은 추론, 오른쪽은 학습이다. 신경망은 작은 표현에서 변환을 예측하지만, 실제 색 변환은 원해상도 콘텐츠에 적용된다. 출처: 원문 Figure 3. 원문에서 확대.
2.2 Bilateral grid: 위치와 색을 함께 고려하는 변환표
일반적인 전역 LUT는 같은 입력색에 같은 출력색을 대응시킨다. Bilateral grid는 여기에 공간 좌표와 경계를 구분하기 위한 안내값을 함께 사용한다. 그래서 비슷한 색이라도 이미지의 어느 영역에 있는지에 따라 다른 보정을 할 수 있고, 가까운 픽셀이라도 안내값이 다르면 서로 다른 변환을 받을 수 있다.
Hist2Style의 격자는 안내축 8 × 높이 16 × 너비 16이다. 안내값은 RGB로부터 학습하는 스칼라 함수로, 밝기와 유사한 경계 구분 역할을 한다. 각 격자점에는 RGB를 변환하는 3×4 아핀 계수, 즉 행렬 곱과 편향에 필요한 12개 값이 저장된다.
각 픽셀의 위치와 안내값으로 격자를 조회하고, 주변 격자점의 계수를 삼선형 보간하는 과정을 slicing이라고 한다. 이 덕분에 큰 신경망을 모든 고해상도 픽셀에서 실행하지 않고도, 작은 격자가 정한 변환을 원본 크기로 적용할 수 있다. 해상도를 높이면 픽셀별 계산과 메모리는 여전히 늘어나지만, 변환을 예측하는 격자 자체는 작게 유지된다.
논문은 추가로 양수 채널 를 예측한다. 계수에 를 미리 곱해 보간한 뒤, 보간된 로 나누는 방식이다. 원문 §3.4의 절차를 수식으로 재정리하면 다음과 같다.
\widetilde A(p)=\frac{\sum_{k\in\mathcal N(p)}w_k(p)\,\alpha_k A_k}
{\sum_{k\in\mathcal N(p)}w_k(p)\,\alpha_k}.는 격자점의 아핀 계수이고, 는 픽셀 위치와 안내값에 따른 보간 가중치다. 원문은 를 불확실성 채널이라고 부르며 softplus로 양수화한다. 여기서는 보간 시 계수의 상대적인 기여를 조절하고 정규화하는 장치로 이해하면 된다. 검증된 확률적 신뢰도 점수로 해석할 근거까지 제시한 것은 아니다.
아핀 변환의 앞뒤에는 채널별로 학습한 부드러운 단조 비선형 함수도 적용한다. 전체 픽셀 변환은 개념적으로 다음과 같이 정리할 수 있다.
I_o(p)=\psi_{\mathrm{out}}\!\left(
\widetilde A(p)
\begin{bmatrix}\psi_{\mathrm{in}}(I_c(p))\\1\end{bmatrix}
\right).와 는 콘텐츠와 출력 이미지, 과 은 전후의 채널별 변환이다. 원본 픽셀을 다른 위치로 옮기거나 장면을 다시 합성하는 연산은 아니다. 다만 구조를 재생성하지 않는다는 것과, 모든 색·대비·경계가 손실 없이 보존된다는 것은 다르다. 이 방법의 제약은 환각을 억제하는 설계이지 모든 시각적 오류가 불가능하다는 보장은 아니다.
3. 학습: 대형 편집 모델을 교사로 쓰되 그대로 따라 하지는 않는다
학습 데이터는 Unsplash Lite의 약 2만 5천 장에서 출발한다. 언어 모델이 “Golden Hour”나 “1950s Film Noir” 같은 스타일 이름과 설명을 만들고, FLUX.1 Kontext의 [dev] 모델이 사진별 스타일 변형을 생성한다. 보충자료는 스타일 설명 생성에 Google Gemini를 사용했다고 밝힌다.
교사 결과에도 구조 왜곡이 있을 수 있으므로, 원본과 편집본의 VGG19 특징 코사인 유사도로 데이터를 거른다. 임계값은 0.5이며, 생성한 약 170만 장 중 110만 장을 남겼다. 이는 모든 오류를 제거했다는 뜻이 아니라, 잘못된 학습 신호를 줄이기 위한 선별 단계다.
학습할 때는 같은 사진의 스타일 변형 두 개를 뽑는다. 하나는 콘텐츠 입력으로, 다른 하나는 정답 이미지이자 목표 히스토그램의 출처로 쓴다. 모델 규모는 150만 파라미터, 학습 이미지는 256×256이다. 중요한 점은 추론 때 사용자가 주는 스타일 사진은 대개 콘텐츠와 다른 장면이라는 것이다. 학습과 사용 환경 사이에 차이가 남는다.
위치를 맞추는 손실과 분포를 맞추는 손실
학습에는 두 요구가 함께 들어간다. 하나는 출력과 정답의 대응 위치가 비슷해야 한다는 것이고, 다른 하나는 전체적인 색·특징 분포가 비슷해야 한다는 것이다. 논문은 두 손실을 원시 RGB보다 VGG 지각 특징 공간에 적용했을 때 일반화가 더 좋았다고 보고한다. 저자들은 교사가 만든 데이터의 미세한 위치 불일치가 그 이유라고 해석한다.
분포 손실은 채널마다 특징값을 공간축으로 정렬한 뒤 비교한다. 원문 Algorithm 1은 다음처럼 쓸 수 있다.
\mathcal L_{\mathrm{dist}}=
\frac{1}{C}\sum_{c=1}^{C}
\left\|\operatorname{sort}(X_{:,c})-
\operatorname{sort}(Y_{:,c})\right\|_2^2.와 는 출력과 정답의 특징을 공간축으로 펼친 행렬이며, 는 채널 수다. 같은 위치끼리 비교하지 않고 낮은 값부터 높은 값까지 정렬해 대응시키므로 공간 배치와 별개로 분포의 차이를 측정한다. 같은 수의 표본을 비교할 때, 표본 수에 대한 정규화 상수를 제외하면 채널별 1차원 Wasserstein-2 거리의 제곱에 해당한다. 이것은 스타일 입력의 색 히스토그램과 관련된 아이디어지만, 학습 손실이 단순히 RGB 히스토그램만 맞춘다는 뜻은 아니다.
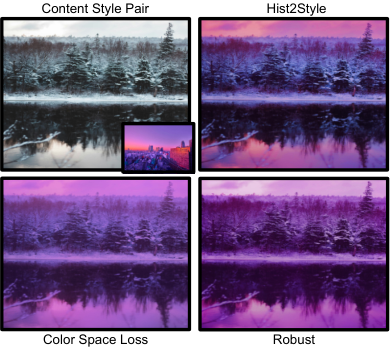
그림 3. 오른쪽 위의 기본 모델과 아래쪽의 두 변형을 비교한다. 저자는 지각 공간 학습이 색공간 손실보다 대비와 색 표현에 유리하고, Robust 변형보다 목표 색을 더 정확히 표현한다고 설명한다. 출처: 원문 Figure 8.
학습 때도 다른 장면의 동일 스타일 히스토그램을 주는 Robust 변형을 실험했지만, 저자들은 어떤 색을 어디에 배치할지 모호해져 색 일치가 나빠졌다고 보고한다. 보충자료의 해당 변형에는 다른 구성 변경도 함께 들어가므로, 그 결과를 히스토그램 입력 방식 하나만 바꾼 완전히 분리된 인과 실험으로 보기는 어렵다.
4. 제어: 출력 픽셀 대신 목표 분포를 바꾼다
사용자가 밝기를 올리거나 특정 색을 더하고 싶으면, 모델의 출력 이미지를 직접 고치는 대신 입력 히스토그램을 수정한다. 네트워크는 바뀐 전역 분포와 콘텐츠를 다시 읽어 공간적으로 일관된 색 변환을 예측한다. 따라서 같은 전역 조절이라도 이미지의 영역별로 결과가 달라질 수 있다.
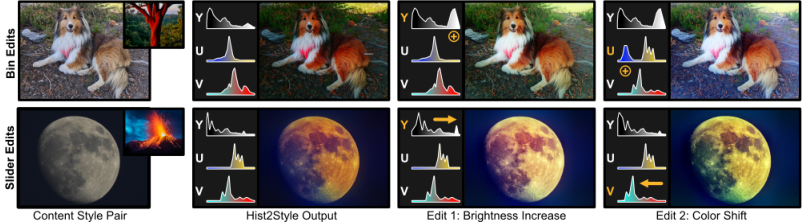
그림 4. 위쪽은 히스토그램 구간을 직접 조절하고, 아래쪽은 밝기·색 이동 슬라이더를 조절한다. 분포를 바꾸면 장면 구조를 유지한 채 톤과 색이 달라진다. 출처: 원문 Figure 6.
논문은 밝기, 대비, Cb·Cr 이동, 분포 평활화 슬라이더와 곡선 직접 드래그를 제공한다. 별도의 amount 조절은 아무 변화 없는 항등 변환과 모델의 예측 변환 사이에서 적용 강도를 바꾼다.
이 제어는 “어느 객체를 바꿀지”보다 “전체적으로 어떤 분포를 원할지”에 가깝다. 하늘과 인물에 서로 다른 스타일을 명시적으로 지정하는 마스크 기반 편집은 아직 후속 연구 방향이다. 히스토그램은 해석하기 쉬운 입력이지만, 의미 단위 편집 도구 전체를 대신하지는 않는다.
5. 결과: 사용자 선호도와 계산 비용을 분리해서 보자
5.1 전문가 선호도: 각 비교 방법에 대해 61% 이상 승리
평가에는 학습에 사용하지 않은 콘텐츠 사진 136장과 스타일 사진 19장을 사용했다. 사진 전문가 31명에게 콘텐츠·스타일 쌍과 두 결과를 익명·무작위 순서로 보여 주고, 원본의 구조와 세부를 유지하면서 목표 톤을 잘 따르는 결과를 고르게 했다. 동점도 허용했으며 총 3,000건의 유효 비교를 수집했다.
아래는 원문 Table 1이다. 모든 결과는 히스토그램을 사람이 추가로 수정하지 않은 자동 출력에 대한 평가다.
| 비교 대상 | Hist2Style 승리 | 동점 | Hist2Style 패배 |
|---|---|---|---|
| SA-LUT | 82.57% | 3.56% | 13.86% |
| WCT2 | 72.58% | 5.85% | 21.57% |
| Xia et al. | 73.24% | 4.10% | 22.66% |
| IDT | 73.75% | 3.01% | 23.25% |
| D-LUT | 70.59% | 3.04% | 26.37% |
| PhotoWCT2 | 61.62% | 6.26% | 32.12% |
가장 강한 비교 대상인 PhotoWCT2에 대해서도 Hist2Style은 61.62%의 승리율을 기록했다. 다만 이는 이 데이터와 이 평가 질문에서의 선호율이지, 모든 사진의 품질이 그만큼 향상됐다는 수치가 아니다. SA-LUT은 log-encoded 이미지로 학습되어 RGB 평가에서 불리했을 가능성을 논문 자체가 언급한다. 표의 일부 합계가 100%에서 조금 벗어나는 것은 보고값의 반올림 수준이다.
5.2 속도: 빠르지만 고해상도에서 항상 가장 빠르지는 않다
논문은 단일 NVIDIA A100 환경을 명시한다. 보충자료의 시간 측정은 이미지별 10회 워밍업 후 100회 평균이며, 가능한 경우 최초 이미지 로딩을 제외하고 히스토그램 계산 등 전처리는 포함한다. 아래는 Table 2에서 대표 방법·해상도를 골라 옮긴 값이다. 단위는 초다.
| 방법 | 512×512 | 2048×2048 | 4096×4096 |
|---|---|---|---|
| Hist2Style | 0.003 | 0.04 | 0.1 |
| Xia et al. | 0.003 | 0.008 | 0.03 |
| PhotoWCT2 | 0.3 | 0.4 | 1 |
Hist2Style은 4096×4096에서 0.1초로 PhotoWCT2보다 빠르지만, Xia et al.의 0.03초보다는 느리다. 0.1초의 역수는 약 초당 10장이므로, 이를 같은 해상도의 60fps 처리로 해석해서는 안 된다. 이 값도 동영상 파이프라인 전체의 프레임레이트를 측정한 것은 아니다.
D-LUT은 비용 구조가 다르다. 새 스타일을 준비할 때 약 100초가 들지만, 같은 스타일을 재사용하면 16MP 적용 시간이 0.001초라고 보고한다. 초기화 비용을 포함한 표의 100초만 보고 항상 느리다고 결론 내릴 수 없다.
메모리 역시 별개의 조건이다. Hist2Style의 최대 사용량은 약 4MP에서 1GB, 16MP에서 5GB다. 작은 파라미터 수가 곧 낮은 고해상도 실행 메모리를 뜻하지는 않으며, 이 A100 실험으로 모바일 기기에서의 실시간 동작까지 확인한 것은 아니다.
5.3 자동 지표: 히스토그램을 가장 잘 맞추는 모델과 선호 모델은 다르다
저자들은 시각언어모델에 전문가와 같은 평가 질문을 던지는 SQA(Stylization Quality Assessment)도 제안한다. 방법별 집계 점수와 사용자 점수의 상관계수는 0.83으로 보고했다. 이는 비교 방법 간 경향이 비슷하다는 결과이지, 개별 판단의 83%가 사람과 일치했다는 뜻은 아니다. Table 3의 Hist2Style 점수 50도 기준 모델과 비교하기 위한 상대 기준이며 절대 품질이나 정답률이 아니다.
원문 Table 3을 보면 다른 지표에서는 순위가 바뀐다. 원래 스타일로 되돌렸을 때의 오차인 cycle consistency는 IDT가 가장 낮고, 색 분포 일치는 PhotoWCT2와 WCT2가 더 좋다. FID가 가장 낮은 방법은 Xia et al.이다. Hist2Style의 강점은 분포를 가장 강하게 맞추는 데 있다기보다, 공간적 자연스러움·스타일 반영·처리 비용 사이의 균형에 있다.
6. 한계와 정리
이 방법은 생성의 자유를 줄여 얻는 장점과 한계가 분명하다. 국소 색 변환은 객체의 위치와 형태를 다시 만들지 않으므로 사진 보정에 적합하지만, 필름 그레인·반점·보케처럼 새로운 외관 요소를 추가하는 작업까지 담당하지는 않는다. 저자들도 이런 효과를 별도 레이어로 결합하는 방향을 제안한다.
고해상도에서도 문제가 완전히 사라지는 것은 아니다. 보충자료는 낮은 해상도로 학습한 격자를 큰 이미지에 적용하면 격자 아티팩트가 보일 수 있어 공간 방향으로 격자를 가우시안 평활화한다고 설명한다. “구조를 보존하도록 제한했다”는 주장과 실제 보간 품질은 구분해서 봐야 한다.
또한 현재의 주된 대상은 정지 이미지다. 긴 동영상의 시간적 일관성, 3D 장면 적용, 객체별 마스크 제어는 후속 과제로 남아 있다. 공식 저장소는 2026년 10월 25일 확인 기준 소스 코드 공개 승인 대기라고 안내하고 있어, 여기서 소개한 성능은 저자 보고값이며 직접 재현한 결과는 아니다.
Hist2Style에서 흥미로운 선택은 모든 편집을 할 수 있는 모델을 더 크게 만드는 대신, 원하는 작업에 맞춰 출력의 자유도를 줄였다는 점이다. 대형 모델은 학습 데이터를 만드는 교사로 쓰고, 실제 편집은 작고 제어 가능한 색 변환 모델에 맡긴다. 히스토그램이라는 오래된 도구가 이 과정에서 단순한 통계가 아니라, 사용자와 신경망 사이의 편집 인터페이스가 된다.
참고 자료
본문 그림은 논문의 방법·결과를 설명하기 위해 원문 Figures 1, 3, 8, 6을 출처와 함께 인용했다. 표시 크기만 조정했으며 이미지의 색과 패널 내용은 변경하지 않았다.
답글 남기기