신경망의 동작을 바꾸려면 보통 데이터를 모으고 손실 함수를 정한 뒤, 경사하강법으로 가중치를 업데이트한다. LLM이 이 과정에 참여하더라도 학습 코드나 하이퍼파라미터를 작성하는 역할이 일반적이다. 그렇다면 LLM이 신경망의 가중치를 직접 읽고, 어떤 계산을 하는지 추론한 다음, 필요한 부분을 고칠 수도 있을까?
Rikiya Takehi, Jayden Teoh, Alex Zhang, Omar Khattab이 2026년 11월 발표한 연구 블로그 Sparks of Weight-Space Programming은 이 질문을 실험한다. 저자들은 범용 LLM인 GPT-6 Astra를 사용해 작은 게임 정책부터 Qwen3.5-0.8B까지 가중치를 분석·수정했다. 아직 경사하강법의 대체재라기보다는, LLM을 신경망의 진단·수정 도구로 볼 수 있는지 보여주는 초기 결과다.
- 읽기: 가중치의 구조에서 모델이 학습한 과제나 특정 계산 회로를 추론한다.
- 고치기: 실패 원인과 관련된 가중치 일부를 직접 수정한다.
- 만들기: 게임 규칙에 맞는 계산을 설계하고 이를 신경망 가중치로 표현한다.
1. Weight-Space Programming은 무엇이 다른가
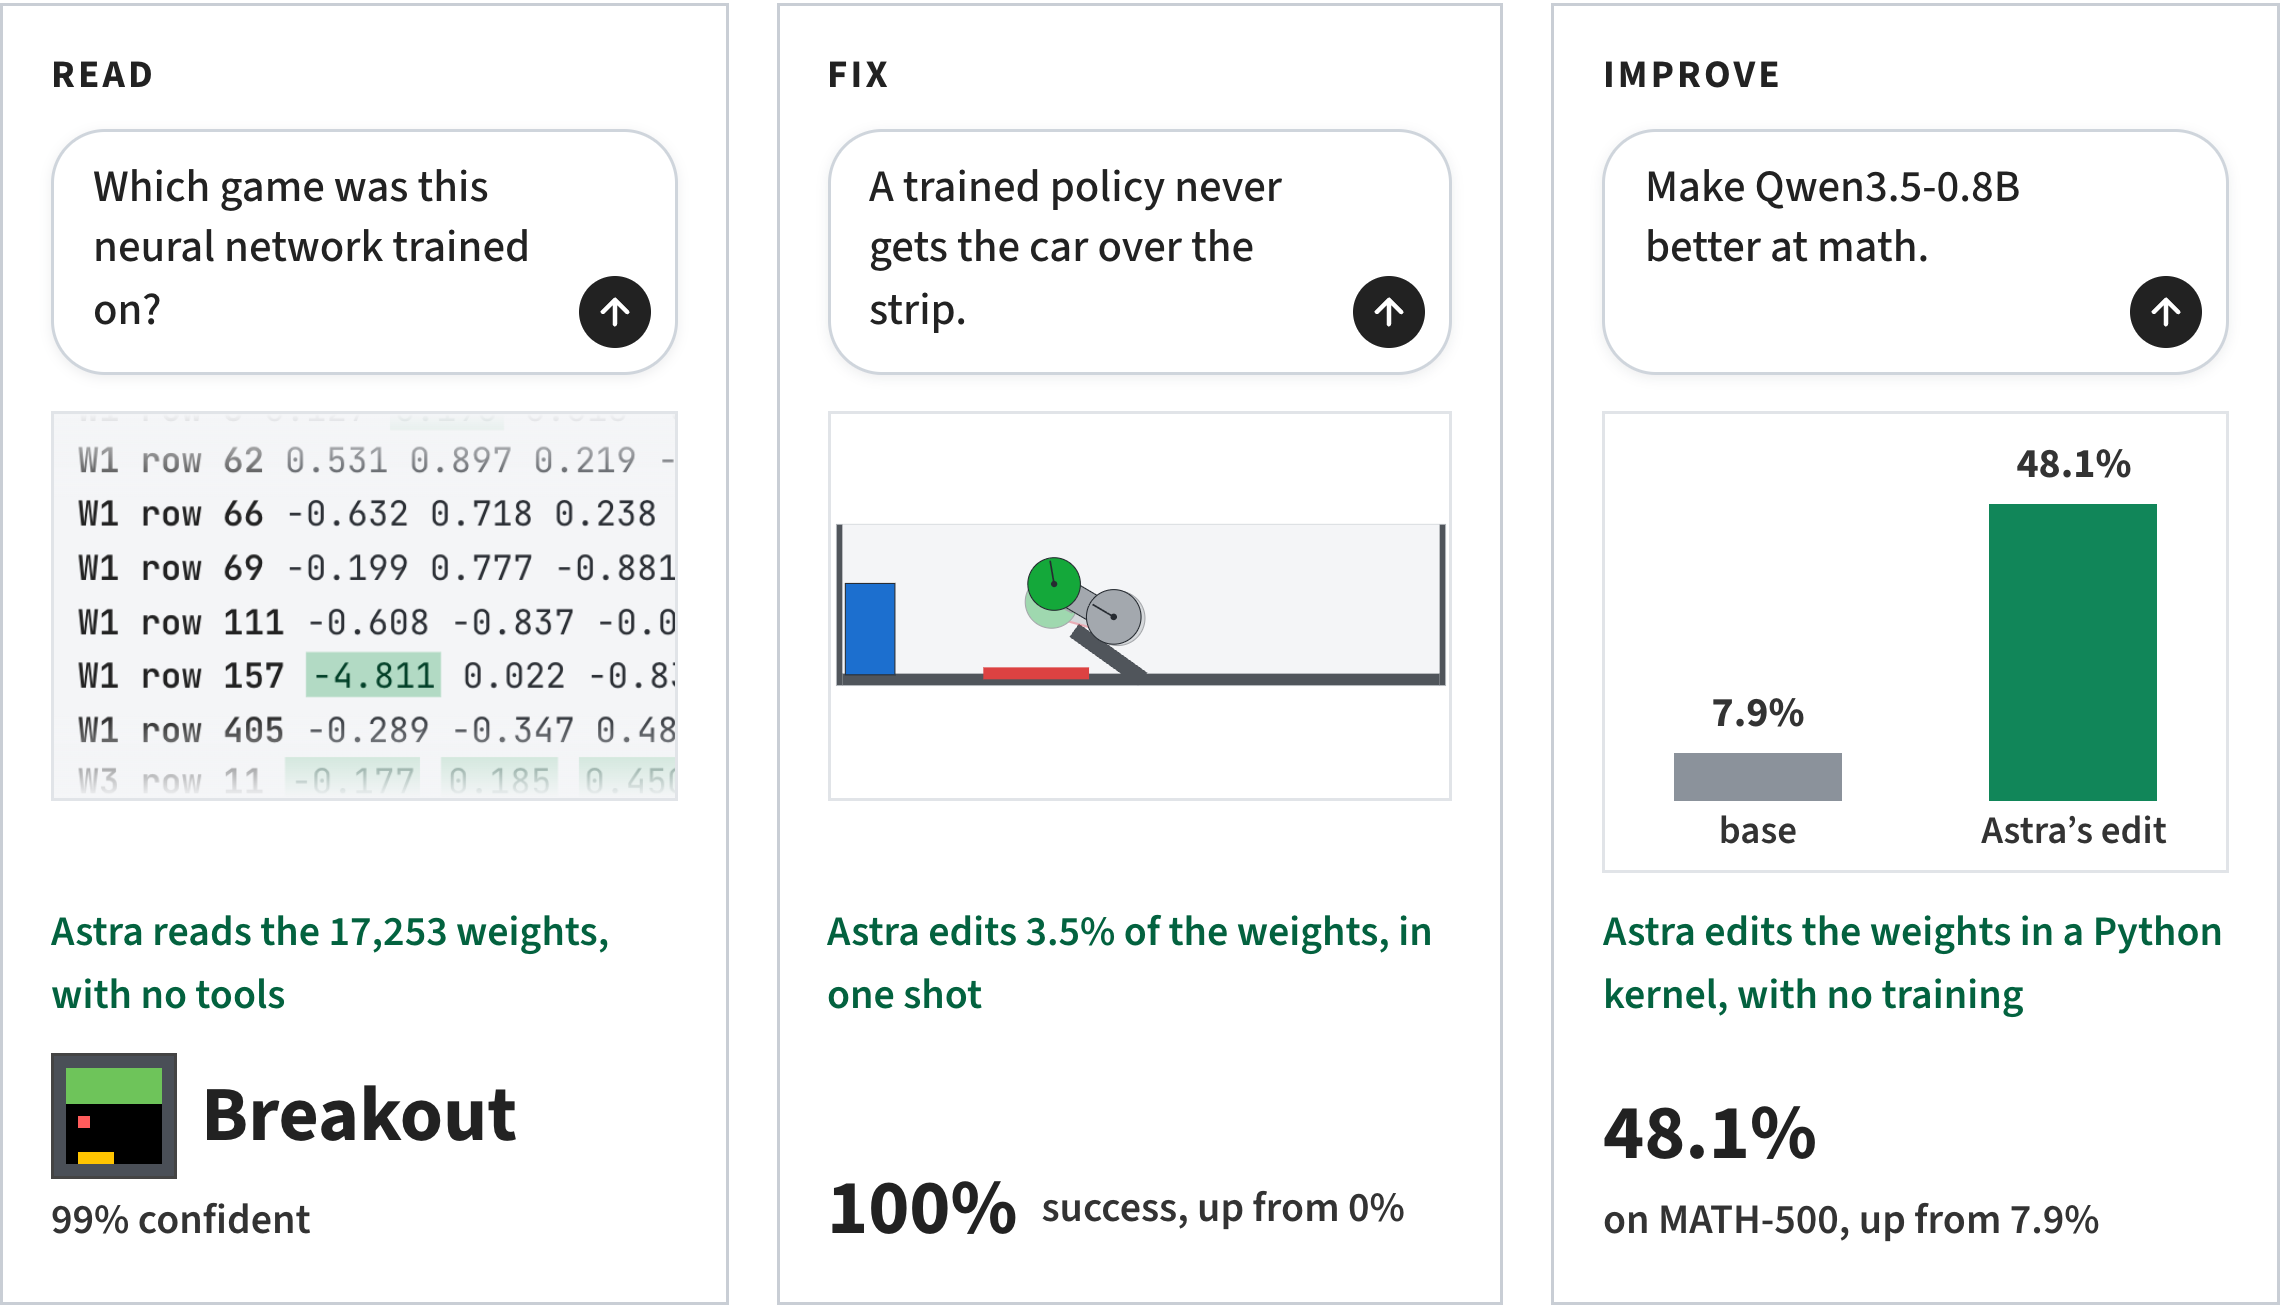
그림 1. 원문의 실제 소개 도표와 자동차 애니메이션 장면. 가중치에서 과제를 읽기(Read), 실패한 정책을 고치기(Fix), Qwen의 반복 문제를 줄이기(Improve)를 보여준다. 출처: Takehi 외, 원문.
여기서 가중치 공간 프로그래밍은 자연어로 주어진 목표를 만족하도록 LLM이 가중치 자체를 읽고 쓰는 방식이다. LLM이 학습 스크립트를 만들어 최적화기에 맡기는 것과 달리, 어떤 입력을 읽고 어떤 중간 계산을 거쳐 어떤 출력을 내야 하는지를 추론하고 그 계산을 가중치에 반영한다.
예를 들어 공을 받는 게임에서는 첫 층이 공의 예상 낙하지점을 계산하고, 다음 층이 패들을 그 위치로 이동시키도록 구성할 수 있다. 이때 LLM은 게임 전략을 코드로만 출력하는 것이 아니라, 주어진 신경망이 그 전략을 수행하도록 수치를 작성한다.
단, 모든 실험이 같은 조건은 아니다. 작은 네트워크에서는 가중치를 텍스트로 제공하고 도구 사용을 금지했다. 더 큰 모델에서는 Python으로 행렬을 분석·수정하거나 제한된 횟수의 순전파, 즉 모델을 실행해 반응을 관찰하는 과정이 허용됐다. 학습을 하지 않았다는 말과 데이터·도구·피드백을 전혀 쓰지 않았다는 말은 다르다.
2. 가중치만 보고 무엇을 알아낼 수 있었나
첫 실험에서는 구조와 입출력이 같은 작은 게임 정책 네트워크를 학습시킨 뒤, Astra에게 가중치와 입출력의 의미만 제공했다. 어떤 게임인지 선택지도 주지 않았지만 Breakout, Pong, Pac-Man, Freeway를 모두 맞혔다. 예를 들어 Breakout에서는 입력층의 특정 가중치가 화면 아래쪽에 집중된 모습을 패들의 흔적으로 해석했다.
더 흥미로운 실험은 작은 문자 단위 언어 모델의 입력층과 출력층을 제거하고 중간 Transformer 블록만 제공한 경우다. Astra는 Python으로 가중치를 분석할 수 있었지만 모델이나 개별 층을 입력에 대해 실행할 수는 없었다. 이 조건에서 Python 코드, 로마자로 표기한 일본어, 영어를 학습한 모델을 구분했고, 앞서 나온 문자열 뒤의 내용을 복사하는 유도 헤드도 찾아냈다.
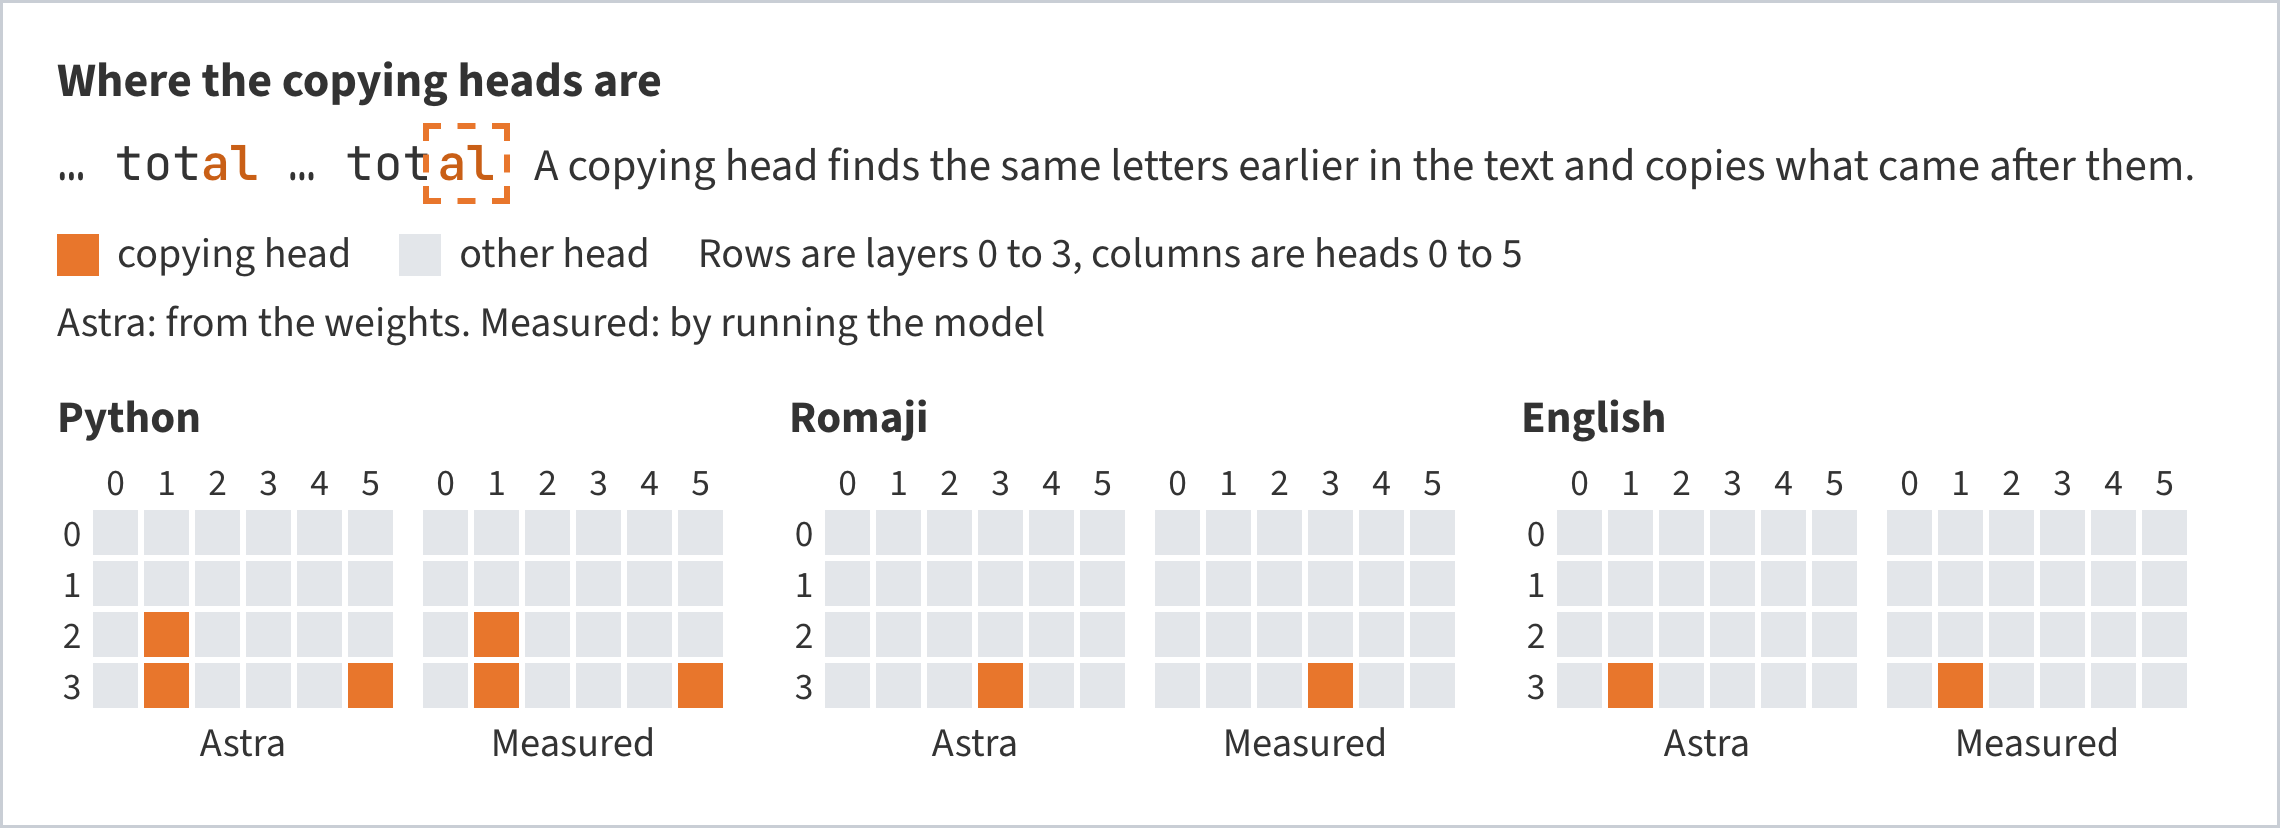
그림 2. 원문 Figure 1. 각 모델에서 가중치로 추론한 유도 헤드(Astra)와 실제 실행으로 측정한 유도 헤드(Measured)의 위치가 일치한다. 행은 층, 열은 어텐션 헤드다. 출처: 원문.
다만 이를 임의의 대형 모델에 대한 완전한 이해로 확대해서는 안 된다. 도형 생성 모델에서는 원과 삼각형 등을 구분했지만, 실제로는 채워진 도형을 생성하는 모델을 윤곽선처럼 설명하기도 했다. 구조적 단서를 읽는 능력과 전체 동작을 정확히 예측하는 능력 사이에는 차이가 있다.
3. 가중치를 처음부터 작성한 게임 정책
MinAtar 실험에서는 게임 규칙과 소스 코드, 입출력 형식, 고정된 네트워크 구조를 제공했다. 네트워크는 모든 가중치가 0인 상태에서 시작했고, Astra는 도구·실행 피드백·경사 정보 없이 한 번의 응답으로 가중치를 작성했다.
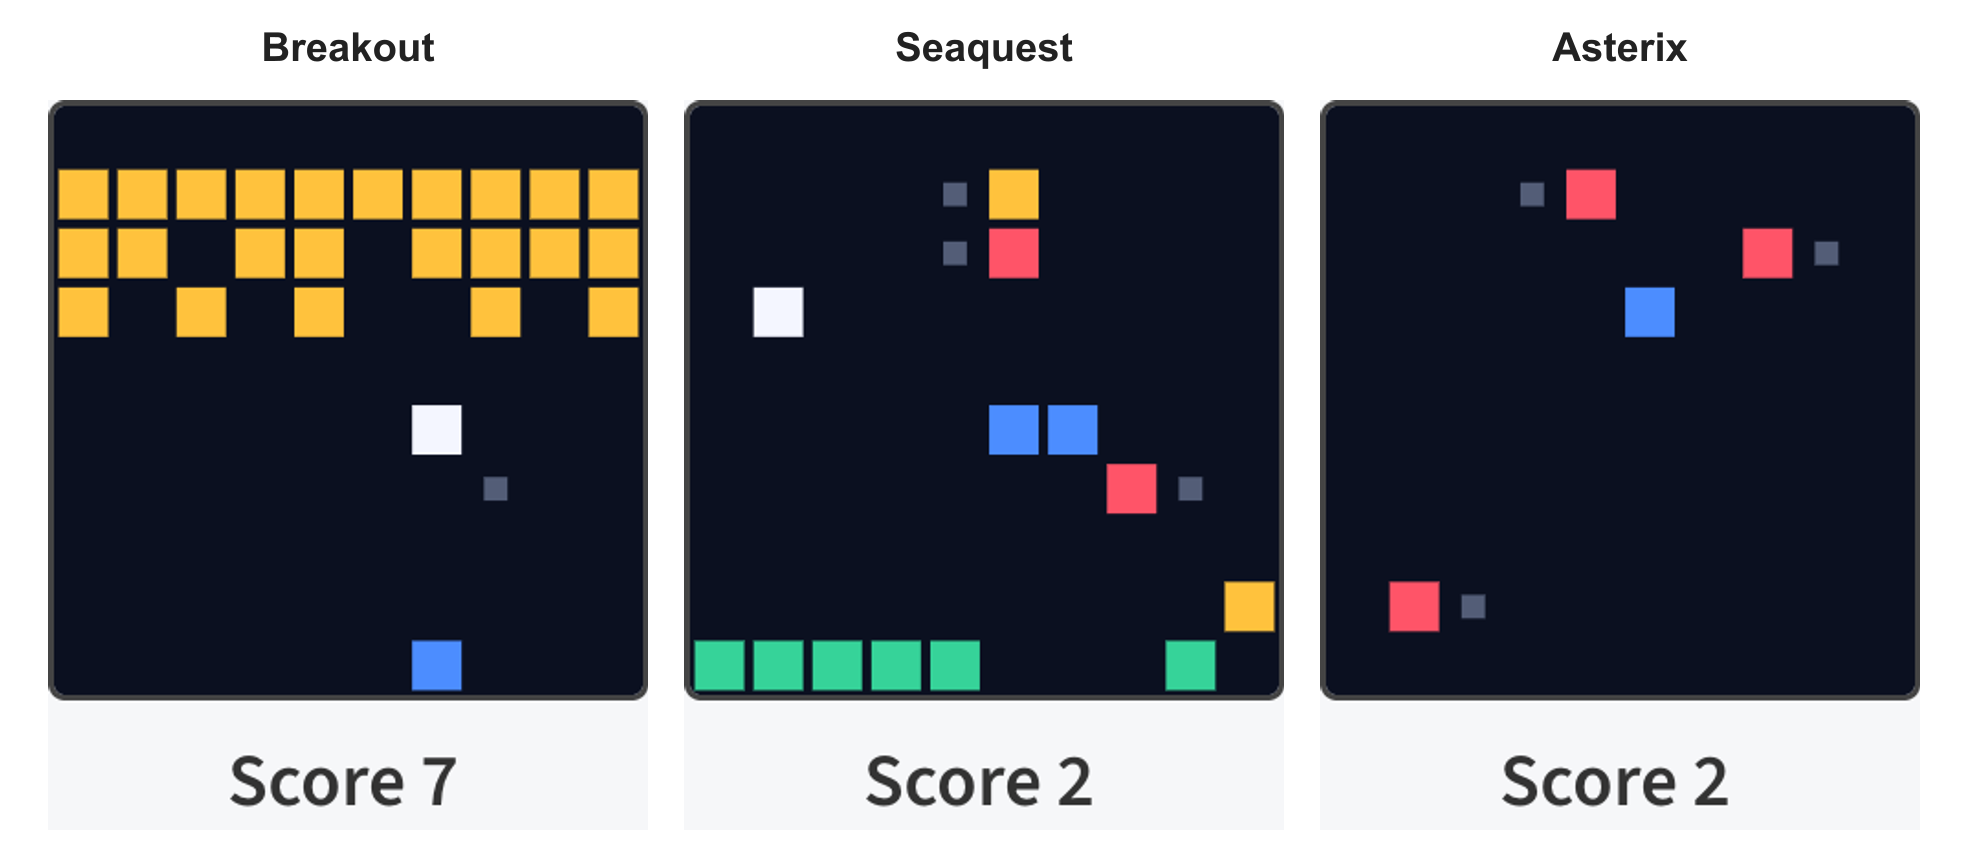
그림 3. 원문에서 Astra가 작성한 정책이 플레이하는 애니메이션을 캡처해 나란히 배치했다. 아래 Score는 그 장면의 누적 점수이며, 표 1의 에피소드 평균 점수와는 다르다. 출처: 원문 실험 5. 움직이는 전체 장면은 원문에서 볼 수 있다.
| 게임 | PPO 1억 스텝 | PPO 5억 스텝 | Astra 직접 작성 |
|---|---|---|---|
| Breakout | 15.8 | 25.3 | 517.4 |
| Seaquest | 5.6 | 88.9 | 53.1 |
| Asterix | 25.8 | 55.2 | 53.2 |
표 1. 원문 실험 5의 평균 게임 점수. 모두 같은 600 → 32 → 32 → 6 구조이며, 1,000개 에피소드로 평가했다. 행동은 확률적으로 선택했고 sticky action 확률은 0.1, 에피소드 상한은 10,000스텝이다. PPO 결과는 여러 학습 시드 중 최고 점수다.
직접 작성한 정책은 세 게임 모두에서 1억 스텝 PPO보다 높은 점수를 냈다. 그러나 5억 스텝 PPO와 비교하면 Breakout에서만 앞섰다. 강화학습을 일반적으로 대체했다기보다, 규칙을 이해한 LLM이 유용한 전략을 작은 신경망으로 옮길 수 있었다는 결과에 가깝다. 게임 규칙과 소스 코드가 제공됐다는 점도 중요하다.
4. Qwen의 성능 향상: 수학 능력 추가보다 반복 루프 수정
가장 주목할 결과는 Qwen3.5-0.8B를 수정한 실험이다. Astra는 가중치가 로드된 Python 환경과 연습 문제를 제공받고, 경사하강법이나 역전파 없이 수학 성능을 개선하도록 요청받았다.
Astra가 찾아낸 문제는 추론 반복 루프였다. 기본 모델이 같은 내용을 되풀이하다 생성 길이 상한에 도달해, 답을 끝내지 못하는 경우가 많았다. 저자 설명에 따르면 Astra는 15번과 19번 층의 MLP가 출력하는 특정 방향을 원인으로 지목하고, 각 층의 출력 행렬에서 64개 열에 그 방향을 빼는 수정을 적용했다.
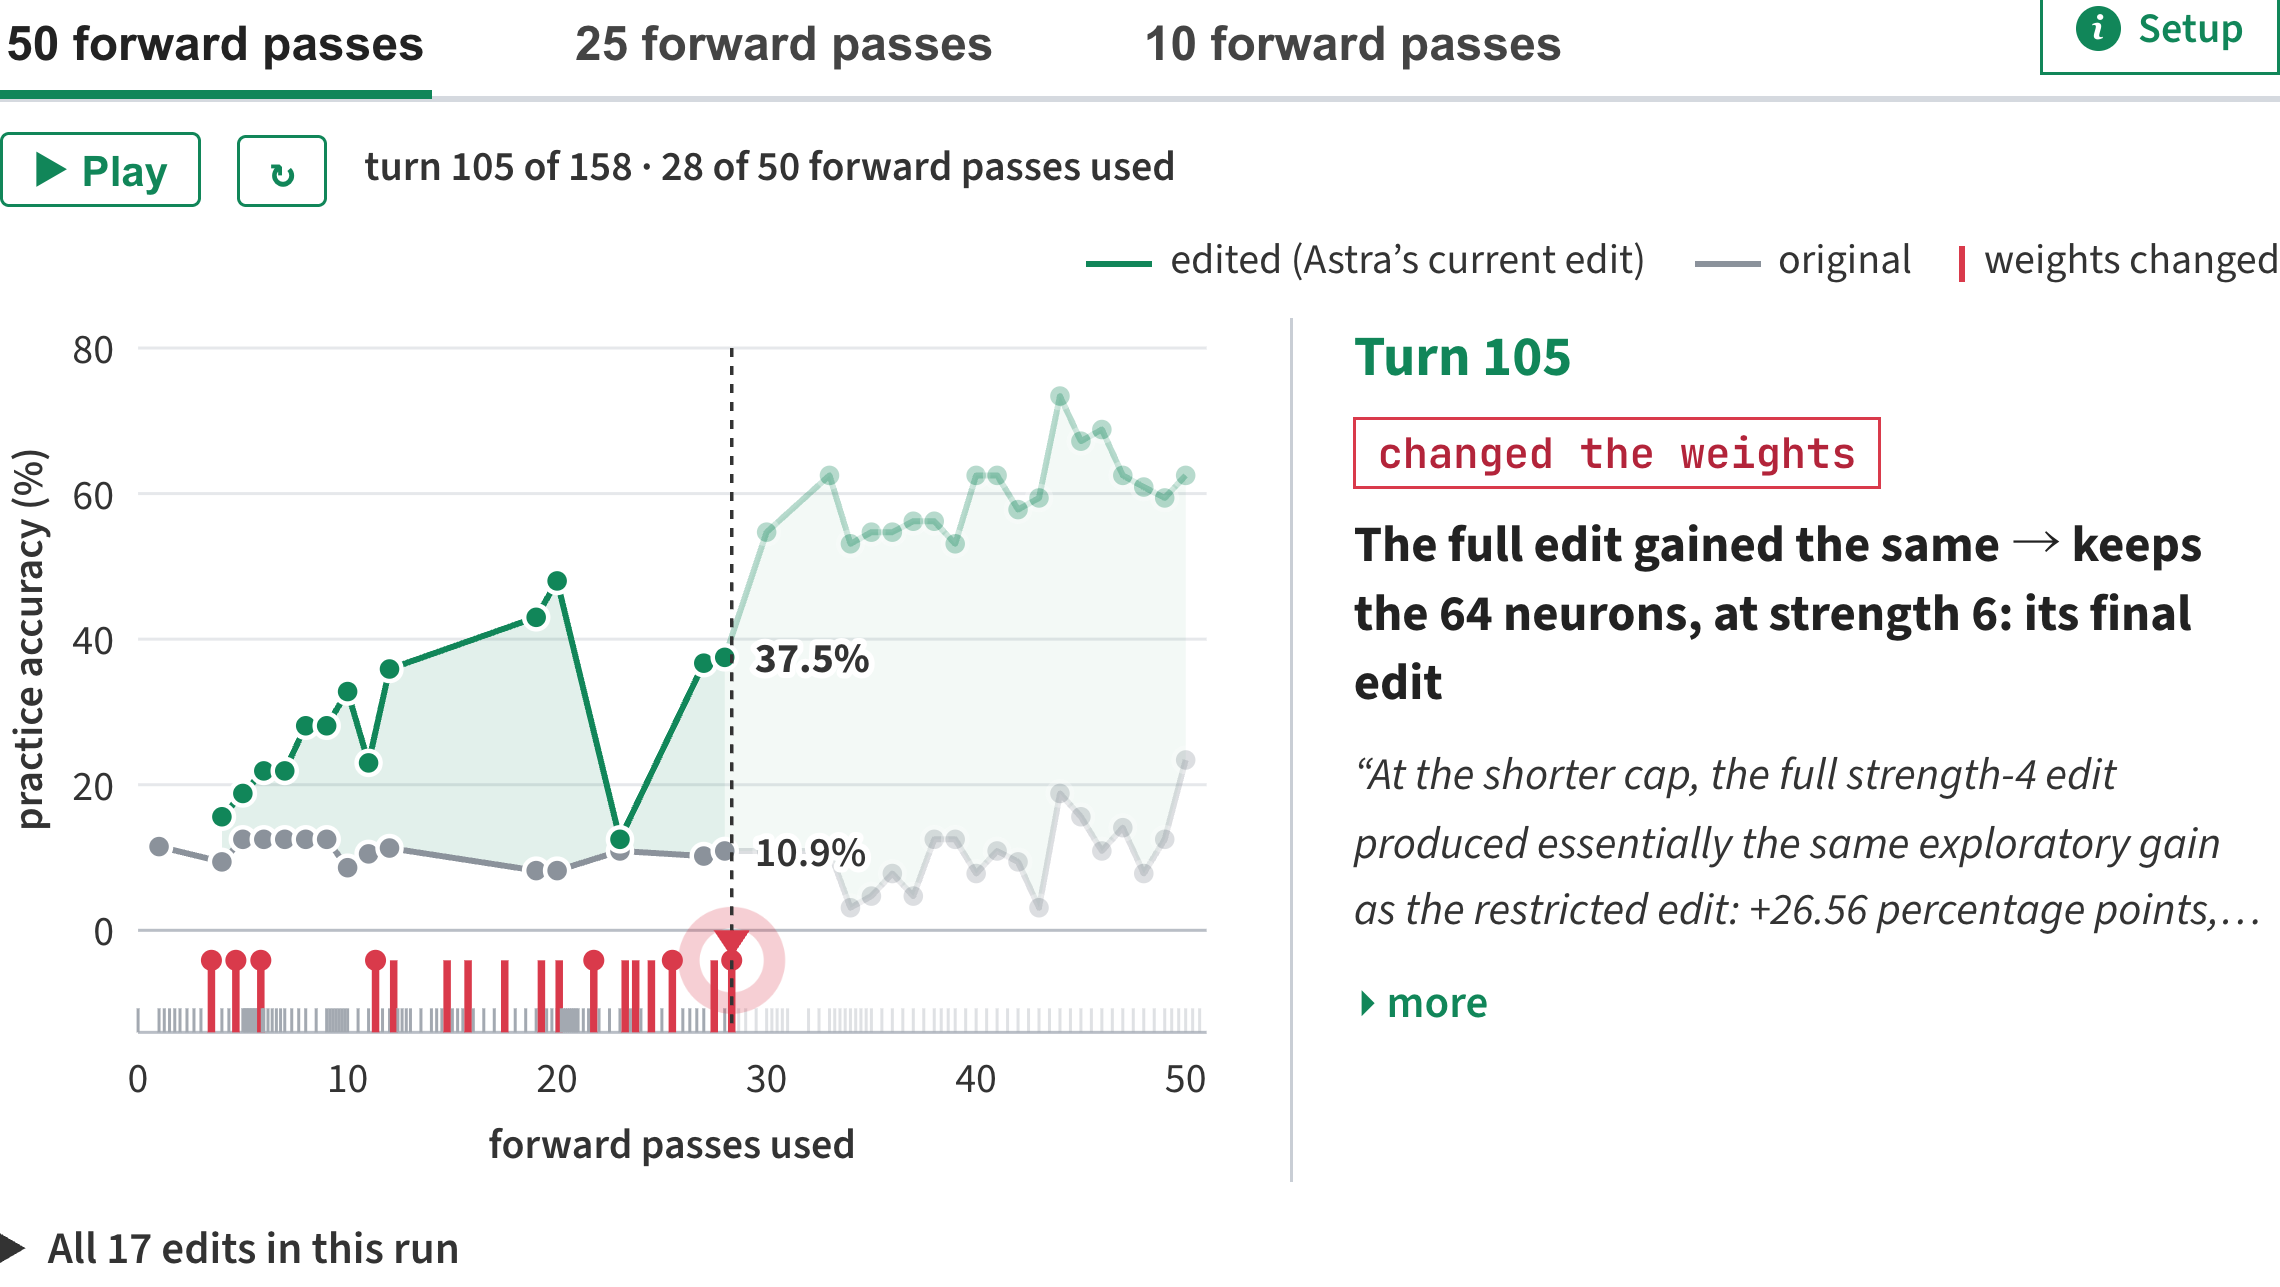
그림 4. 원문 수정 과정 애니메이션의 105턴 장면. 왼쪽은 연습 문제에서 측정한 기본·수정 모델의 성능과 가중치를 바꾼 시점이고, 오른쪽은 해당 수정의 설명이다. 이 연습 정확도는 아래 표 2의 테스트셋 점수가 아니다. 출처: 원문 실험 8.
수정 대상으로 삼은 항목은 131,072개로 전체 가중치의 약 0.016%다. 공개 로그는 평가용 bfloat16 반올림 이후 실제 값이 달라진 항목이 130,188개라고 구분한다. 따라서 0.016%는 소수의 가중치 영역을 건드렸다는 규모로 이해하는 것이 정확하다.
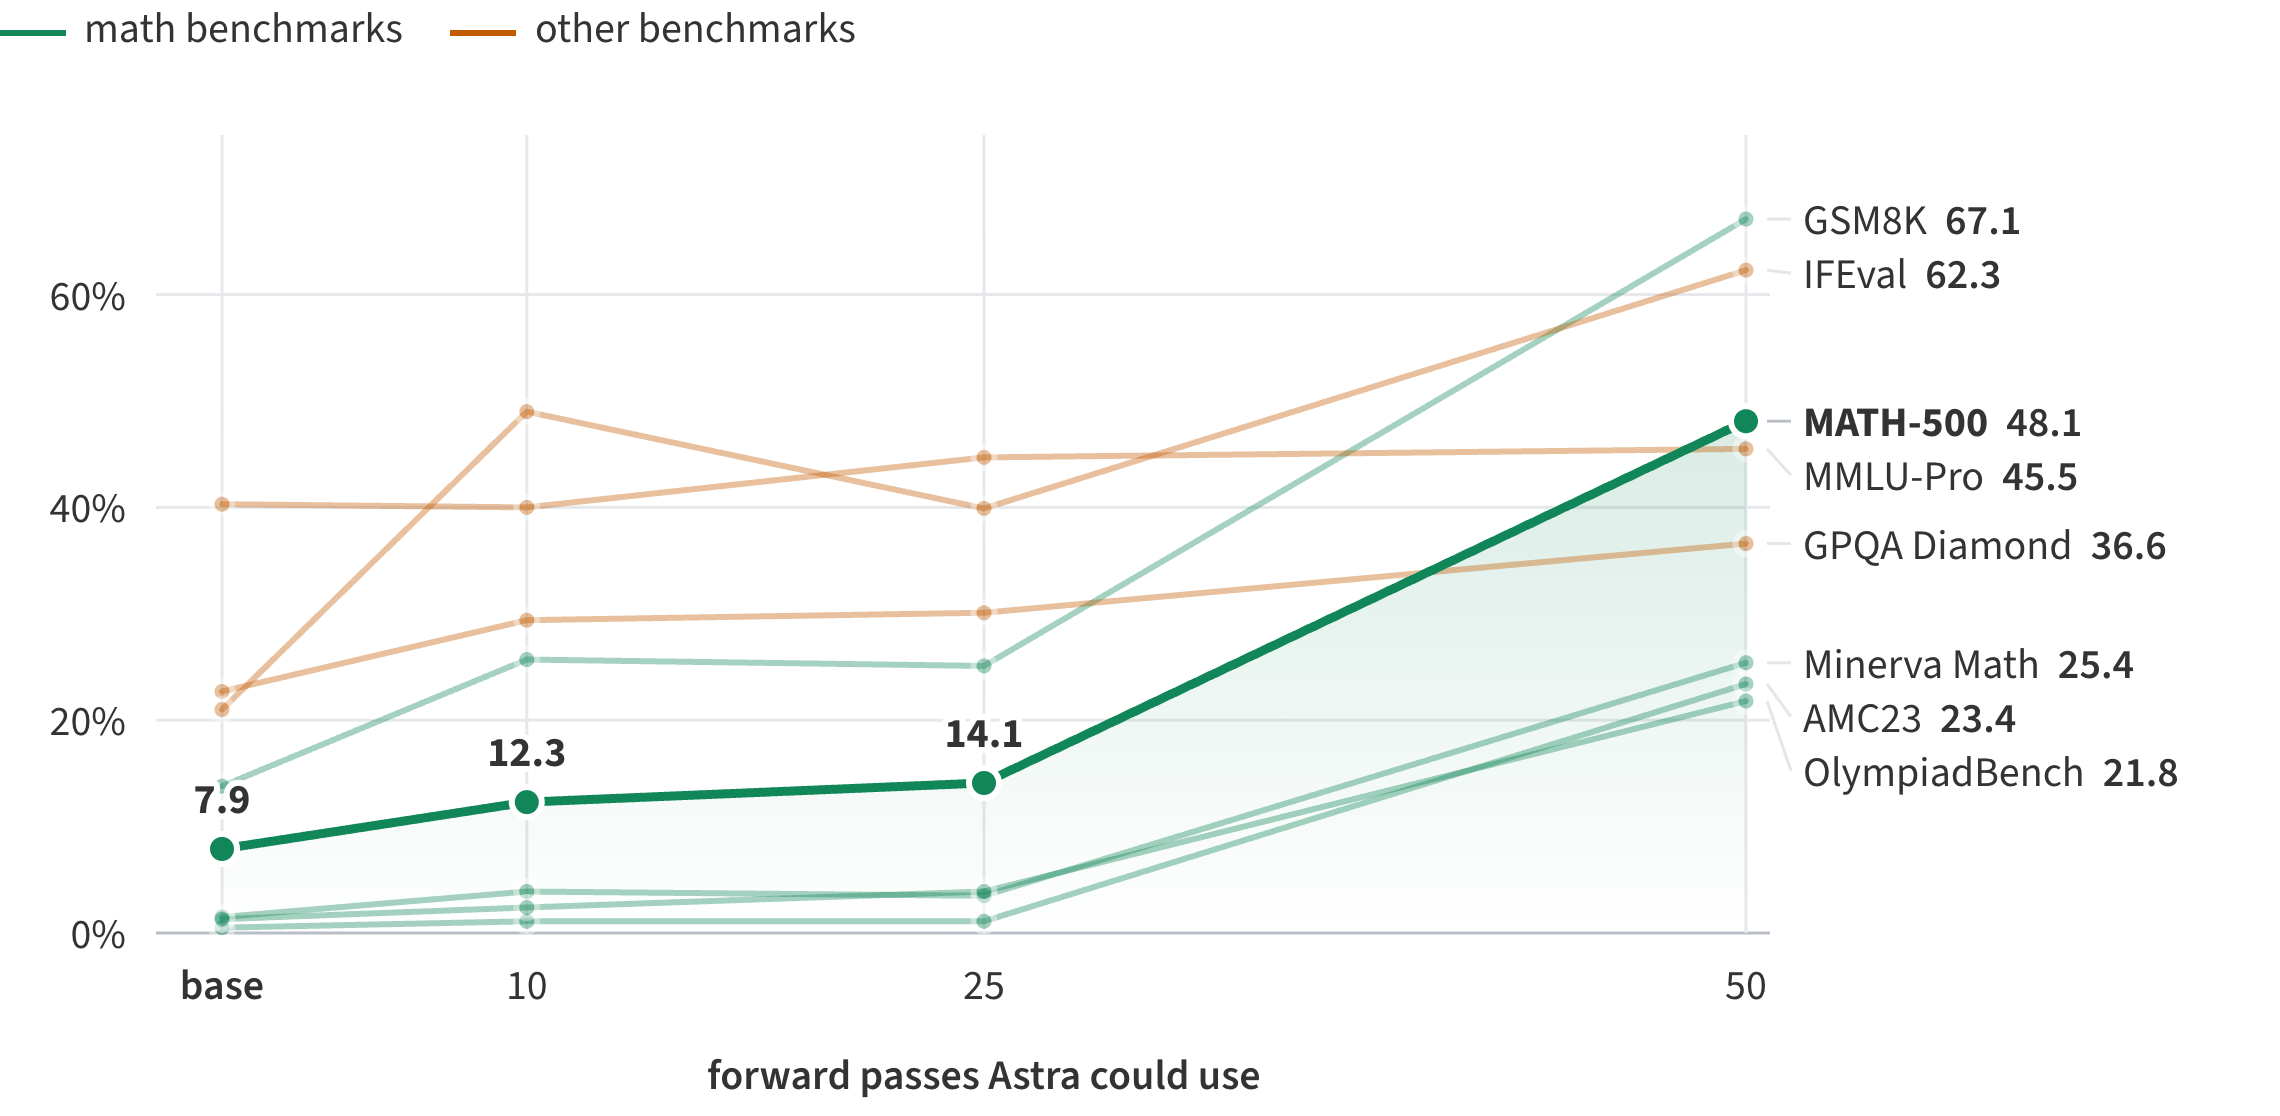
그림 5. 원문의 실제 벤치마크 도표. MATH-500이 강조돼 있으며, 초록색은 수학 평가, 주황색은 그 밖의 평가다. 각 순전파 예산은 별도 실행한 결과로, 한 모델을 순차 학습한 곡선은 아니다. 출처: 원문 실험 8. 이 글에서 직접 재현한 결과는 아니다.
| 수정 조건 | MATH-500 (%) | GSM8K (%) | IFEval (%) | MATH-500 길이 상한 도달 (%) |
|---|---|---|---|---|
| 기본 모델 | 7.9 | 13.8 | 21.0 | 93.0 |
| 순전파 10회 | 12.3 | 25.7 | 49.0 | 87.2 |
| 순전파 25회 | 14.1 | 25.1 | 39.9 | 86.4 |
| 순전파 50회 | 48.1 | 67.1 | 62.3 | 33.1 |
표 2. 원문 실험 8. 순전파 예산별로 별도 실행한 결과이므로, 한 모델을 순차적으로 개선한 곡선은 아니다. 마지막 열은 낮을수록 답을 끝내지 못한 비율이 줄었다는 뜻이다.
평가는 thinking 모드, 최대 32,768개 생성 토큰, temperature 0.6, top-p 0.95, top-k 20, presence penalty 1.5로 진행했다. MATH-500은 문제당 4개, GSM8K와 IFEval은 2개 응답의 평균 점수다. IFEval은 지시를 제대로 따르는지 평가하며, 여기서는 strict prompt-level accuracy를 사용했다. 수정 과정에서 이 테스트셋은 Astra에게 제공하지 않았다.
순전파 50회는 문제 50개라는 뜻이 아니다. 도구 호출 한 번으로 최대 512개 연습 문제의 답을 생성하거나 최대 1,024개 텍스트의 내부 반응을 관측할 수 있었다. 연습용 데이터와 정답도 제공됐다. 역전파가 없더라도 진단·수정·평가에는 계산과 피드백이 필요했다.
이 결과에서 중요한 것은 수학 지식을 새로 주입했다기보다, 모델이 이미 하던 계산을 끝내지 못하게 막던 결함을 줄였다는 점이다. 반복이 줄면서 수학뿐 아니라 지시 이행 점수도 함께 개선됐다. 다만 길이 상한 도달 비율은 수정 후에도 33.1%로 남았다.
모델 카드에는 별도의 MATH-500 재평가에서 51.0%를 얻었다는 보고도 있다. 이는 위 표의 원문 결과와 다른 평가 실행이며, 기본 모델의 동반 확인은 25문제 소규모 검사였으므로 완전한 동일 규모 비교로 합치지 않았다.
5. 실패한 실험이 알려주는 적용 범위
반복 문제가 적은 Gemma 3 270M에서는 뚜렷한 수학 능력 향상을 얻지 못했다. 기본 MATH-500 점수는 6.8%였고, 수정 조건별 점수는 7.0%, 7.6%, 7.7%, 7.0%였다. 저자들은 이 모델의 실패가 하나의 회로를 끄면 해결되는 반복 문제가 아니라, 산술과 추론 자체의 오류였다고 설명한다.
또한 사용자 의견에 무조건 맞장구치는 아첨 성향을 가진 모델을 찾는 실험에서도, 가중치만으로는 안정적으로 구분하지 못했다. 모델이 어느 토큰을 바라보는지 보여주는 어텐션 관측 도구를 추가한 뒤에야 세 모델 쌍을 모두 구분했다. 가중치 분석만으로 행동과 안전성을 감사할 수 있다는 전망은 아직 입증된 일반적 능력이 아니다.
작은 게임에서의 성공을 대규모 언어 모델의 임의 기능 추가로 확대할 근거도 부족하다. 또한 적은 수의 가중치만 수정했다고 해서 다른 능력이나 안전성이 자동으로 보존되는 것은 아니다. 원문에서 확인하지 않은 과제와 분포에 대해서는 추가 검증이 필요하다.
6. 정리: 학습 대체보다 신경망 디버깅의 가능성
이 연구가 보여주는 변화는 LLM의 작업 대상이 코드와 프롬프트를 넘어, 신경망의 수치 구조로 확장될 수 있다는 점이다. 작은 문제에서는 원하는 계산을 가중치로 작성했고, Qwen 실험에서는 행동상의 결함을 추적해 일부 가중치를 고쳤다.
현재 가장 설득력 있는 해석은 범용 학습의 대체가 아니라, 특정 결함에 대한 진단과 국소 수정의 가능성이다. 앞으로는 다양한 모델에서 반복 가능한 성공률, 수정 비용, 다른 능력의 보존 여부를 함께 검증해야 한다. 저자들이 제시한 자기 개선·기능 추가·모델 간 회로 이식은 이 결과에서 출발한 전망이지, 이번 실험으로 완성된 기술은 아니다.
참고 자료
- Takehi 외: Sparks of Weight-Space Programming: 연구 배경, 전체 실험과 도표.
- 공개 실험 로그: 프롬프트, 실행 기록, 평가 결과와 가중치 수정 자료.
- 수정된 Qwen3.5-0.8B 모델 카드: 수정 범위, 평가 조건과 별도 재평가 보고.
- 기본·수정 모델 비교 데모.
답글 남기기