논문: Image-adaptive 3D Lookup Tables for Real-time Image Enhancement with Bilateral Grids
저자·발표: Wontae Kim, Nam Ik Cho · ECCV 2024
참고: 원문 · 공식 구현
1. 같은 색도 위치에 따라 다르게 보정할 수 있을까?
사진의 색과 밝기를 빠르게 보정하는 방법 중 하나가 3차원 룩업 테이블(3D LUT)이다. RGB 색 공간에 저장된 변환값을 조회하고, 격자 사이의 값은 보간해 출력 색을 구한다. 신경망이 이미지마다 적합한 LUT를 예측하면 적은 연산으로도 사진의 전체 분위기를 바꿀 수 있다. 다만 한 이미지 안에서는 같은 RGB를 같은 출력으로 바꾸기 때문에, 하늘은 유지하면서 어두운 전경만 밝히는 식의 국소 보정에 한계가 있다.
공간 정보를 넣는 기존 SA-3DLUT는 이 문제를 줄였지만 U-Net 계열 구조에 따른 모델 크기와 처리 시간 부담이 있었다. 이 논문은 해상도를 복원하는 긴 디코더 대신 양방향 격자(bilateral grid)에서 픽셀별 특징을 읽어 오는 방법을 택한다.
- 역할 분리: 양방향 격자는 위치에 따른 보정 특징을, 3D LUT는 최종 색 변환을 담당한다.
- 가벼운 복원: 작은 격자에서 보간으로 원래 해상도의 특징을 만들고, 1×1 합성곱으로 입력과 결합한다.
- 결과와 조건: FiveK에서 높은 보정 정확도와 작은 모델을 함께 얻었다. 다만 4K에서는 공간 특징을 처리하는 비용이 늘어나므로, 모든 LUT 방식보다 빠른 것은 아니다.
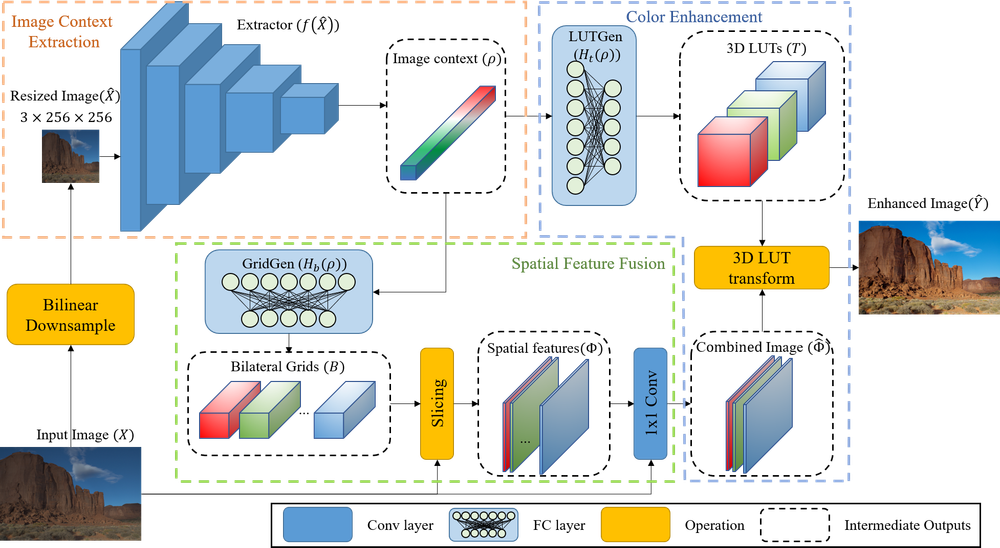
그림 1. 저자 공개 저장소의 전체 구조도이자 논문 Figure 1. 축소 영상은 변환을 예측하는 데 사용하지만, slicing과 최종 색 변환은 원래 해상도에서 수행한다. 출처: Kim·Cho, ECCV 2024 / 공식 구현. 원본 비율 유지.
2. 작은 격자로 원래 해상도의 공간 특징 만들기
2.1. 이미지 전체의 문맥으로 두 종류의 표를 예측한다
입력을 256×256으로 줄인 뒤 작은 CNN으로 이미지 문맥 벡터를 추출한다. 이 벡터에서 각각의 생성기인 GridGen과 LUTGen이 양방향 격자와 3D LUT를 만든다. 두 생성기는 작은 중간 차원을 거치는 완전연결층으로 구성되어, 큰 표를 바로 예측하는 부담을 줄인다.
이때 두 표의 축은 다르다. 3D LUT의 축은 세 색 채널이고, 양방향 격자의 축은 가로 위치·세로 위치·안내값이다. 따라서 전자는 어떤 색인지에, 후자는 어디에 있고 어떤 안내값을 갖는지에 반응한다.
2.2. Slicing: 위치와 입력 색으로 특징을 조회한다
Slicing은 격자의 한 평면을 단순히 잘라 내는 연산이 아니라, 각 픽셀에 대응하는 좌표에서 격자값을 보간해 특징 지도를 복원하는 연산이다. 이 모델은 별도 안내 지도 생성망 없이 입력의 R·G·B 채널을 번갈아 안내값으로 사용한다.
원문의 식 (5)를 조회 좌표까지 함께 적으면 다음과 같다.
\phi_c(x,y)=I_{\mathrm{tri}}\!\left(\left(\frac{x}{W-1},\frac{y}{H-1},X_{c\bmod 3}(x,y)\right),B_c\right)여기서 는 c번째 격자, 는 입력 영상, 는 영상의 폭과 높이다. 는 인접한 여덟 격자점을 쓰는 삼선형 보간이다. 같은 색이더라도 위치 좌표가 다르면 다른 특징값을 얻을 수 있다는 점이 일반적인 색 변환과의 차이다.
선택된 FiveK 모델은 17×17×17 격자 6개로 서로 다른 공간 특징을 만든다. 보간 자체에는 학습 파라미터가 없지만, 조회할 격자값과 뒤의 결합 연산은 학습된다. 따라서 전체 방법을 비학습 방식으로 이해하면 안 된다.
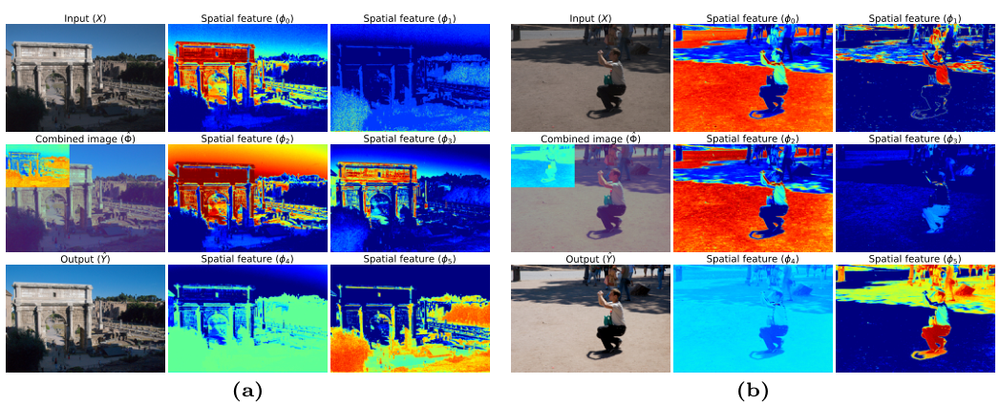
그림 2. 원문 Figure 5. 각 예시의 왼쪽 열은 입력·결합 영상·출력이며, 나머지는 여섯 특징 채널이다. 빨간색일수록 활성도가 높다. 특징은 밝고 어두운 영역이나 세부 구조에 서로 다르게 반응한다. 이는 저자의 예시 분석이며, 각 채널에 고정된 의미 라벨을 학습시킨 것은 아니다. 출처: 논문 p.11, Figure 5.
3. 공간 보정과 색 보정을 순서대로 적용한다
복원한 여섯 특징과 입력 RGB를 이어 붙인 다음, 1×1 합성곱으로 다시 3채널 영상으로 압축한다. 원문 식 (6)은 다음과 같다.
\widehat{\Phi}=\mathrm{Conv}_{1\times1}\!\left(\mathrm{Concat}(\Phi,X)\right)1×1 합성곱 자체는 이웃 픽셀을 보지 않는다. 하지만 입력 특징에 이미 위치 정보가 반영되어 있으므로, 같은 합성곱 가중치를 적용해도 위치마다 다른 조정을 할 수 있다. 만들어진 3채널 값이 마지막 LUT의 조회 좌표가 된다.
\widehat{Y}_c(x,y)=I_{\mathrm{tetra}}\!\left(\widehat{\Phi}(x,y),T_c\right)는 출력 색 채널별 LUT이다. 여기서는 셀을 사면체로 나눈 뒤 네 꼭짓점을 사용하는 사면체 보간(tetrahedral interpolation)을 적용한다. 중요한 점은 두 단계에 같은 보간법을 강제하지 않았다는 것이다. 원문 Table 5에서 격자와 LUT를 모두 삼선형으로 처리하면 PSNR 25.57 dB였고, 격자는 삼선형·LUT는 사면체로 처리하면 25.66 dB였다. 반대로 둘 다 사면체로 바꾸면 25.50 dB로 낮아졌다.
학습 손실은 원문 식 (9)의 조합을 쓴다.
\mathcal{L}=\mathcal{L}_b+0.005\mathcal{L}_c+0.05\mathcal{L}_p기본 손실은 영상 복원 오차와 LUT의 매끄러움·단조성 제약을 포함한다. 여기에 CIE94 색차 손실과 AlexNet 기반 LPIPS 지각 손실을 더한다. 이 LUT 제약을 양방향 격자에도 동일하게 걸지는 않는다. 보충자료에서는 격자를 매끄럽거나 단조롭게 제한하면 성능이 낮아져, 격자가 공간 특징을 자유롭게 표현하도록 두었다고 설명한다.
4. 실험 결과: 화질·모델 크기·속도를 함께 보기
4.1. FiveK 사진 보정
FiveK에서는 전문가 C의 보정 사진을 정답으로 사용하고, 4,500쌍으로 학습해 500쌍으로 평가했다. 학습은 480p 영상을 사용하며, 평가에는 480p와 원래 해상도인 4K를 모두 포함한다. 아래는 원문 Table 6의 주요 LUT 계열 결과다. PSNR·SSIM은 높을수록, 색차 ΔEab는 낮을수록 좋다.
| 방법 | 파라미터 | 480p PSNR (dB) | 480p SSIM | 480p ΔEab | 480p 시간 (ms) | 4K 시간 (ms) |
|---|---|---|---|---|---|---|
| 3D LUT | 593.5K | 25.29 | 0.923 | 7.55 | 1.17 | 1.49 |
| SA-3DLUT* | 4.5M | 25.50 | 미제공 | 미제공 | 2.27 | 4.39 |
| SepLUT* | 119.8K | 25.47 | 0.921 | 7.54 | 1.10 | 1.20 |
| AdaInt | 619.7K | 25.49 | 0.926 | 7.47 | 1.29 | 1.59 |
| 제안 방법 | 463.7K | 25.66 | 0.930 | 7.29 | 1.20 | 3.64 |
출처: 원문 p.12, Table 6. 별표 방법의 결과는 비교 논문에서 인용한 값이다. 저자 실험 환경은 NVIDIA Tesla V100이며, 처리 시간은 같은 평가 영상 집합에서 100회 실행해 평균했다. 입력 읽기·저장·화면 출력까지 포함하는 애플리케이션 전체 지연으로 해석해서는 안 된다.
제안 방법은 SA-3DLUT보다 훨씬 작은 모델로 더 높은 480p PSNR을 보인다. 4K에서도 PSNR 25.66 dB, SSIM 0.937, ΔEab 7.27을 보고했다. 그러나 4K 처리 시간은 3.64 ms로, SA-3DLUT보다는 짧지만 일반 3D LUT·SepLUT·AdaInt보다는 길다. 이 연구의 장점은 무조건적인 최고 속도가 아니라, 공간 보정 능력과 처리 비용 사이의 절충이다.
보충자료 Table 3은 그 이유를 보여 준다. 입력과 공간 특징을 결합하는 Fusion 시간이 480p의 0.09 ms에서 4K의 1.64 ms로 늘어 가장 큰 증가 요인이 된다. 작은 영상에서 표를 예측하는 비용은 거의 유지되지만, 원래 해상도에서 수행하는 연산은 해상도 영향을 받는 것이다.
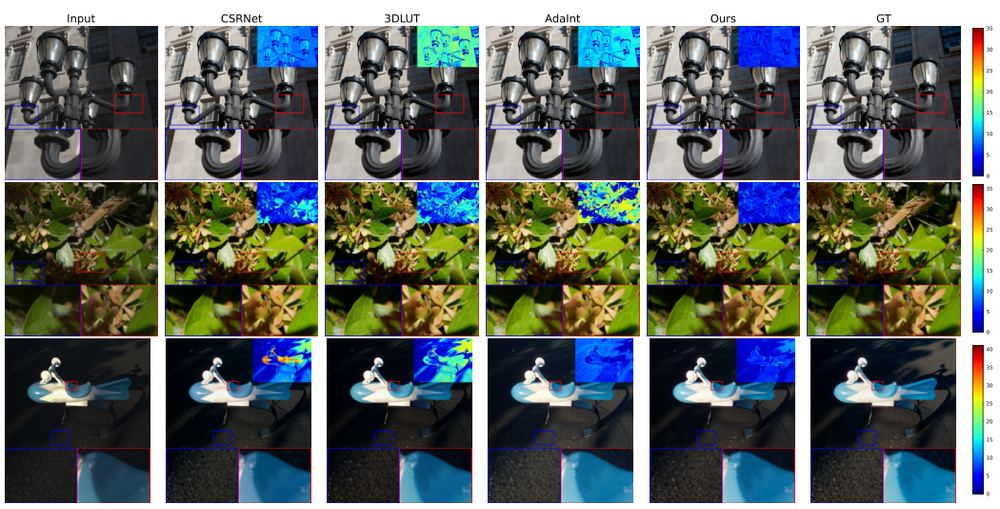
그림 3. 원문 Figure 6. 왼쪽부터 입력·CSRNet·3DLUT·AdaInt·제안 방법·정답이다. 각 결과의 작은 오차 지도와 오른쪽 색 막대는 정답과의 차이를 나타낸다. 저자는 어두운 영역의 보정, 잎의 색, 바닥과 좌석의 색이 개선되는 사례를 제시한다. 출처: 논문 p.13, Figure 6.
4.2. 톤 매핑과 인물 사진 보정
FiveK 톤 매핑은 사진 보정과 입력 조건이 다르다. 16-bit CIE XYZ 입력을 8-bit sRGB 정답에 맞추는 실험으로, 제안 방법은 PSNR 25.59 dB, SSIM 0.932, ΔEab 7.14를 기록했다. 이 결과를 앞의 sRGB 사진 보정 결과와 같은 과제로 섞어 비교하면 안 된다.
인물 사진 데이터인 PPR10K에서는 전문가 a·b·c별로 학습과 평가를 분리한다. 아래는 360p에서 평가한 PSNR이며, 제안 방법이 비교적 일관되게 향상되지만 차이는 크지 않다.
| PPR10K 정답 스타일 | AdaInt PSNR (dB) | 제안 방법 PSNR (dB) |
|---|---|---|
| 전문가 a | 26.33 | 26.45 |
| 전문가 b | 25.40 | 25.48 |
| 전문가 c | 25.68 | 25.72 |
출처: 원문 p.12, Table 8. 학습 8,875쌍·평가 2,286쌍의 공식 분할을 사용한다. PPR10K 실험은 문맥 추출기를 사전학습 ResNet-18로 바꾸고 LUTGen 중간 차원도 늘리므로, 앞의 FiveK 모델 파라미터 463.7K를 그대로 적용할 수 없다.
5. 설계에서 읽을 수 있는 점과 한계
이 논문의 핵심은 더 깊은 공간 처리망을 붙이는 대신, 작은 격자에 공간적 변환을 예측하고 필요한 위치에서 읽어 온다는 데 있다. 공간 특징 생성과 색 변환을 분리하면 3D LUT의 빠른 조회 구조를 유지하면서도 국소 보정을 추가할 수 있다.
설계는 복잡할수록 좋은 것도 아니었다. 별도 안내 지도 생성기를 추가한 실험은 오히려 정확도가 낮아졌고, 격자의 정규화도 도움이 되지 않았다. 다만 이를 모든 이미지 처리 과제의 일반 법칙으로 확대해서는 안 된다. 이 모델과 데이터·학습 조건에서의 관찰이다.
남는 제약도 분명하다.
- 해상도 비용: 공간 특징을 원래 해상도에서 결합하므로 4K에서 시간이 늘어난다. 저자는 더 높은 해상도나 높은 프레임률을 위한 패치·슈퍼픽셀 단위 처리를 후속 방향으로 제안한다.
- 평가 범위: 전문가의 보정 스타일을 정답으로 둔 사진 실험이다. 보고된 속도만으로 모바일 성능이나 영상의 시간적 일관성까지 입증된 것은 아니다.
- 재현 설정: 논문에서 선택한 격자 수는 6개지만, 공개
models.py의 클래스 기본값은 9개이며 생성기의 중간 차원도 다르다. 구현을 사용할 때는 기본 인자만 믿지 말고 실험·체크포인트 설정을 맞춰야 한다. 이 글은 저자 보고 결과를 정리한 것이며 모델 학습·추론을 재현하지 않았다.
정리하면, 이 연구는 색만 보던 LUT에 위치 의존성을 더하되, 그 비용을 작은 격자와 보간으로 제어한 방법이다. 고해상도 사진 보정에서 화질과 처리량을 함께 고려할 때 참고할 만한 구조다.
답글 남기기