① CVPR 2008: A Discriminatively Trained, Multiscale, Deformable Part Model
Pedro Felzenszwalb, David McAllester, Deva Ramanan. 출판 정보·원문
② TPAMI 2010: Object Detection with Discriminatively Trained Part-Based Models
Pedro F. Felzenszwalb, Ross B. Girshick, David McAllester, Deva Ramanan. IEEE TPAMI 32(9), 1627–1645. 논문 · 출판 정보
1. 두 논문을 관통하는 질문
사람의 팔·다리는 움직이고, 자동차와 자전거는 보는 방향에 따라 모습이 크게 달라진다. 물체를 고정된 틀 하나로 찾으면 이런 변화를 놓친다. 하지만 부품을 움직이게 하는 복잡한 모델도, 부품 위치가 표시되지 않은 데이터에서 잘 학습하지 못하면 단순한 검출기보다 나쁠 수 있다. 두 논문은 표현력이 높은 모델을 실제로 잘 학습하고 빠르게 탐색하려면 무엇이 필요한가를 함께 다룬다.
- 2008년: 전체 모양을 보는 root와 고해상도 부품을 결합하고, 부품 위치를 숨은 변수로 두는 latent SVM으로 학습했다. 변형 가능한 부품이 어려운 실제 검출 데이터에서도 유효함을 보였다.
- 2010년: 하나의 부품 모델을 여러 구성요소의 혼합으로 확장했다. 학습 목적함수의 최적화, HOG 특징, 상자 보정과 문맥 재점수화까지 개선했다. 단순히 부품 수만 늘린 후속 논문이 아니다.
- 공통 전제: 클래스와 물체 상자 라벨은 필요하지만 부품별 정답은 필요하지 않다. 라벨이 전혀 없는 비지도 학습도, 이미지 특징을 신경망으로 학습하는 현대 검출기도 아니다.
아래에는 두 논문의 모든 번호 그림·표, 2008년의 번호 없는 실험 표와 2010년의 학습 절차 도표를 담았다. 그림 안의 영문은 원문 캡션이며, 바로 아래는 한국어 해설이다. 이미지 또는 ‘크게 보기’를 누르면 고해상도 원본을 새 탭에서 확대할 수 있다.
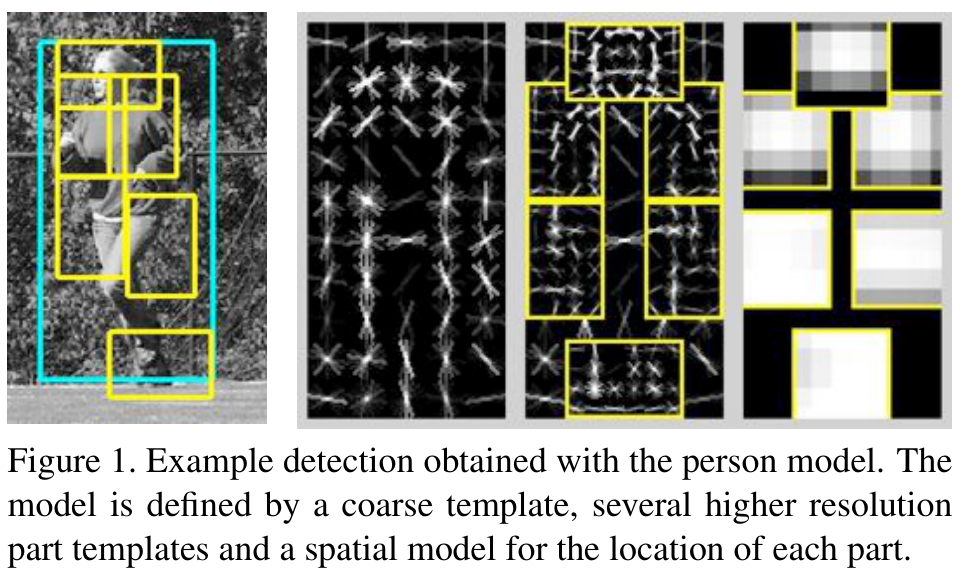
크게 보기: CVPR 2008 fig01 원문 전체 패널과 캡션
CVPR 2008 Figure 1: 사람 검출과 모델의 전체 구성. 왼쪽의 검출 사진, 전체 윤곽을 보는 root, 더 세밀한 부품 필터, 부품 위치의 공간 모델을 함께 보여 준다. 출처: ①, p.1.
2. CVPR 2008: 전체는 거칠게, 부품은 자세하게
같은 물체를 두 해상도에서 본다
HOG(방향성 그래디언트 히스토그램)는 작은 영역의 경계가 어떤 방향으로 강한지 요약한 특징이다. 이미지를 여러 크기로 줄여 HOG 피라미드를 만들고, 그 위를 필터로 훑는다. 이 논문은 셀마다 9개 방향과 4개 정규화를 결합한 36차원 특징을 사용한다.
root 필터는 물체 전체를 낮은 해상도에서 보고, 부품 필터는 공간 해상도가 두 배인 층에서 더 작은 부분을 자세히 본다. 단순히 같은 특징 맵에서 큰 창과 작은 창을 쓰는 것과 다르다.
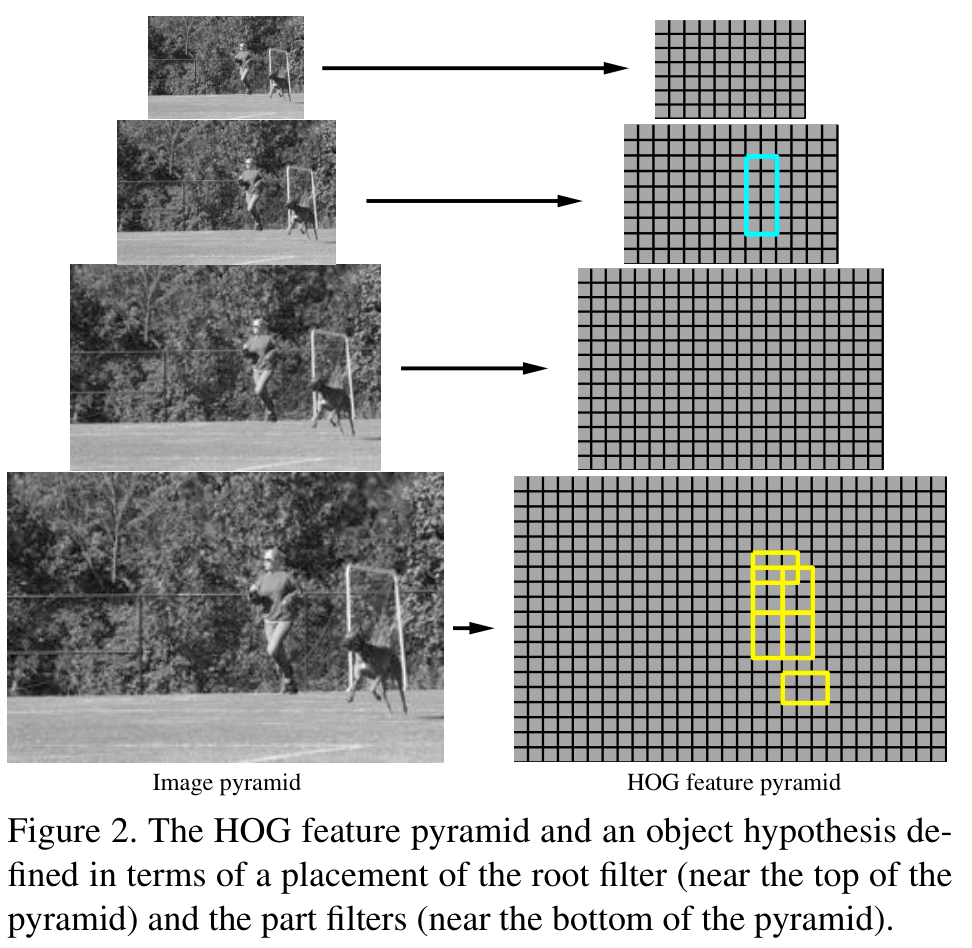
크게 보기: CVPR 2008 fig02 원문 전체 패널과 캡션
CVPR 2008 Figure 2: 왼쪽은 이미지 피라미드, 오른쪽은 HOG 피라미드다. root와 부품을 다른 해상도에 배치해 전체 윤곽과 세부 경계를 함께 사용한다. 출처: ①, p.2.
각 후보의 점수는 root의 외형 점수 + 부품의 외형 점수 + 상대 배치의 공간 점수다. 부품은 허용된 범위에서 움직일 수 있지만, 그 위치가 전체와 어울리는지도 평가받는다. 2008년은 제한된 이동 영역 안의 이차 공간 점수를 사용하며, 이를 2010년의 변형 비용 표기와 완전히 같은 제약이라고 보아서는 안 된다.
root를 고정하면 부품끼리 직접 연결되지 않는 별 모양 구조이므로, 각 부품의 최적 위치를 따로 계산할 수 있다. 동적 계획법과 거리 변환을 이용해 모든 부품 조합을 일일이 열거하지 않는다.
부품 위치를 모르는 상태에서 학습하기
두 논문의 핵심 점수 함수는 다음과 같다.
f_\beta(x)=\max_{z\in Z(x)}\beta^\top\Phi(x,z)2008년 식 (2), 2010년 식 (13)에 해당한다. β는 학습할 파라미터, x는 예제, z는 root·부품의 배치와 같은 잠재변수, Φ는 그 배치의 특징이다. 허용된 배치 중 가장 높은 점수를 택한다. 양성 예제에서는 root 창이 주어진 정답 상자와 충분히 겹치도록 제한한다.
학습은 현재 모델로 양성의 좋은 배치를 찾는 단계와 파라미터를 갱신하는 단계를 반복한다. 또한 배경 전체를 한꺼번에 저장하는 대신 hard-negative mining으로 오검출하거나 마진을 침범하는 어려운 배경을 모아 학습한다.
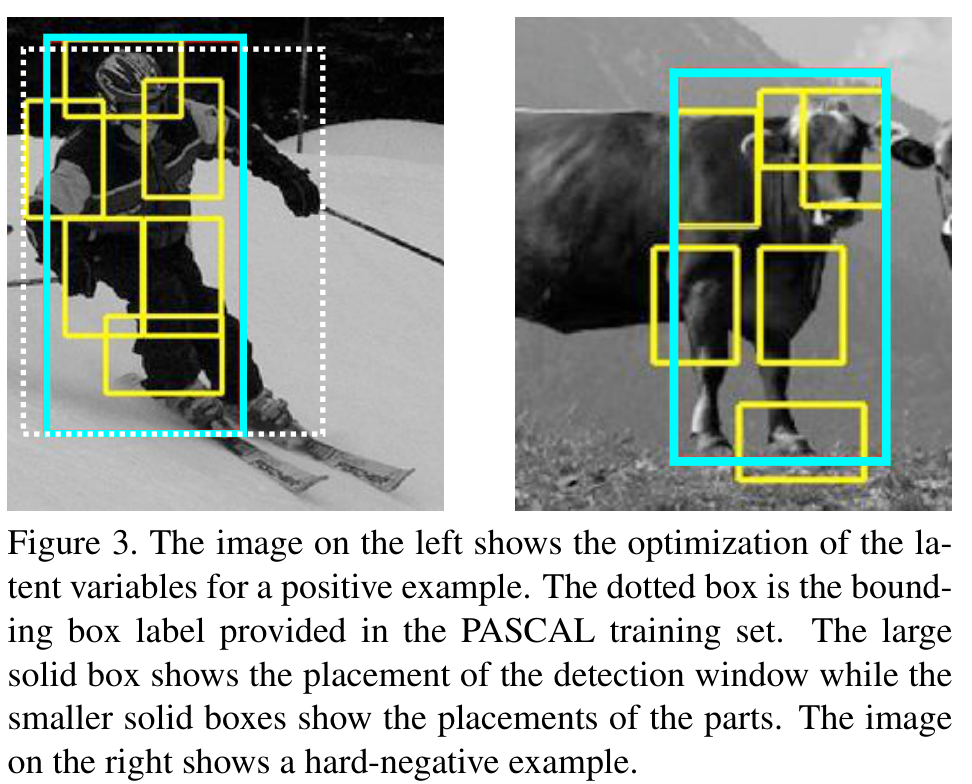
크게 보기: CVPR 2008 fig03 원문 전체 패널과 캡션
CVPR 2008 Figure 3: 왼쪽은 정답 상자(점선) 근처에서 root와 부품의 배치를 다시 고르는 양성 예제다. 오른쪽은 사람 모델이 잘못 반응한 어려운 음성 예제다. 단순한 랜덤 배경보다 이런 사례가 판별 경계를 학습하는 데 중요하다. 출처: ①, p.5.
중요한 구분이 있다. 이론적으로는 양성의 잠재변수만 고정하면 볼록 하위 문제가 되지만, 2008년 구현은 SVMlight를 사용하는 휴리스틱 근사다. 양성·음성에서 고른 배치를 학습 예제로 만드는 구현과 이론적 latent SVM 최적화가 완전히 같지는 않다. 이 차이를 2010년 논문이 직접 개선한다. 전체 학습의 전역 최적해가 보장되는 것은 아니다.
무엇이 실제로 좋아졌나?
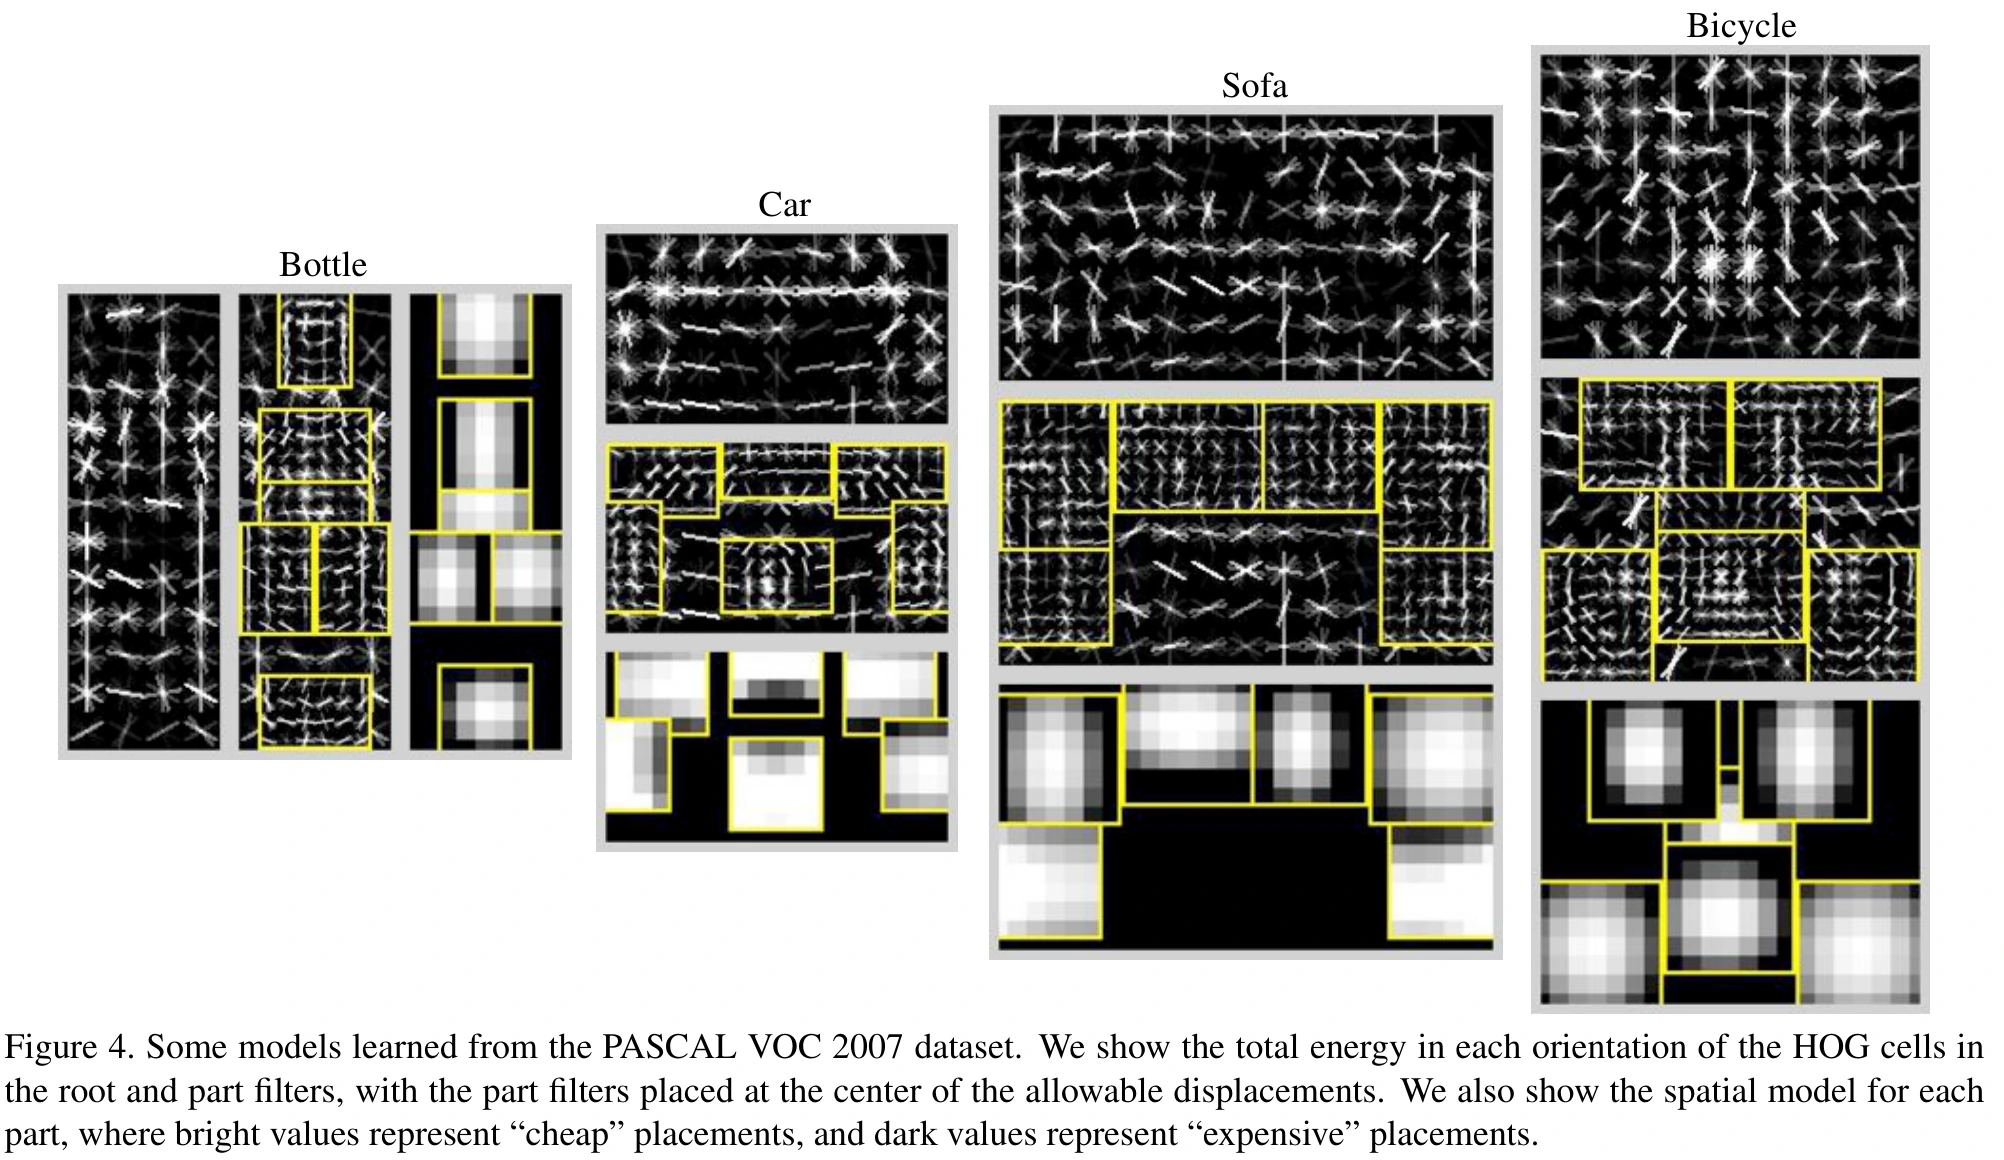
크게 보기: CVPR 2008 fig04 원문 전체 패널과 캡션
CVPR 2008 Figure 4: 병·자동차·소파·자전거 모델 전체. 각 모델의 root, 부품 필터, 공간 점수를 보여 준다. 밝은 위치는 배치 비용이 작고 어두운 위치는 크다. 학습되는 부품이 반드시 사람이 이름 붙인 의미적 부품일 필요는 없다. 출처: ①, p.6.
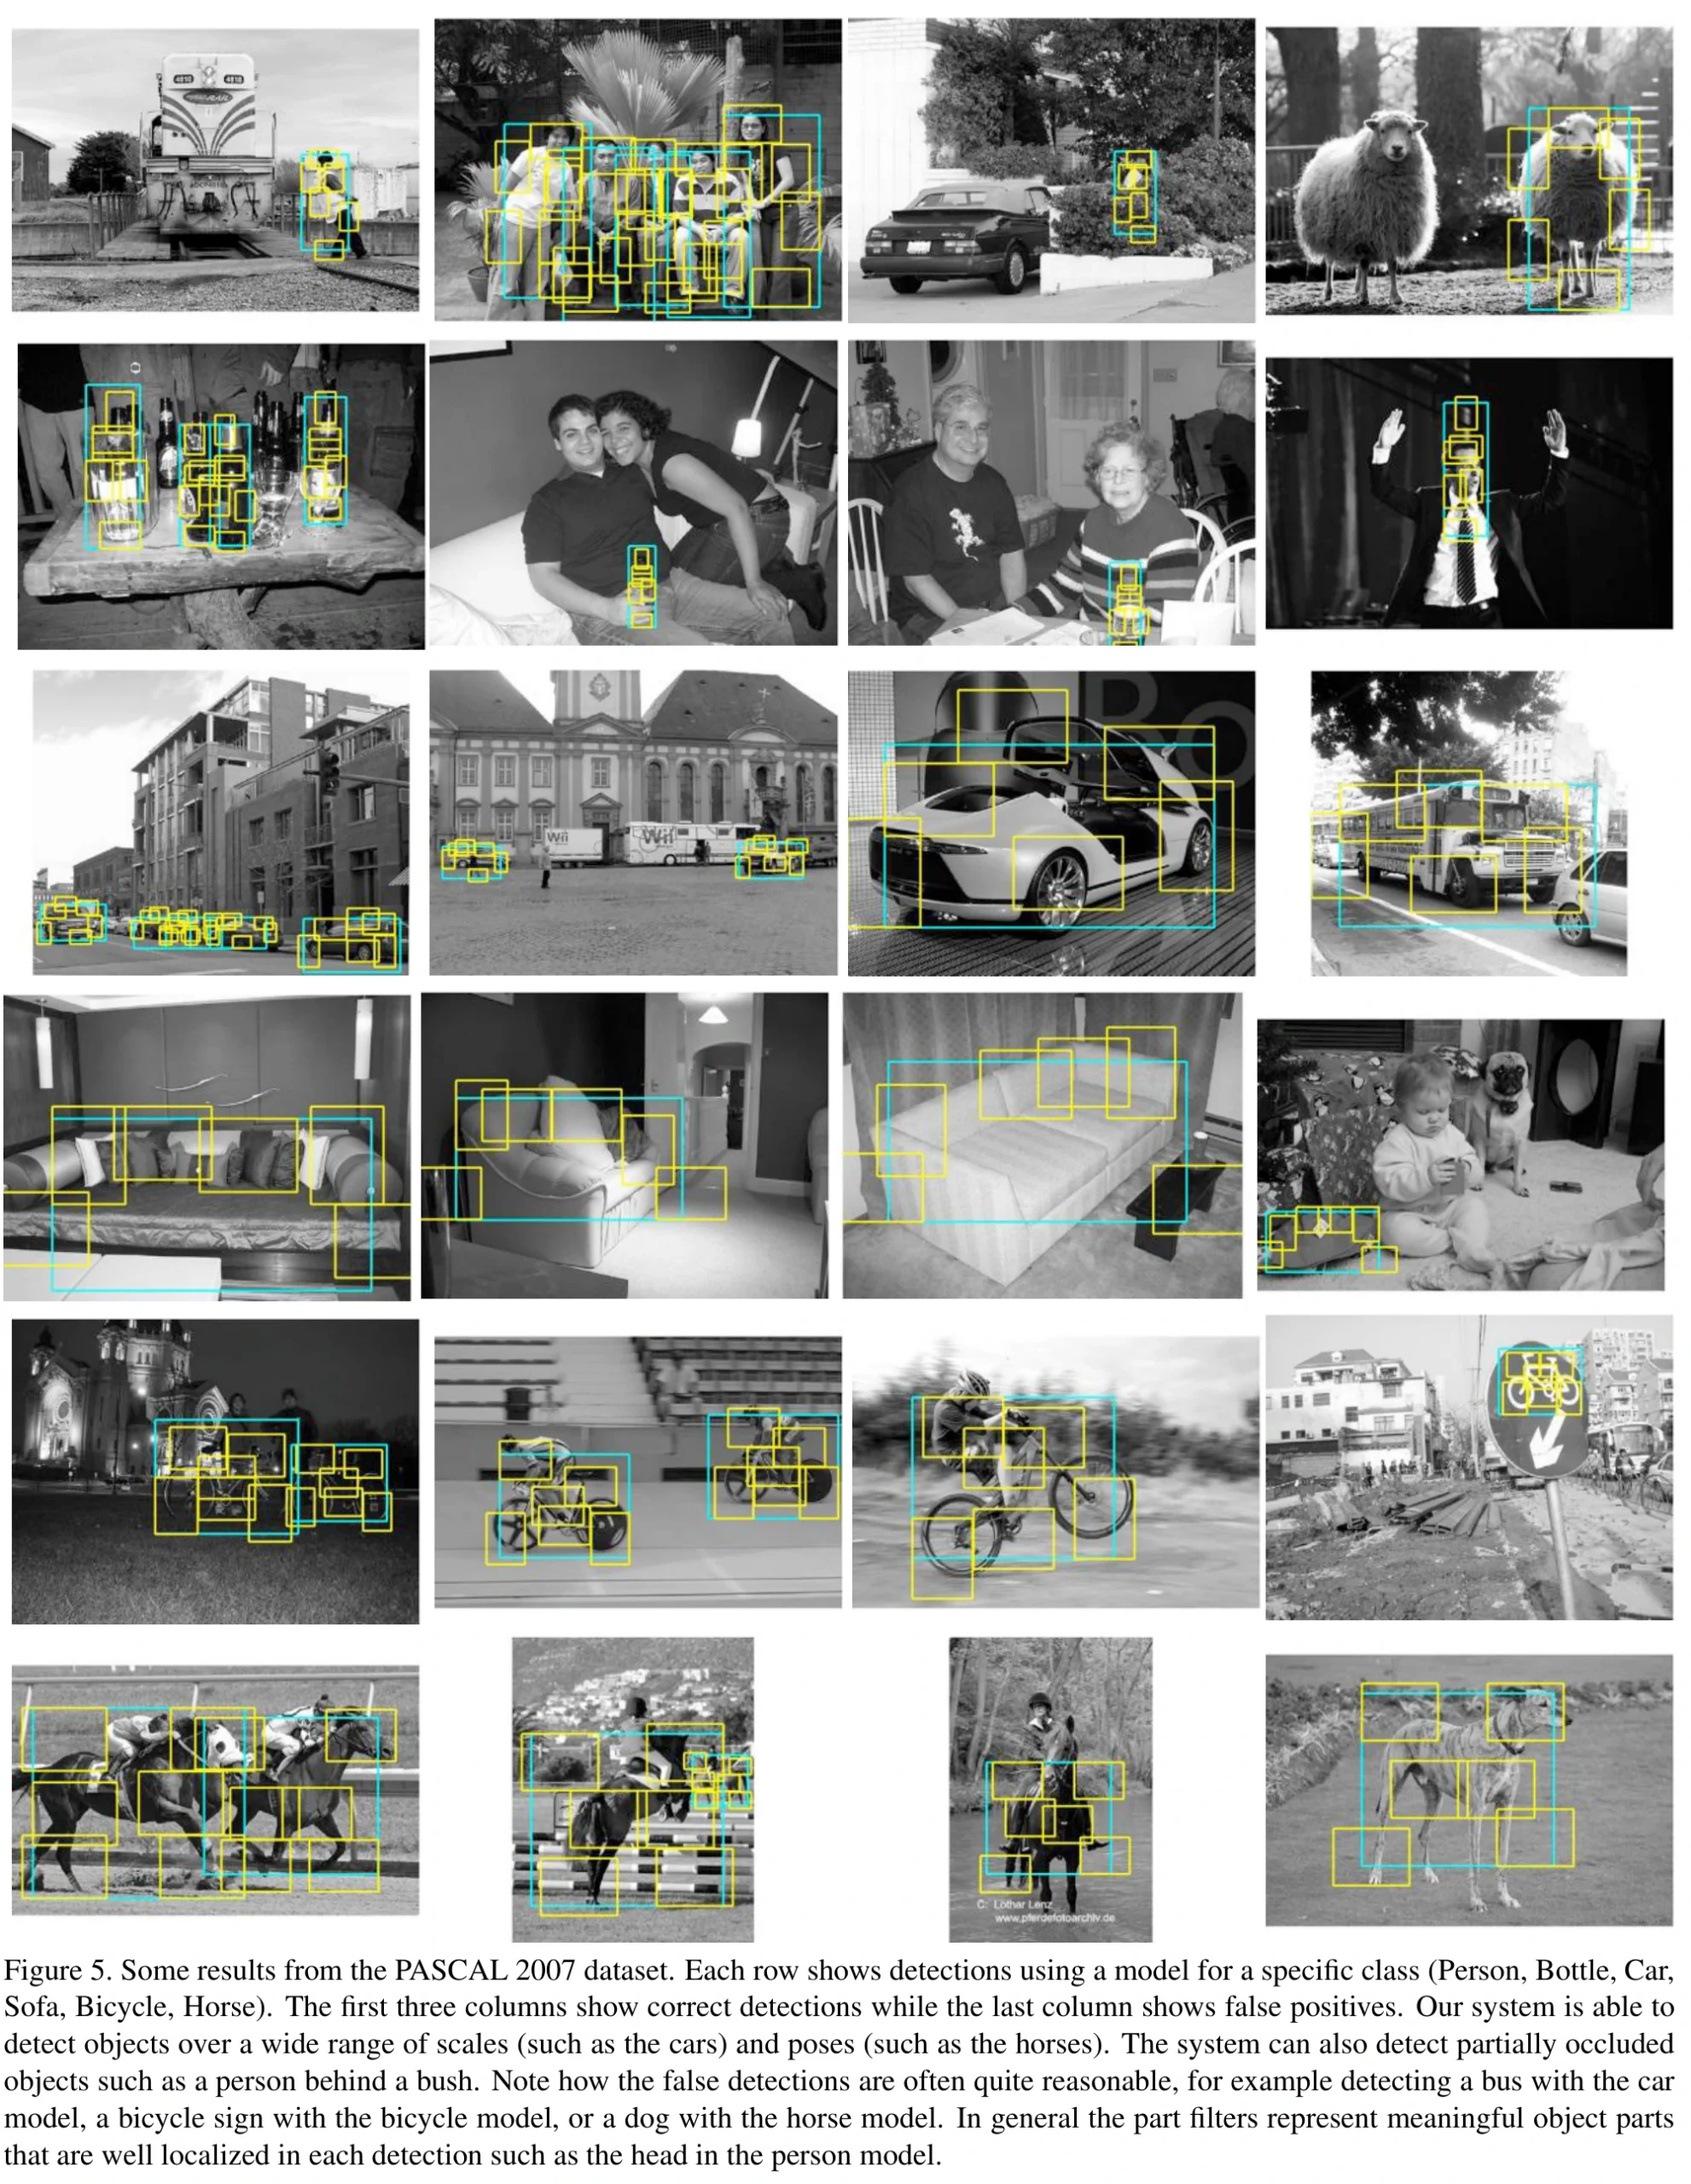
크게 보기: CVPR 2008 fig05 원문 전체 패널과 캡션
CVPR 2008 Figure 5: 위에서부터 사람·병·자동차·소파·자전거·말의 여섯 행이다. 각 행의 앞 세 열은 정검출, 마지막 열은 오검출이다. 크기·자세 변화와 부분 가림에 대응하지만 자동차와 버스, 말과 개처럼 비슷한 외형을 혼동한다. 출처: ①, p.7. 모든 행·열을 보존했다.
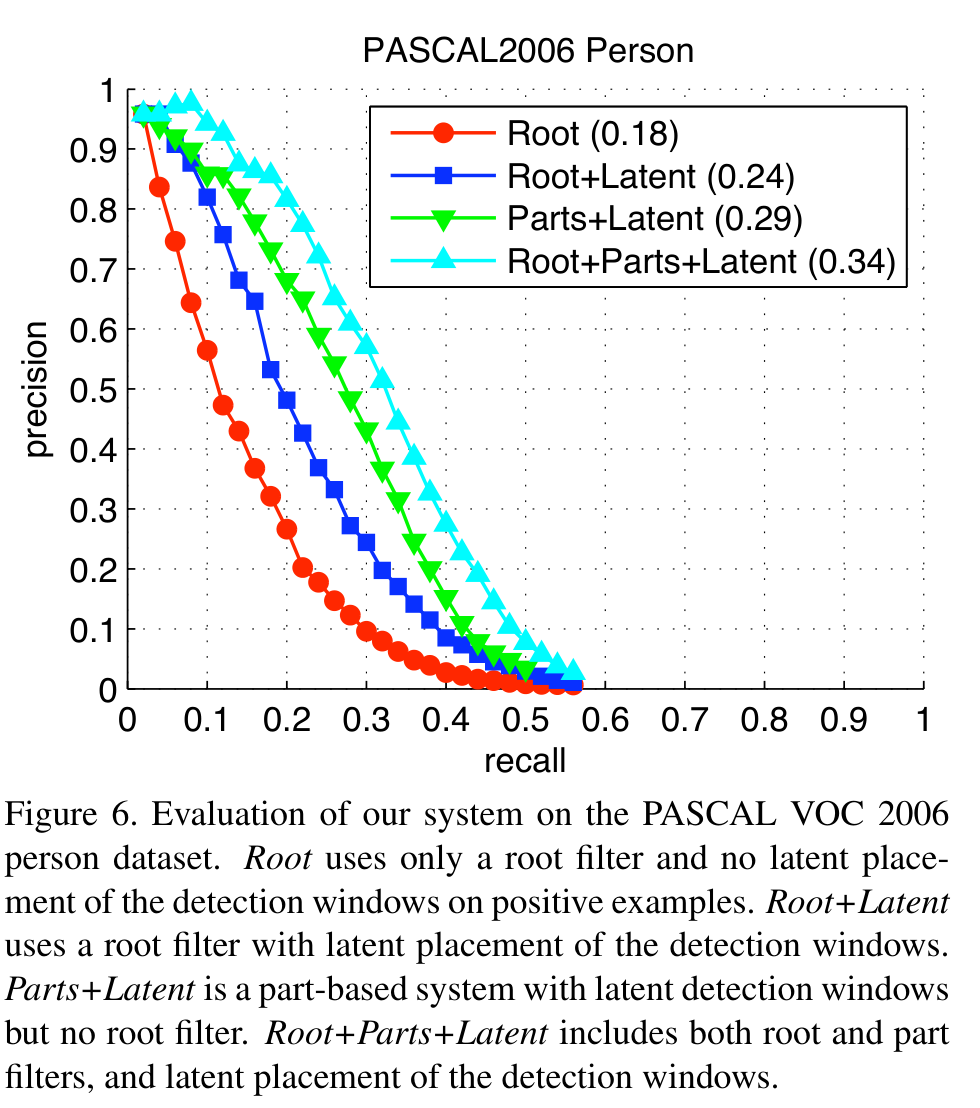
크게 보기: CVPR 2008 fig06 원문 전체 패널과 캡션
CVPR 2008 Figure 6: VOC 2006 사람 검출의 precision–recall 곡선. 범례의 AP는 root만 0.18, root+latent 0.24, 부품+latent 0.29, root+부품+latent 0.34다. 출처: ①, p.8.
여기서 핵심은 배치 재추정만으로도 0.18→0.24, 여기에 부품을 더하면 0.24→0.34가 된다는 점이다. 부품만 쓴 0.29보다 전체와 부품을 함께 쓴 0.34가 높아 다중 해상도의 이점도 드러난다. 초록의 ‘두 배’는 당시 대회 우승 점수 0.16과의 비교이지, 모든 비교 모델 대비 정확히 두 배라는 뜻은 아니다.
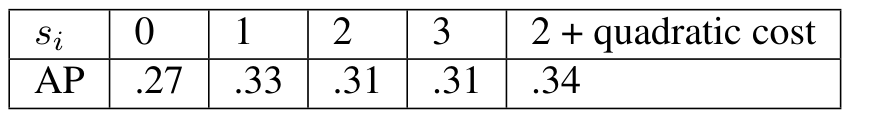
크게 보기: CVPR 2008 table-unnumbered 원문 전체 패널과 캡션
CVPR 2008 p.8의 번호 없는 실험 표: 부품의 자유 이동 허용량과 AP. 원문에는 별도 표 번호·캡션이 없다. 출처: ①, §4.
부품을 고정하면 AP 0.27, 비용 없이 1셀 움직이면 0.33, 2·3셀로 더 풀면 모두 0.31이다. 반면 2셀 이동에 이차 비용을 적용하면 0.34다. 자유를 많이 주는 것보다, 외형의 이득과 배치의 타당성을 함께 평가하는 것이 중요하다.
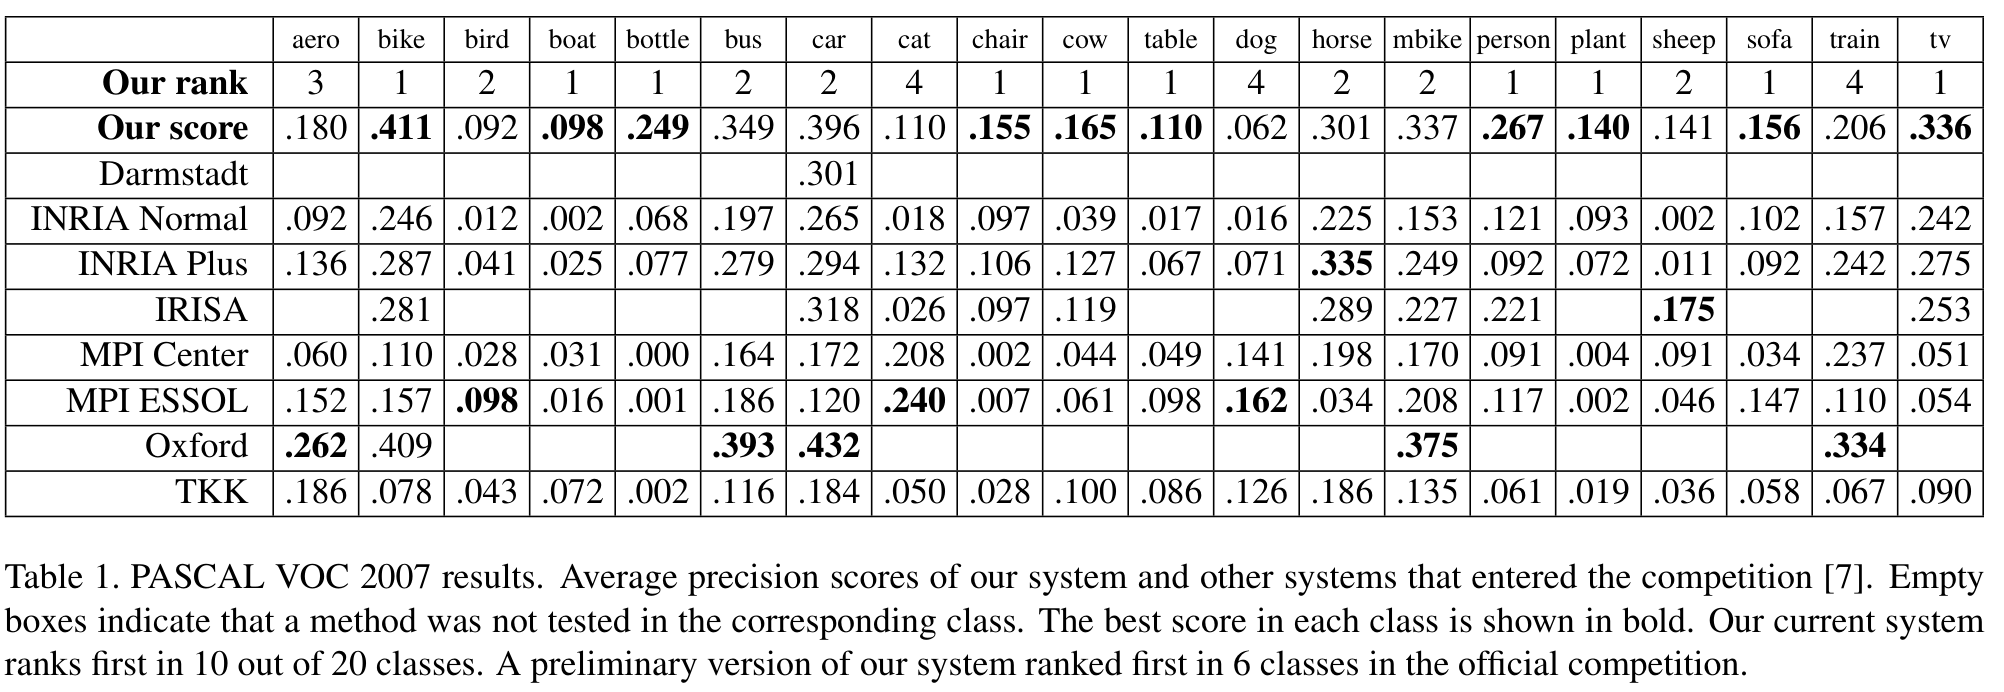
크게 보기: CVPR 2008 table01 원문 전체 패널과 캡션
CVPR 2008 Table 1: VOC 2007의 20개 클래스와 모든 비교 시스템. 빈칸은 해당 클래스에서 평가하지 않았다는 뜻이다. 출처: ①, p.6.
저자들의 최종 시스템은 당시 대회 참가 시스템과 비교해 20개 클래스 중 10개에서 1위, 6개에서 2위였다. 공식 대회에 낸 예비 버전은 6개 클래스에서 1위였으므로 두 수치를 구분해야 한다. 표의 AP는 클래스별 값이며 mAP 하나를 의미하지 않는다.
3. TPAMI 2010: 변형과 큰 외형 변화를 분리한다
하나의 변형 모델에서 여러 모델의 혼합으로
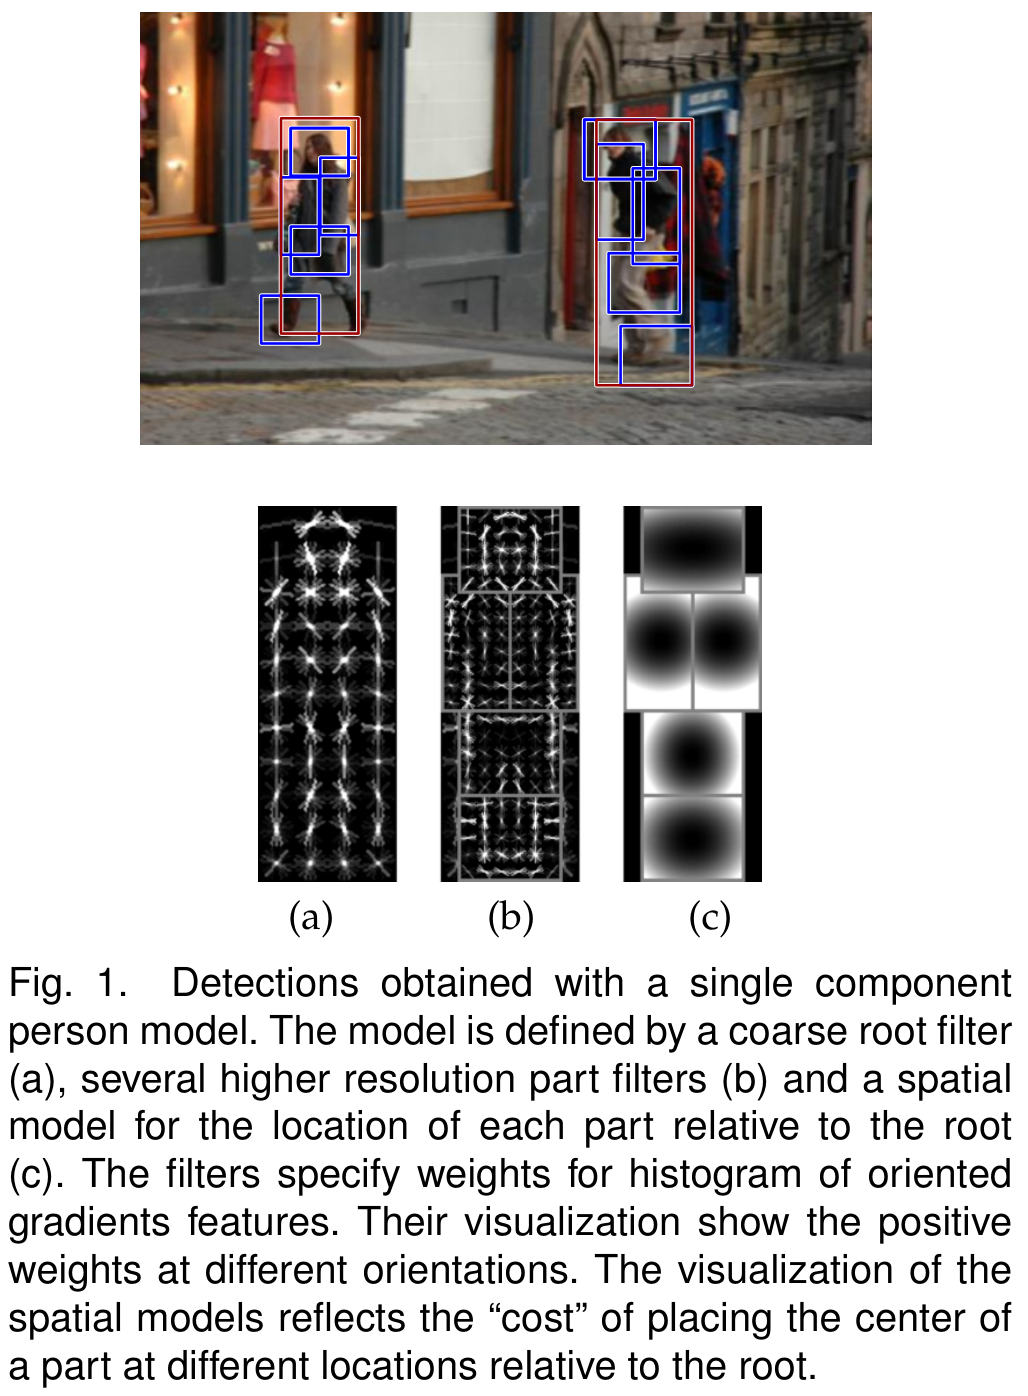
크게 보기: TPAMI 2010 fig01 원문 전체 패널과 캡션
TPAMI 2010 Figure 1: 단일 구성요소 사람 모델의 검출 예와 (a) root, (b) 고해상도 부품, (c) 공간 비용. 2008년 Figure 1과 같은 원리를 보여 주지만 서로 다른 원문 그림이다. 출처: ②, p.2.
팔·다리가 조금 움직이는 것은 부품 이동으로 표현할 수 있다. 그러나 자전거 정면과 측면처럼 전체 모양이 크게 달라지면 하나의 모델을 심하게 변형시키는 것보다 서로 다른 구성요소 중 하나를 선택하는 편이 낫다. 혼합 모델은 각 구성요소의 최고 점수 중 최댓값을 쓴다. 점수를 평균하는 앙상블이 아니다.
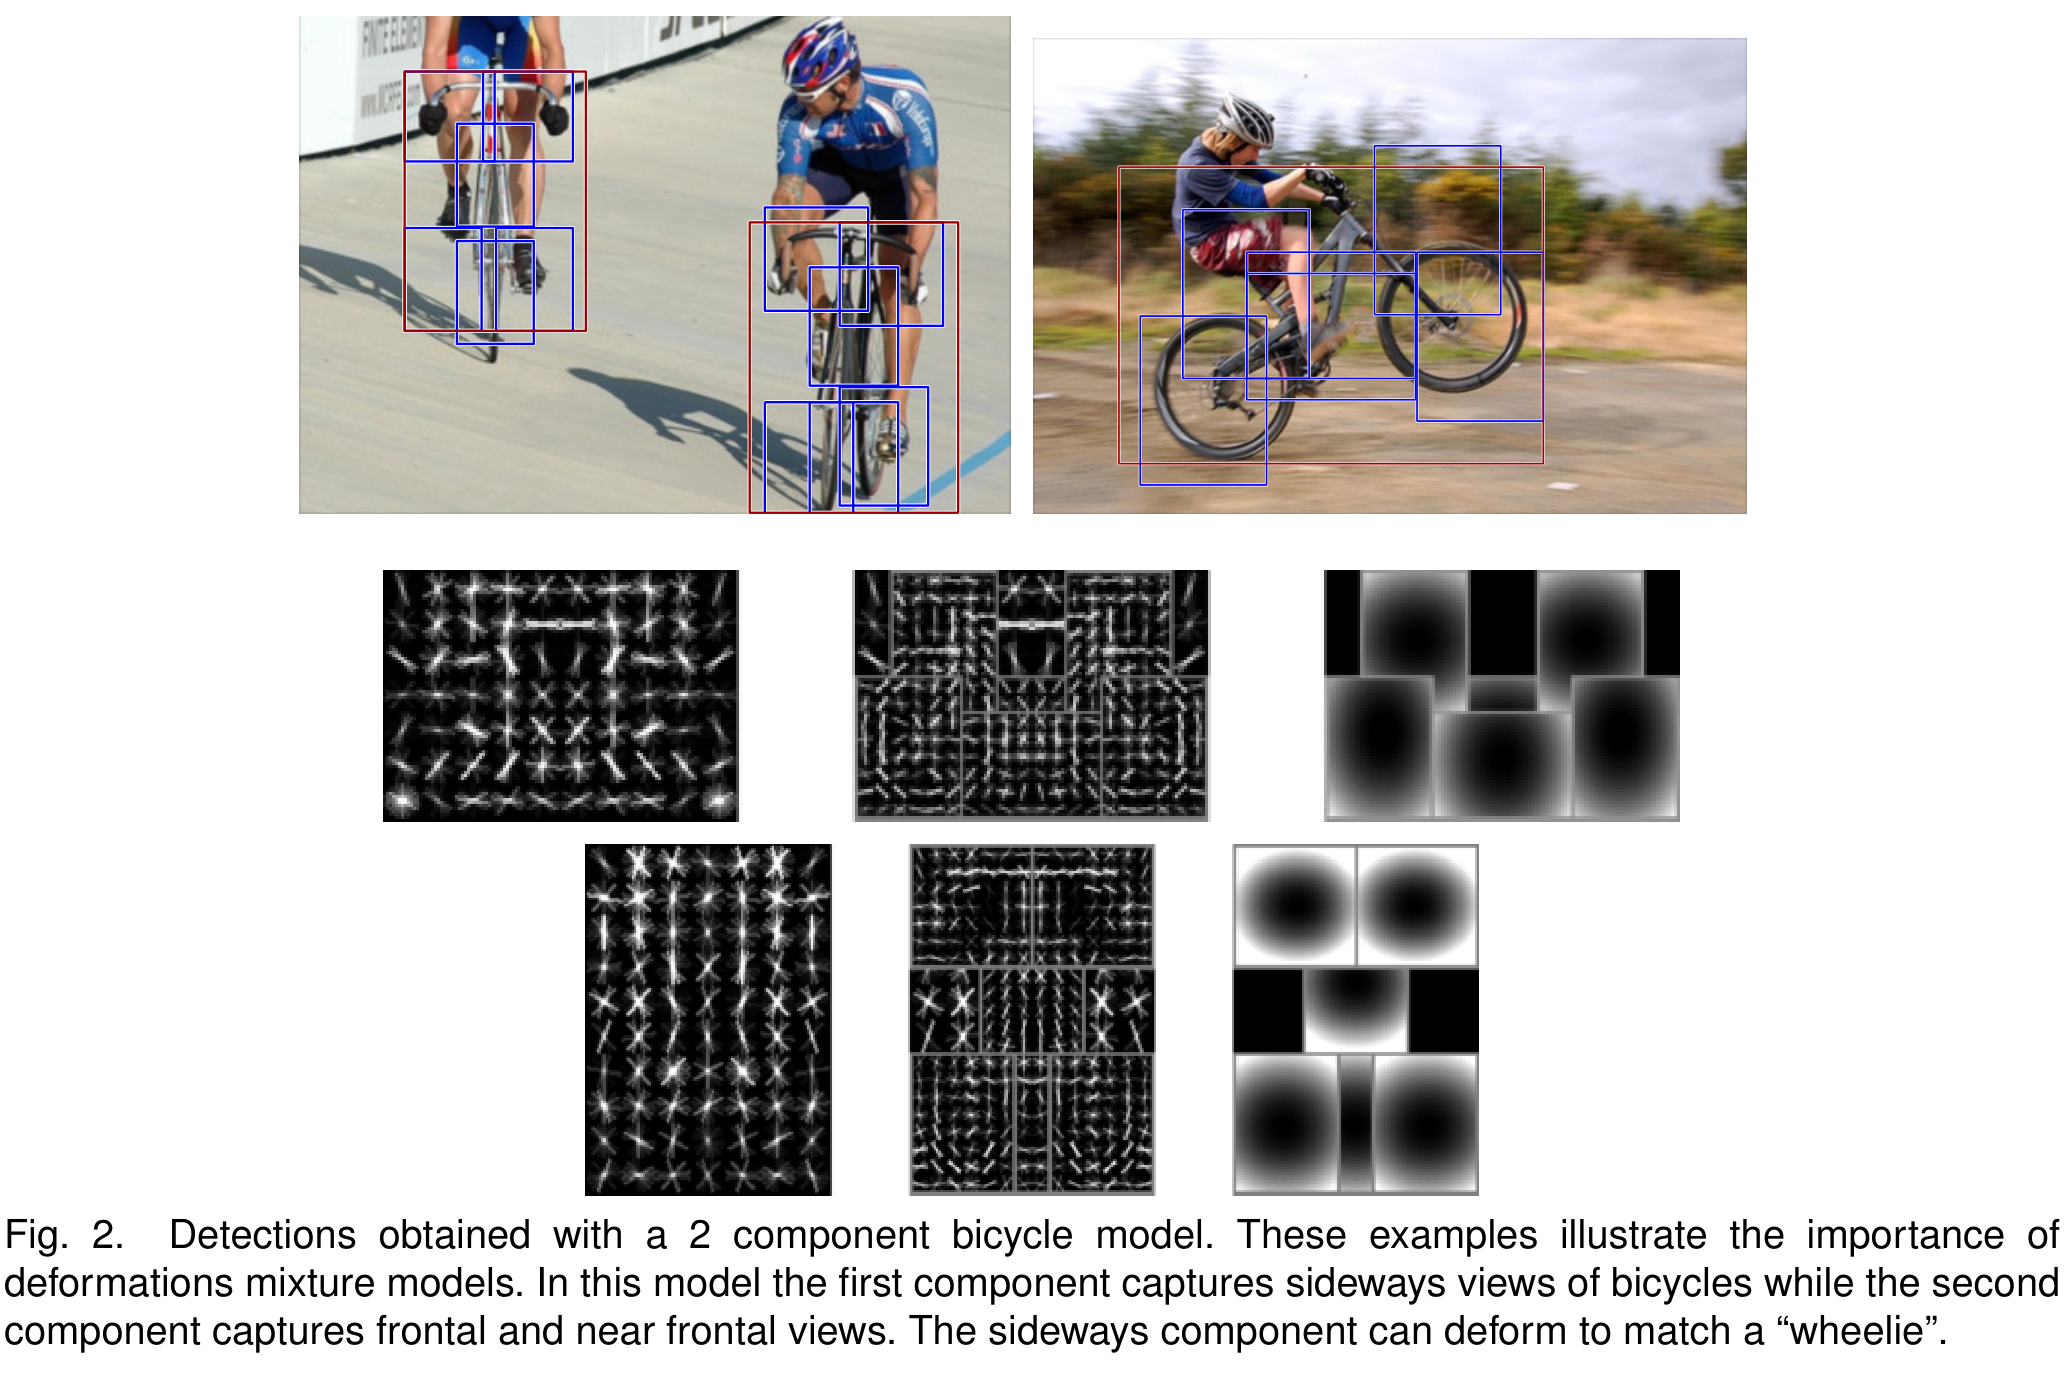
크게 보기: TPAMI 2010 fig02 원문 전체 패널과 캡션
TPAMI 2010 Figure 2: 측면과 정면·준정면을 담당하는 두 자전거 모델. 오른쪽 사진의 앞바퀴를 든 자세는 측면 모델의 부품 변형으로 대응한다. 즉, 혼합은 큰 외형 차이를, 변형은 같은 구성요소 안의 자세 변화를 다룬다. 출처: ②, p.3.
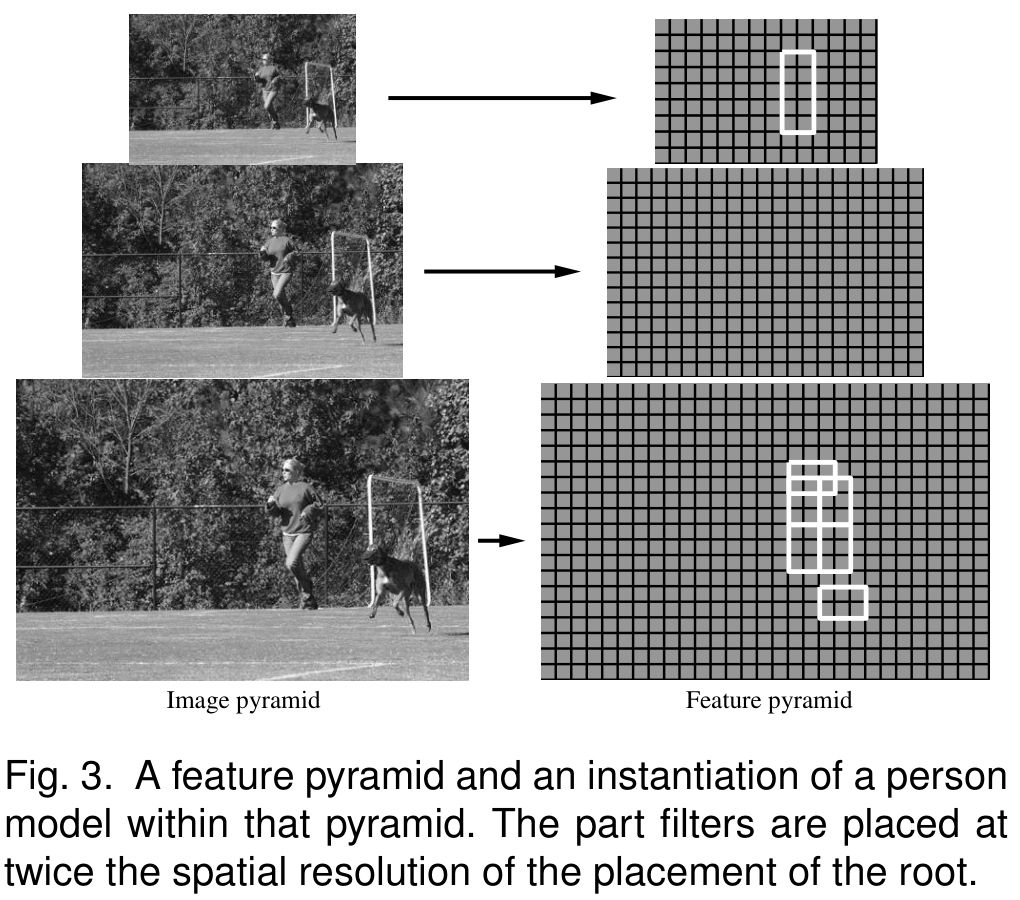
크게 보기: TPAMI 2010 fig03 원문 전체 패널과 캡션
TPAMI 2010 Figure 3: 특징 피라미드 안의 root와 부품 배치. 부품에 두 배의 공간 해상도를 쓰는 원칙은 유지된다. 출처: ②, p.5.
2010년 단일 구성요소의 점수는 다음과 같다. 원문 식 (2)의 필터 벡터 표기를 정리했다.
S(p_0,\ldots,p_n)=\sum_{i=0}^{n}F_i^\top\phi(H,p_i)-\sum_{i=1}^{n}d_i^\top\phi_d(\Delta x_i,\Delta y_i)+bH는 특징 피라미드, p는 위치·스케일, F는 필터, φ는 위치별 특징이다. 0은 root, 나머지는 부품이며, Δx·Δy는 root에 대한 기준 위치에서 벗어난 이동량이다. 변형 특징은 가로·세로 이동량과 각각의 제곱이다. 외형이 더 잘 맞는 이득에서 변형 비용을 뺀다. b는 여러 구성요소의 점수를 비교하기 위한 편향이다.
크게 보기: TPAMI 2010 fig04 원문 전체 패널과 캡션
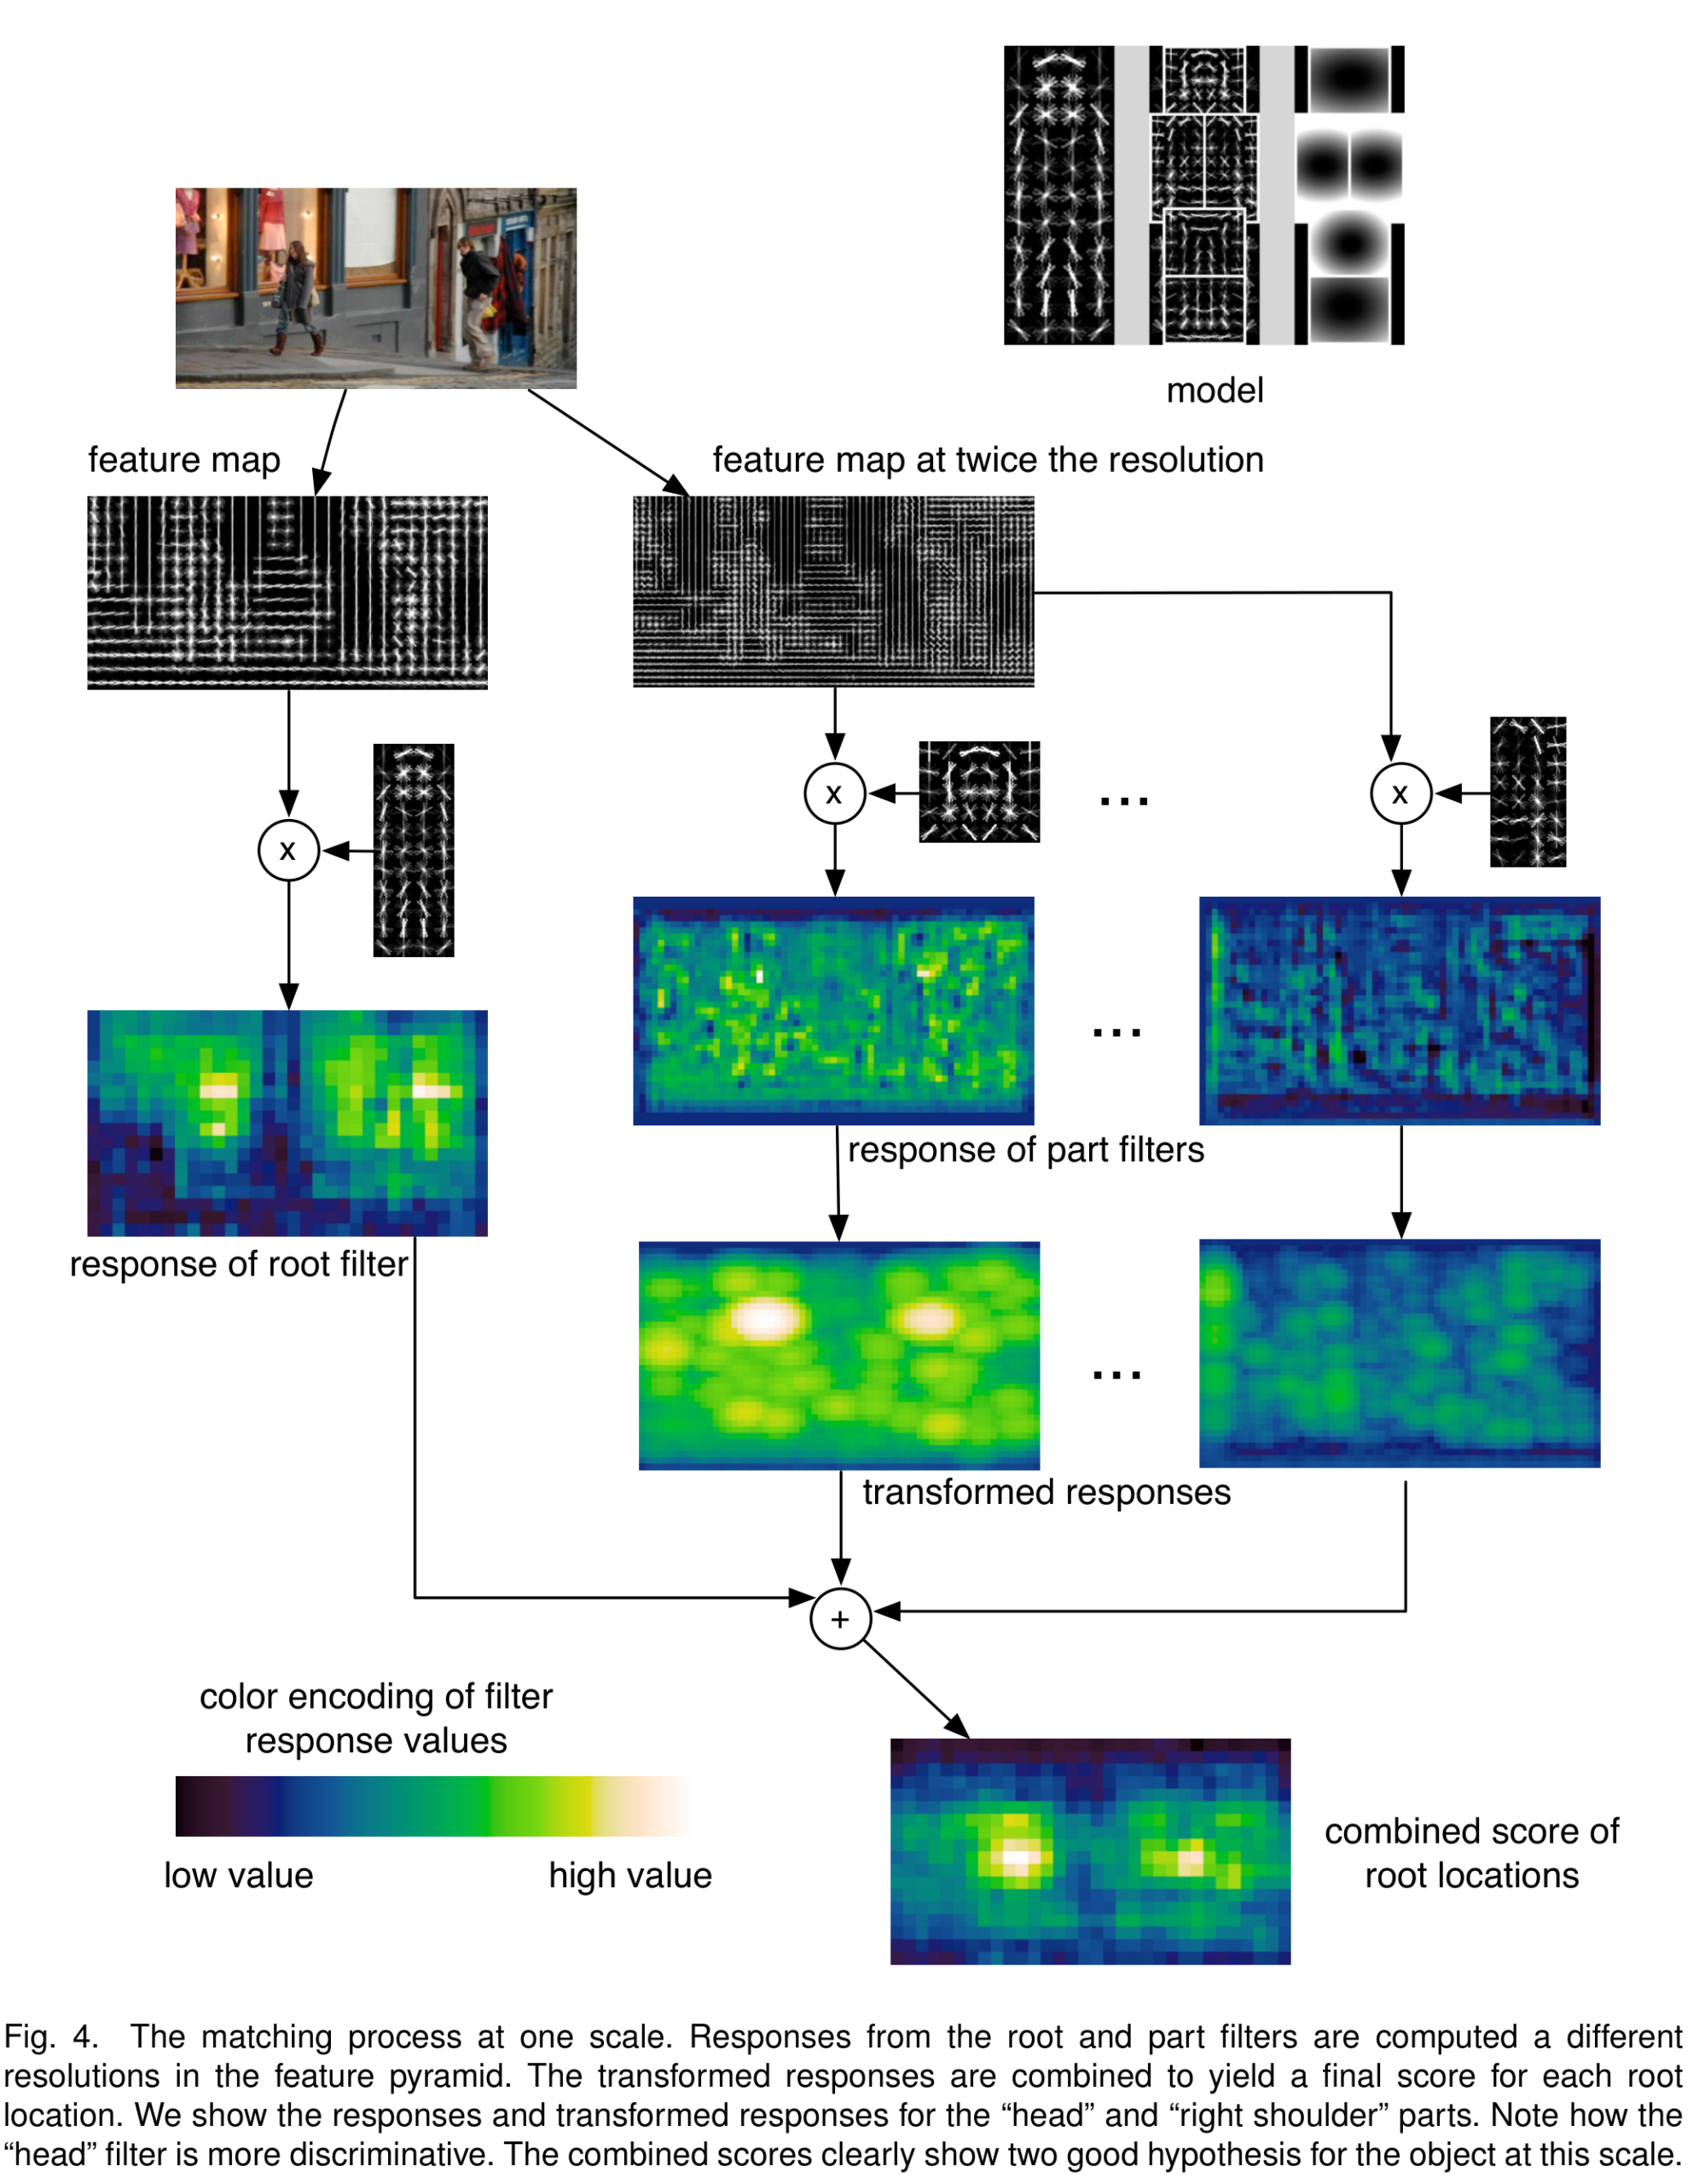
TPAMI 2010 Figure 4: root 응답과 두 배 해상도의 부품 응답을 계산하고, 부품 응답에 변형 비용을 반영한 뒤 합산하는 전체 과정. 머리와 오른쪽 어깨의 응답·변환 결과, 최종 점수와 색 범례를 모두 보여 준다. 머리 필터가 더 판별적이며 최종 점수에는 두 사람에 해당하는 좋은 후보가 나타난다. 출처: ②, p.7.
이 그림의 ‘변환’은 근처의 높은 부품 점수를 이동 비용을 고려해 기준 위치의 점수로 가져오는 과정이다. root를 고정했을 때 각 부품을 독립적으로 탐색할 수 있으므로 빠른 거리 변환을 적용할 수 있다.
4. 2010년의 추가 개선: 학습·특징·상자
학습 목적함수와 구현을 더 가깝게 만든다
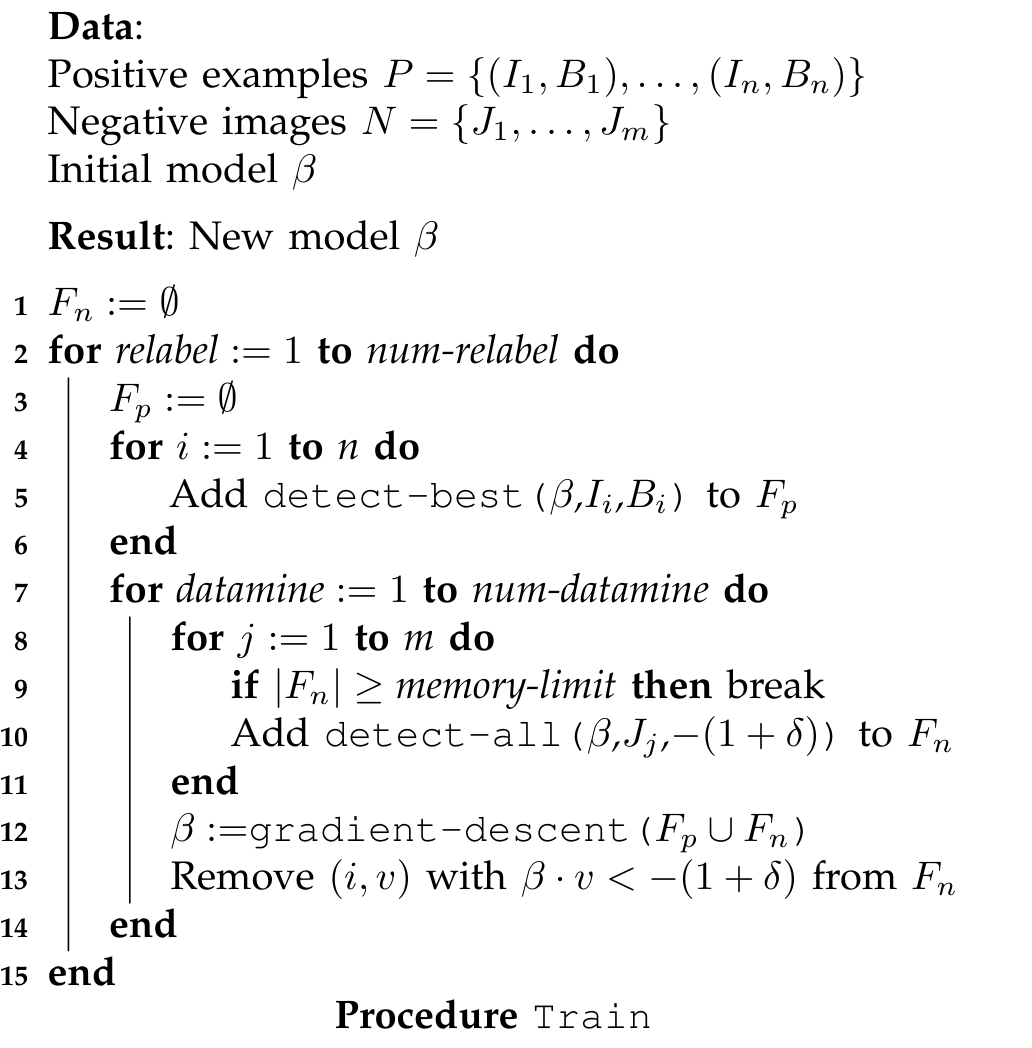
2010년은 양성 배치를 고정한 하위 문제에서 음성의 잠재 배치를 계속 고려하는 실제 latent SVM 목적함수를 확률적 경사하강법으로 최적화한다. 캐시에는 같은 음성 예제의 여러 배치에 해당하는 특징이 들어갈 수 있다. 2008년의 SVM 패키지 기반 근사를 그대로 반복하는 방식과 다르다.
크게 보기: TPAMI 2010 procedure-train 원문 전체 패널과 캡션
TPAMI 2010 Procedure Train: 번호 없는 학습 절차 도표. 바깥 반복에서 양성 배치를 다시 고르고, 안쪽 반복에서 어려운 음성을 추가·학습·정리한다. Data/Result와 1–15행 전체를 보존했다. 출처: ②, p.11.
이론적 캐시 알고리즘의 수렴은 양성 잠재변수를 고정한 볼록 하위 문제에 대한 것이다. 전체 DPM 학습의 전역 최적해 보장은 아니며, 실제 실험에서는 계산량 때문에 정해진 반복 횟수를 사용한다. 초기화가 중요한 이유다.
크게 보기: TPAMI 2010 fig05 원문 전체 패널과 캡션
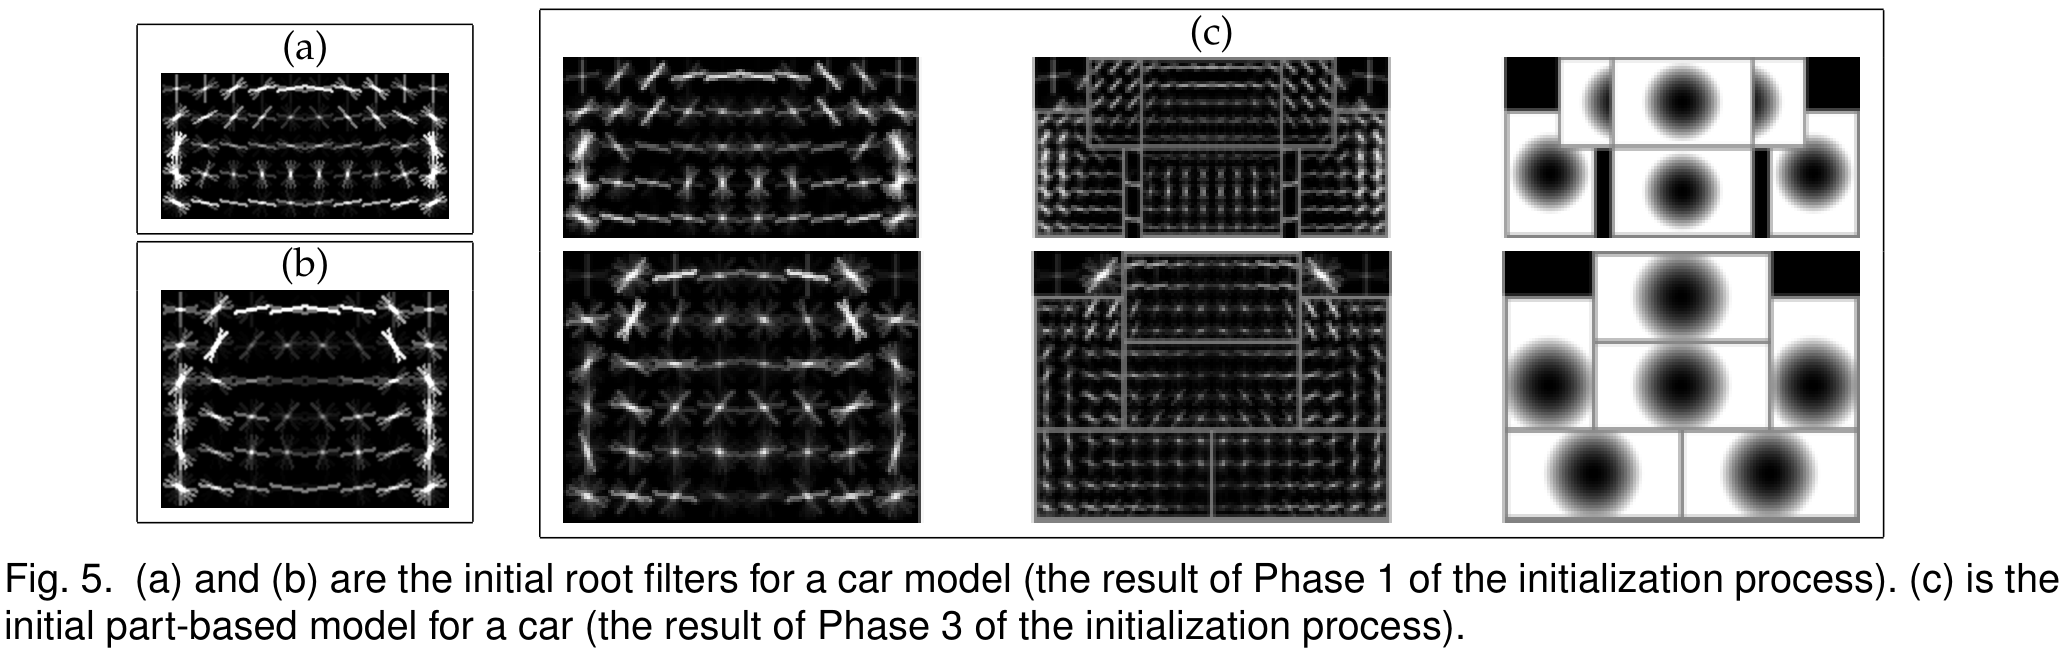
TPAMI 2010 Figure 5: (a)(b)는 종횡비로 나눈 예제에서 초기화한 자동차 root 필터, (c)는 부품까지 추가한 초기 모델이다. 이후 공동 학습으로 Figure 9의 최종 모델을 얻는다. 출처: ②, p.13.
36차원 HOG를 분석해 31차원 특징으로
크게 보기: TPAMI 2010 fig06 원문 전체 패널과 캡션
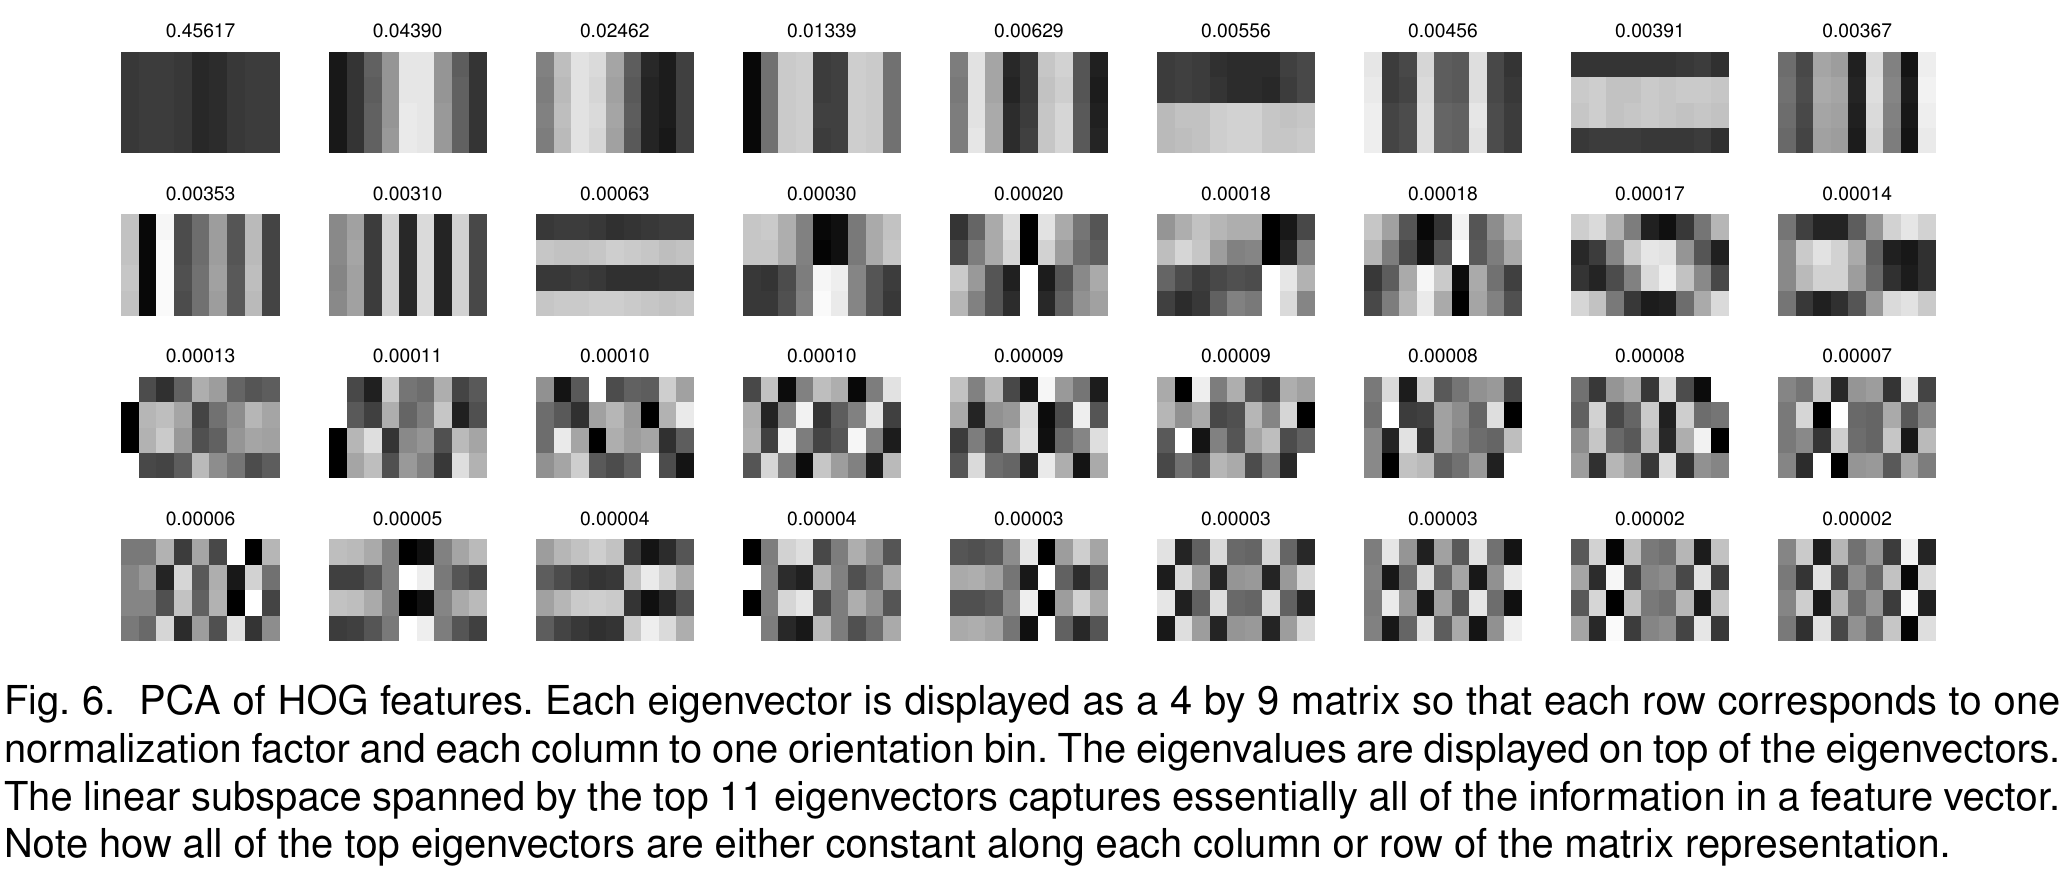
TPAMI 2010 Figure 6: HOG의 36개 주성분과 고유값 전체. 각 고유벡터는 4개 정규화×9개 방향의 행렬로 표시했다. 상위 성분이 행 또는 열 방향으로 거의 일정한 구조를 가진다는 점이 분석적 특징 축소의 단서다. 출처: ②, p.14.
저자들은 기존 36차원 HOG가 11개 주성분으로도 검출 성능을 유지함을 관찰하고, 비싼 PCA 투영 대신 방향별·정규화별 합으로 계산하는 13차원 표현을 만든다. 최종적으로는 부호에 민감한 방향 18개 + 부호에 무관한 방향 9개 + 에너지 4개 = 31차원을 사용한다. 따라서 2010년 DPM을 설명하면서 2008년에도 31차원 HOG를 썼다고 소급하면 안 된다.
검출한 부품 위치로 최종 상자를 보정한다
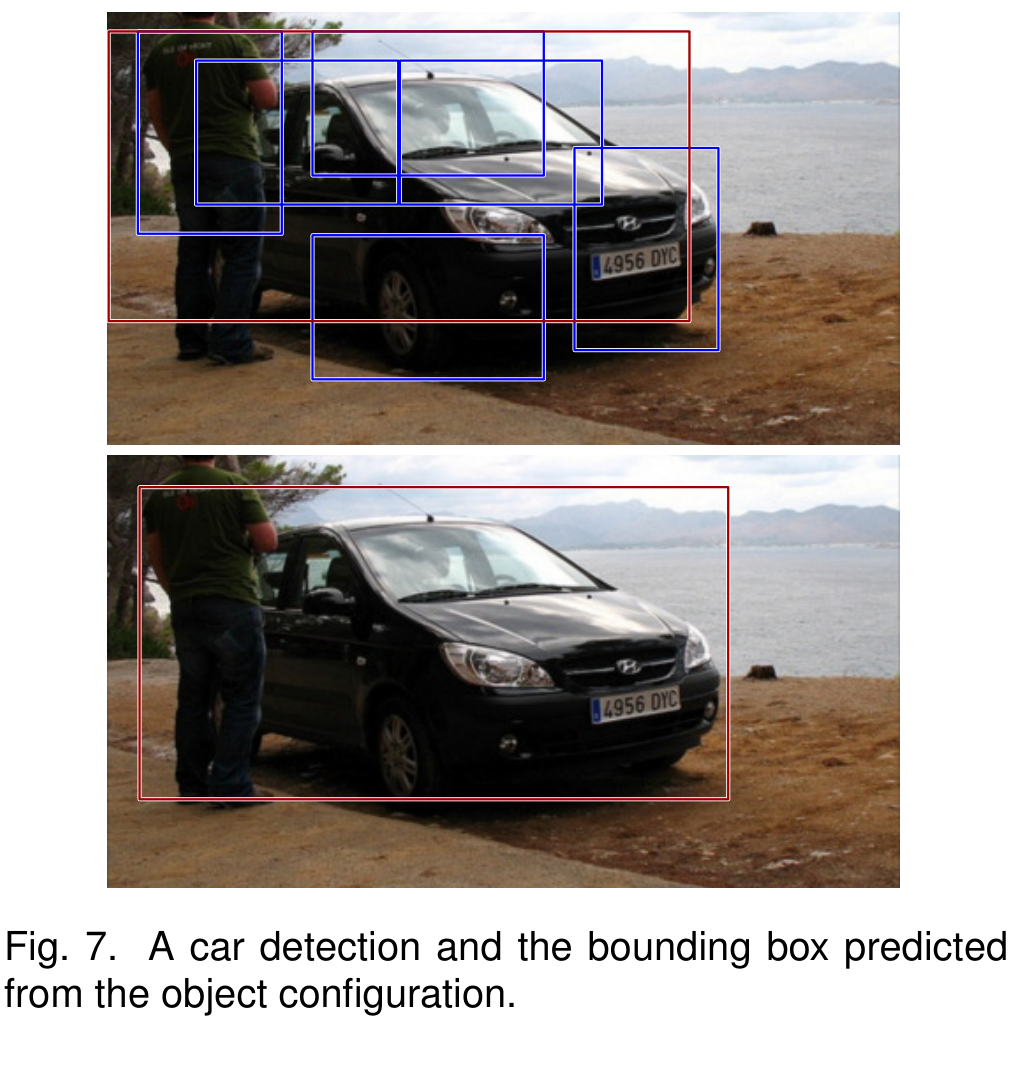
크게 보기: TPAMI 2010 fig07 원문 전체 패널과 캡션
TPAMI 2010 Figure 7: 위는 root와 부품의 검출 배치, 아래는 그 배치로 예측한 자동차의 최종 상자다. 출처: ②, p.15.
root 창은 좋은 검출 점수를 얻는 위치이지 물체 전체에 꼭 맞는 상자는 아니다. 저자들은 root·부품의 위치와 크기를 입력으로 선형 회귀를 학습해 상자의 네 좌표를 보정한다. 이후 중복 검출을 제거하고, 선택적으로 다른 클래스들의 최고 검출 점수와 현재 후보의 점수·좌표를 사용해 문맥에 맞게 재점수화한다.
5. 결과: 부품·혼합·후처리는 서로 다른 역할을 한다
두 논문은 PASCAL의 comp3 검출 평가를 사용한다. 예측 상자와 정답 상자의 IoU가 50%를 넘는지 확인하며 중복 검출은 오검출로 센다. 지표는 precision–recall 곡선의 클래스별 AP이며, 현대 COCO의 여러 IoU 임계값 평균 AP와는 다르다. 아래 원문 표는 AP를 0–1로 표시한다.
2010년 논문은 VOC 2006·2007·2008 각각의 trainval로 학습하고 test에서 평가한다. difficult 물체는 학습에서 제외하되 truncated 물체는 포함한다. 기본 실험 모델은 클래스별 두 구성요소, 구성요소당 여섯 부품이다. 이는 이 실험의 설정이지 DPM의 필수 상수는 아니다.
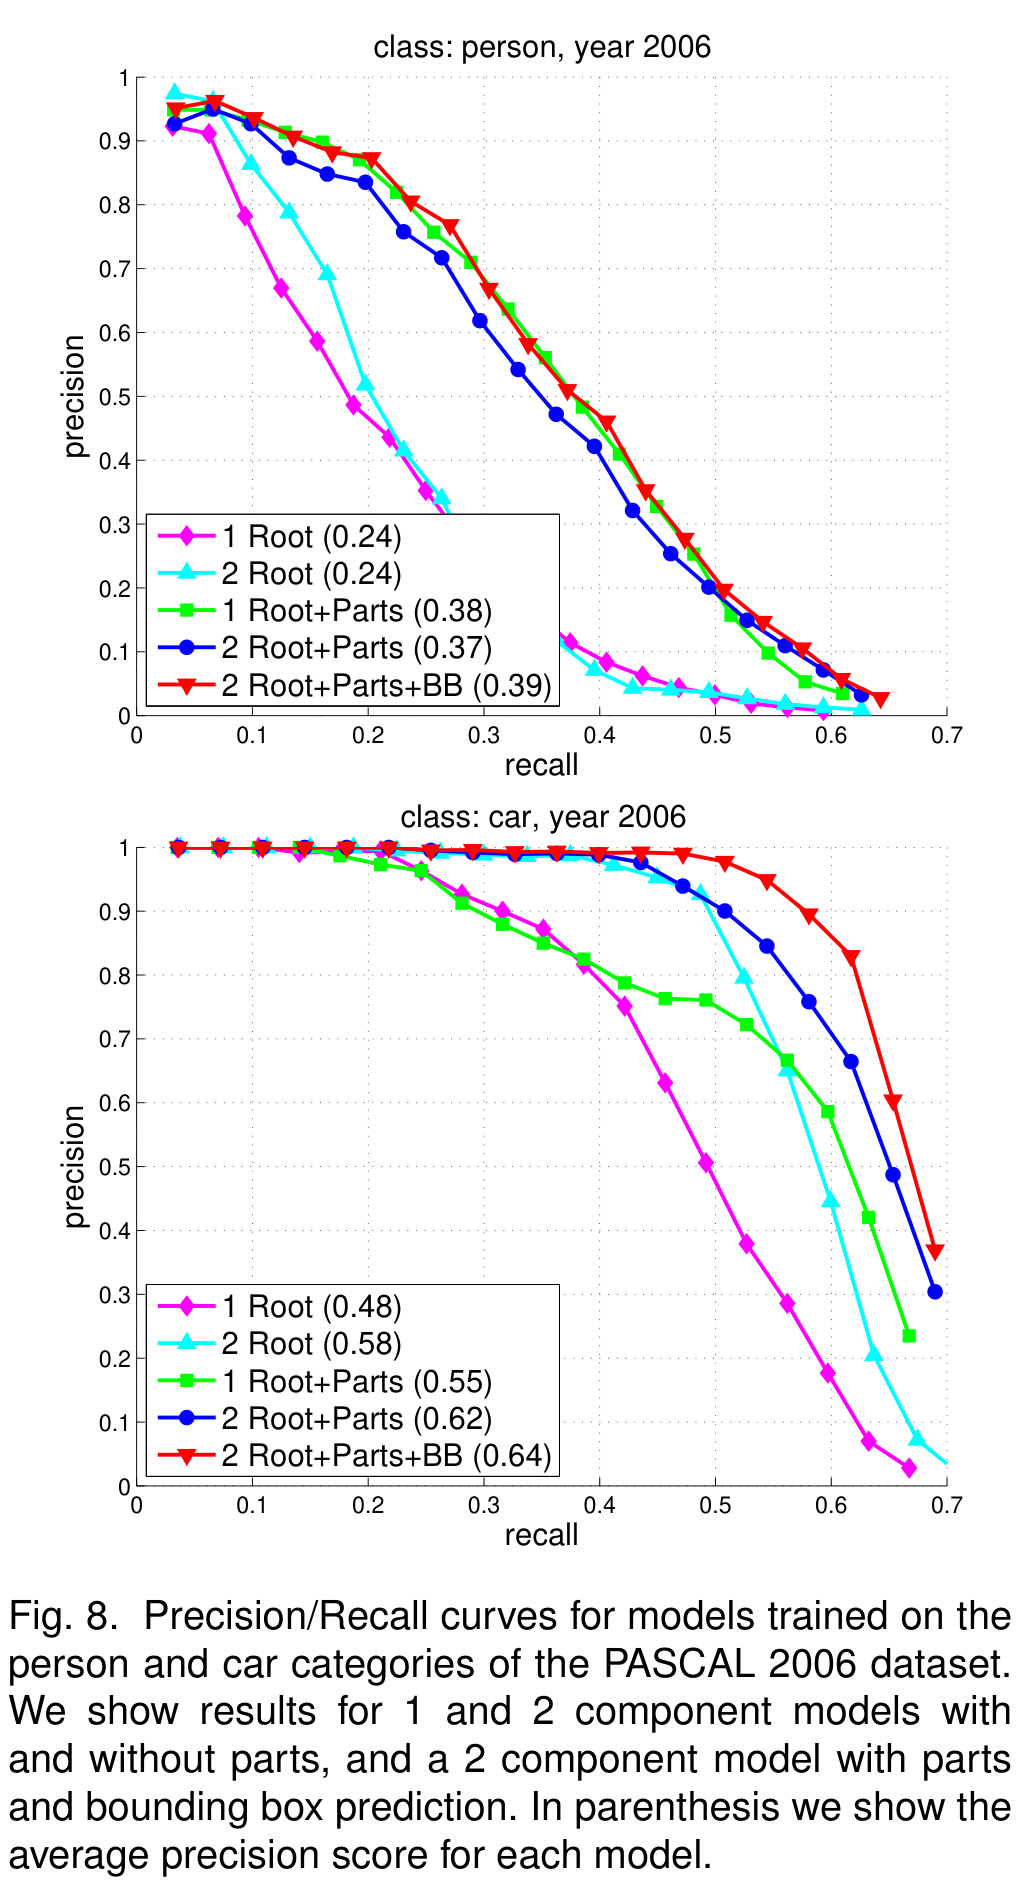
크게 보기: TPAMI 2010 fig08 원문 전체 패널과 캡션
TPAMI 2010 Figure 8: 위는 VOC 2006 사람, 아래는 자동차의 구성별 PR 곡선이다. 각 패널의 다섯 곡선·범례를 모두 포함했다. 출처: ②, p.16.
사람은 단일 root 0.24에서 부품을 추가하면 0.38로 오르지만 root 두 개만 쓰면 여전히 0.24다. 자동차는 root를 두 개로 늘리는 것만으로 0.48→0.58이 된다. 국소적인 자세 변화에는 부품이, 크게 다른 외형에는 혼합이 기여한다. 두 구성요소+부품+상자 보정의 범례 AP는 사람 0.39, 자동차 0.64다.
Figure 8의 사람 수치는 아래 Table 1의 0.363·0.380 등과 완전히 일치하지 않는다. 여기서는 그림 범례와 표 값을 각각 원문 그대로 유지하며, 차이를 임의로 반올림 탓으로 단정하지 않는다.
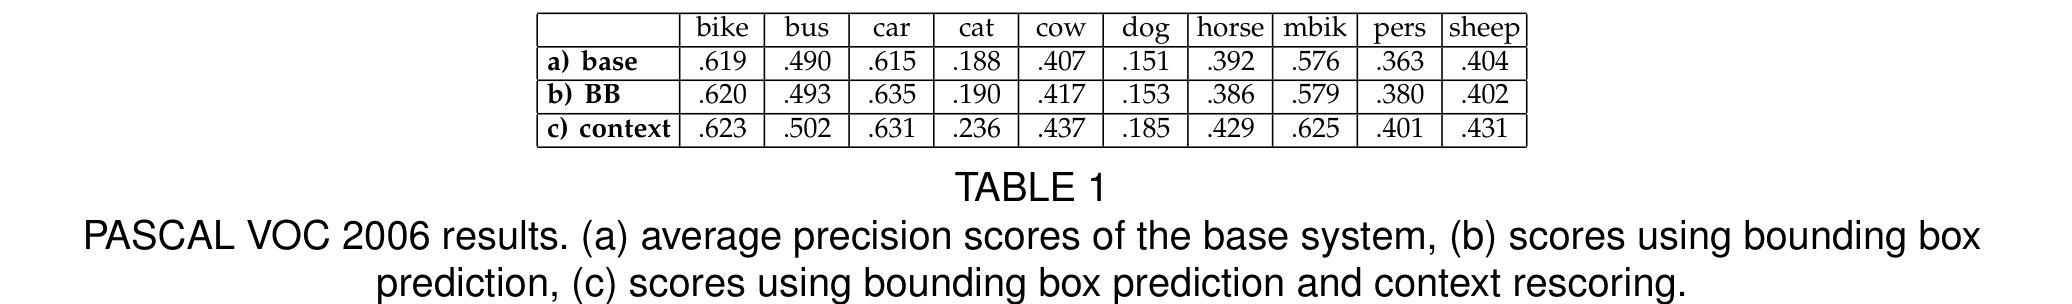
크게 보기: TPAMI 2010 table01 원문 전체 패널과 캡션
TPAMI 2010 Table 1: VOC 2006의 10개 클래스. (a)는 기본 시스템, (b)는 상자 보정 추가, (c)는 상자 보정과 문맥 재점수화 추가다. 출처: ②, p.19.
사람은 0.363→0.380→0.401, 자동차는 0.615→0.635→0.631이다. 사람은 두 후처리가 모두 도움을 주지만 자동차는 문맥을 추가하면 약간 낮아진다. 최종 시스템의 향상을 모든 클래스에서 동일한 효과로 해석할 수 없다.
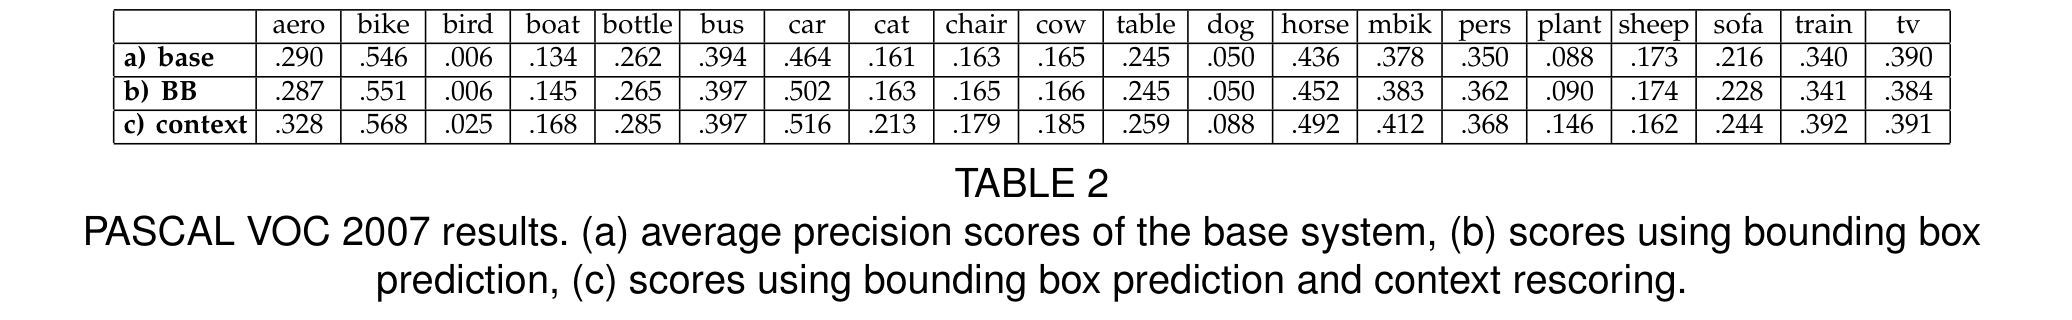
크게 보기: TPAMI 2010 table02 원문 전체 패널과 캡션
TPAMI 2010 Table 2: VOC 2007의 20개 클래스와 세 단계 결과 전체. 출처: ②, p.19.
자동차는 0.464→0.502→0.516으로 상자 보정의 효과가 크다. 반면 양은 0.173→0.174→0.162로 문맥 추가 후 낮아지고, 새는 최종 0.025로 여전히 어렵다. 2008년 Table 1과 같은 VOC 2007이지만 모델·특징·학습·후처리가 모두 달라졌으므로 차이를 혼합 모델 하나의 효과라고 할 수는 없다.
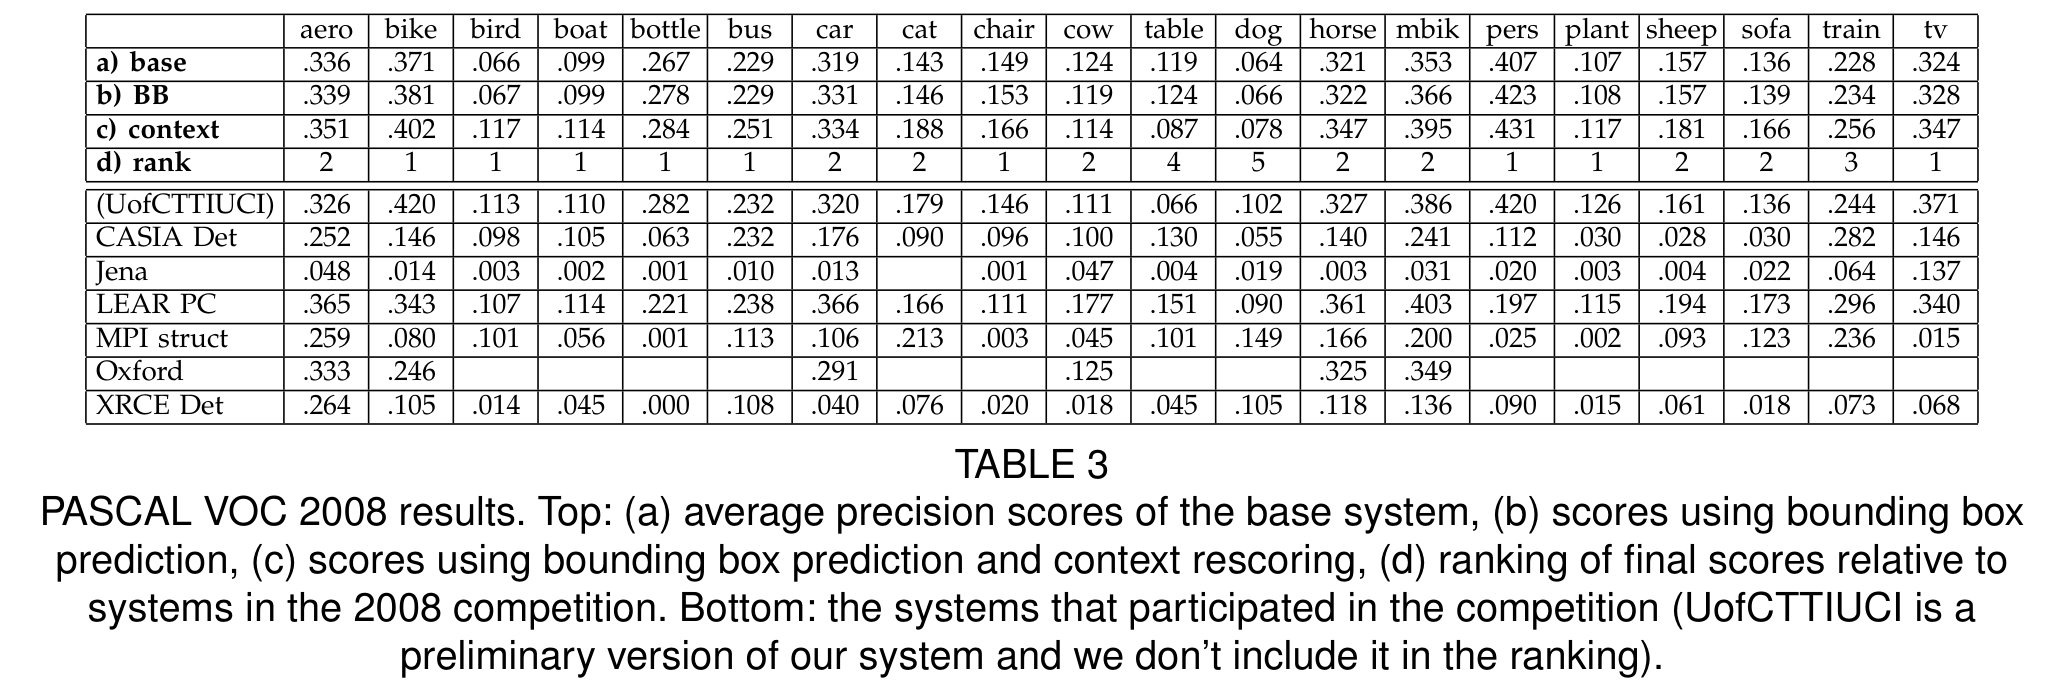
크게 보기: TPAMI 2010 table03 원문 전체 패널과 캡션
TPAMI 2010 Table 3: VOC 2008 결과와 대회 참가 시스템 비교 전체. 위쪽은 base/BB/context/순위, 아래쪽은 비교 시스템이다. 출처: ②, p.19.
최종 시스템은 20개 클래스 중 9개에서 1위, 8개에서 2위다. 이 순위는 저자들의 예비 버전 UofCTTIUCI를 제외한 비교다. 2008년 논문의 ‘VOC 2007에서 10개 1위’와는 평가 연도와 비교 집합이 다르므로 숫자만으로 후퇴했다고 볼 수 없다.
별도로 INRIA Person에서는 단일 구성요소+상자 보정으로 AP 0.869를 보고한다. 사람이 없는 이미지까지 포함한 전체 test에 PASCAL 평가 방식을 적용했다. 실행 속도는 당시 2.8GHz 8코어 Intel Xeon Mac Pro에서 모델 하나로 VOC 2007 test 4,952장을 약 3시간에 처리한 이미지당 약 2초다. 현대 GPU 속도나 20개 클래스 전체 처리 속도를 뜻하지 않는다.
6. 원문 모델과 실패 사례에서 읽을 한계
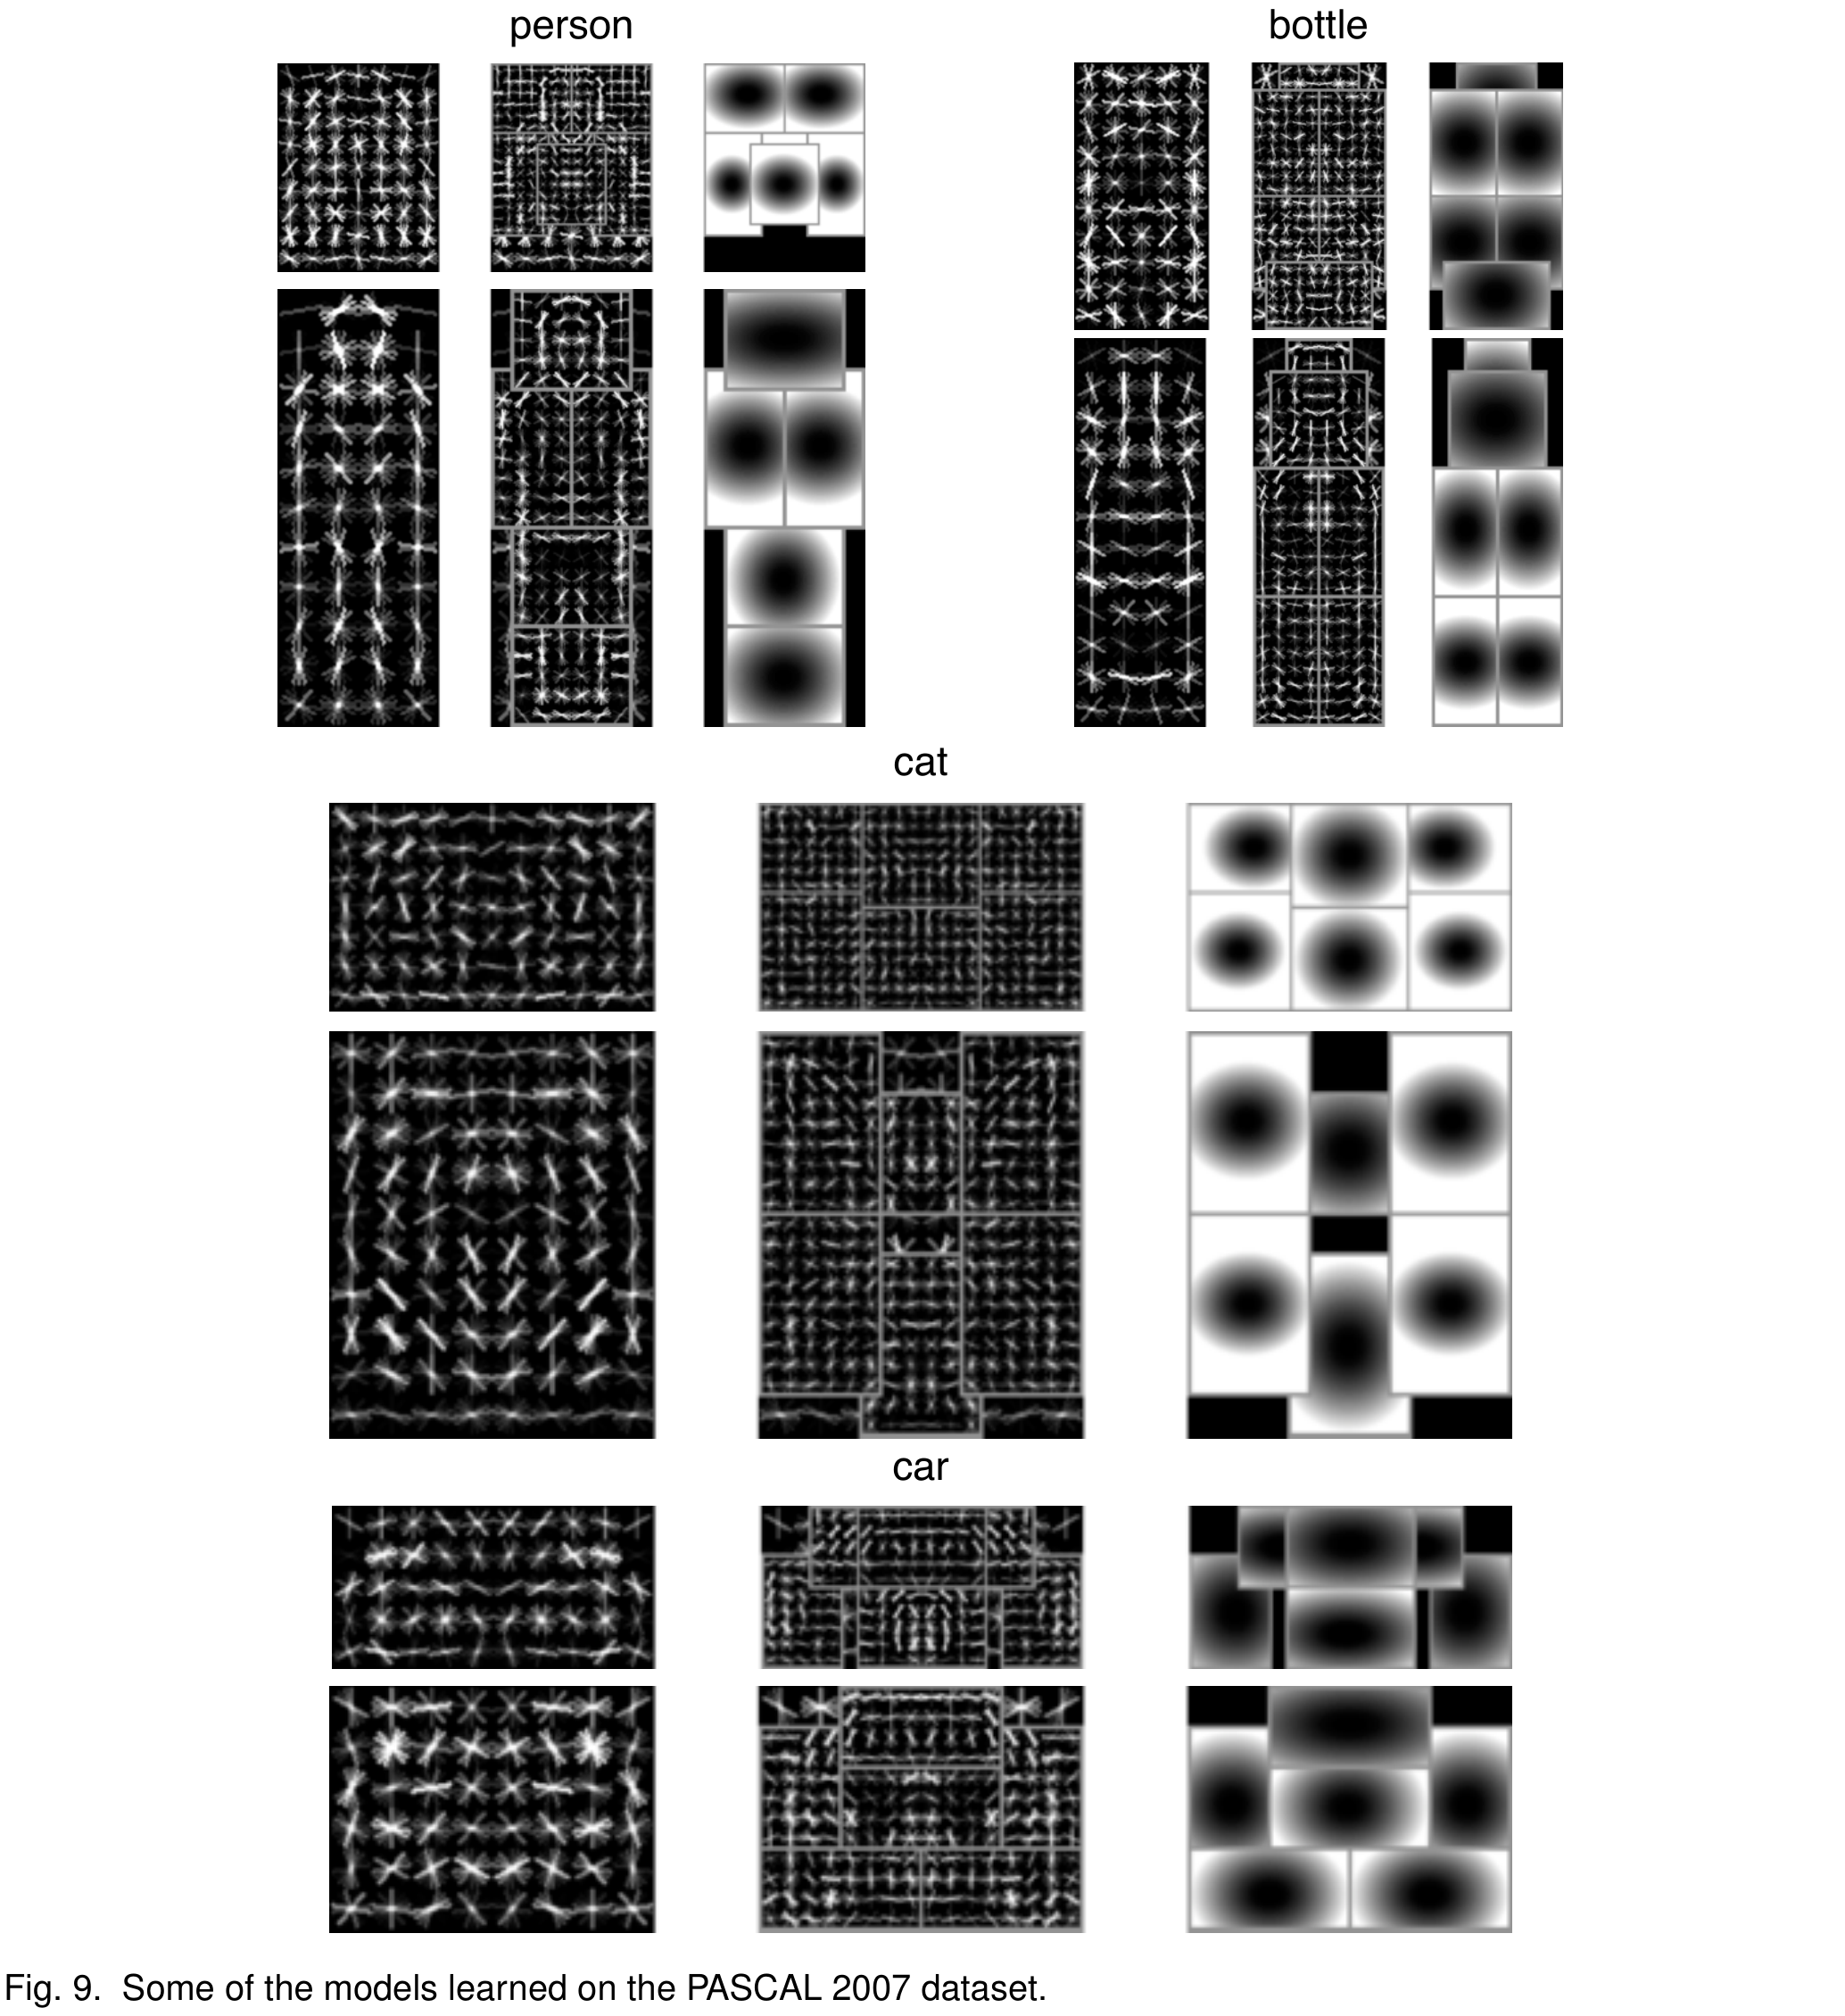
크게 보기: TPAMI 2010 fig09 원문 전체 패널과 캡션
TPAMI 2010 Figure 9: VOC 2007에서 학습한 사람·병·고양이·자동차 모델. 각 클래스의 두 구성요소와 root·부품·공간 모델을 모두 담았다. 고양이에서는 얼굴을 강하게 설명하는 구성요소가 나타난다. 출처: ②, p.17.
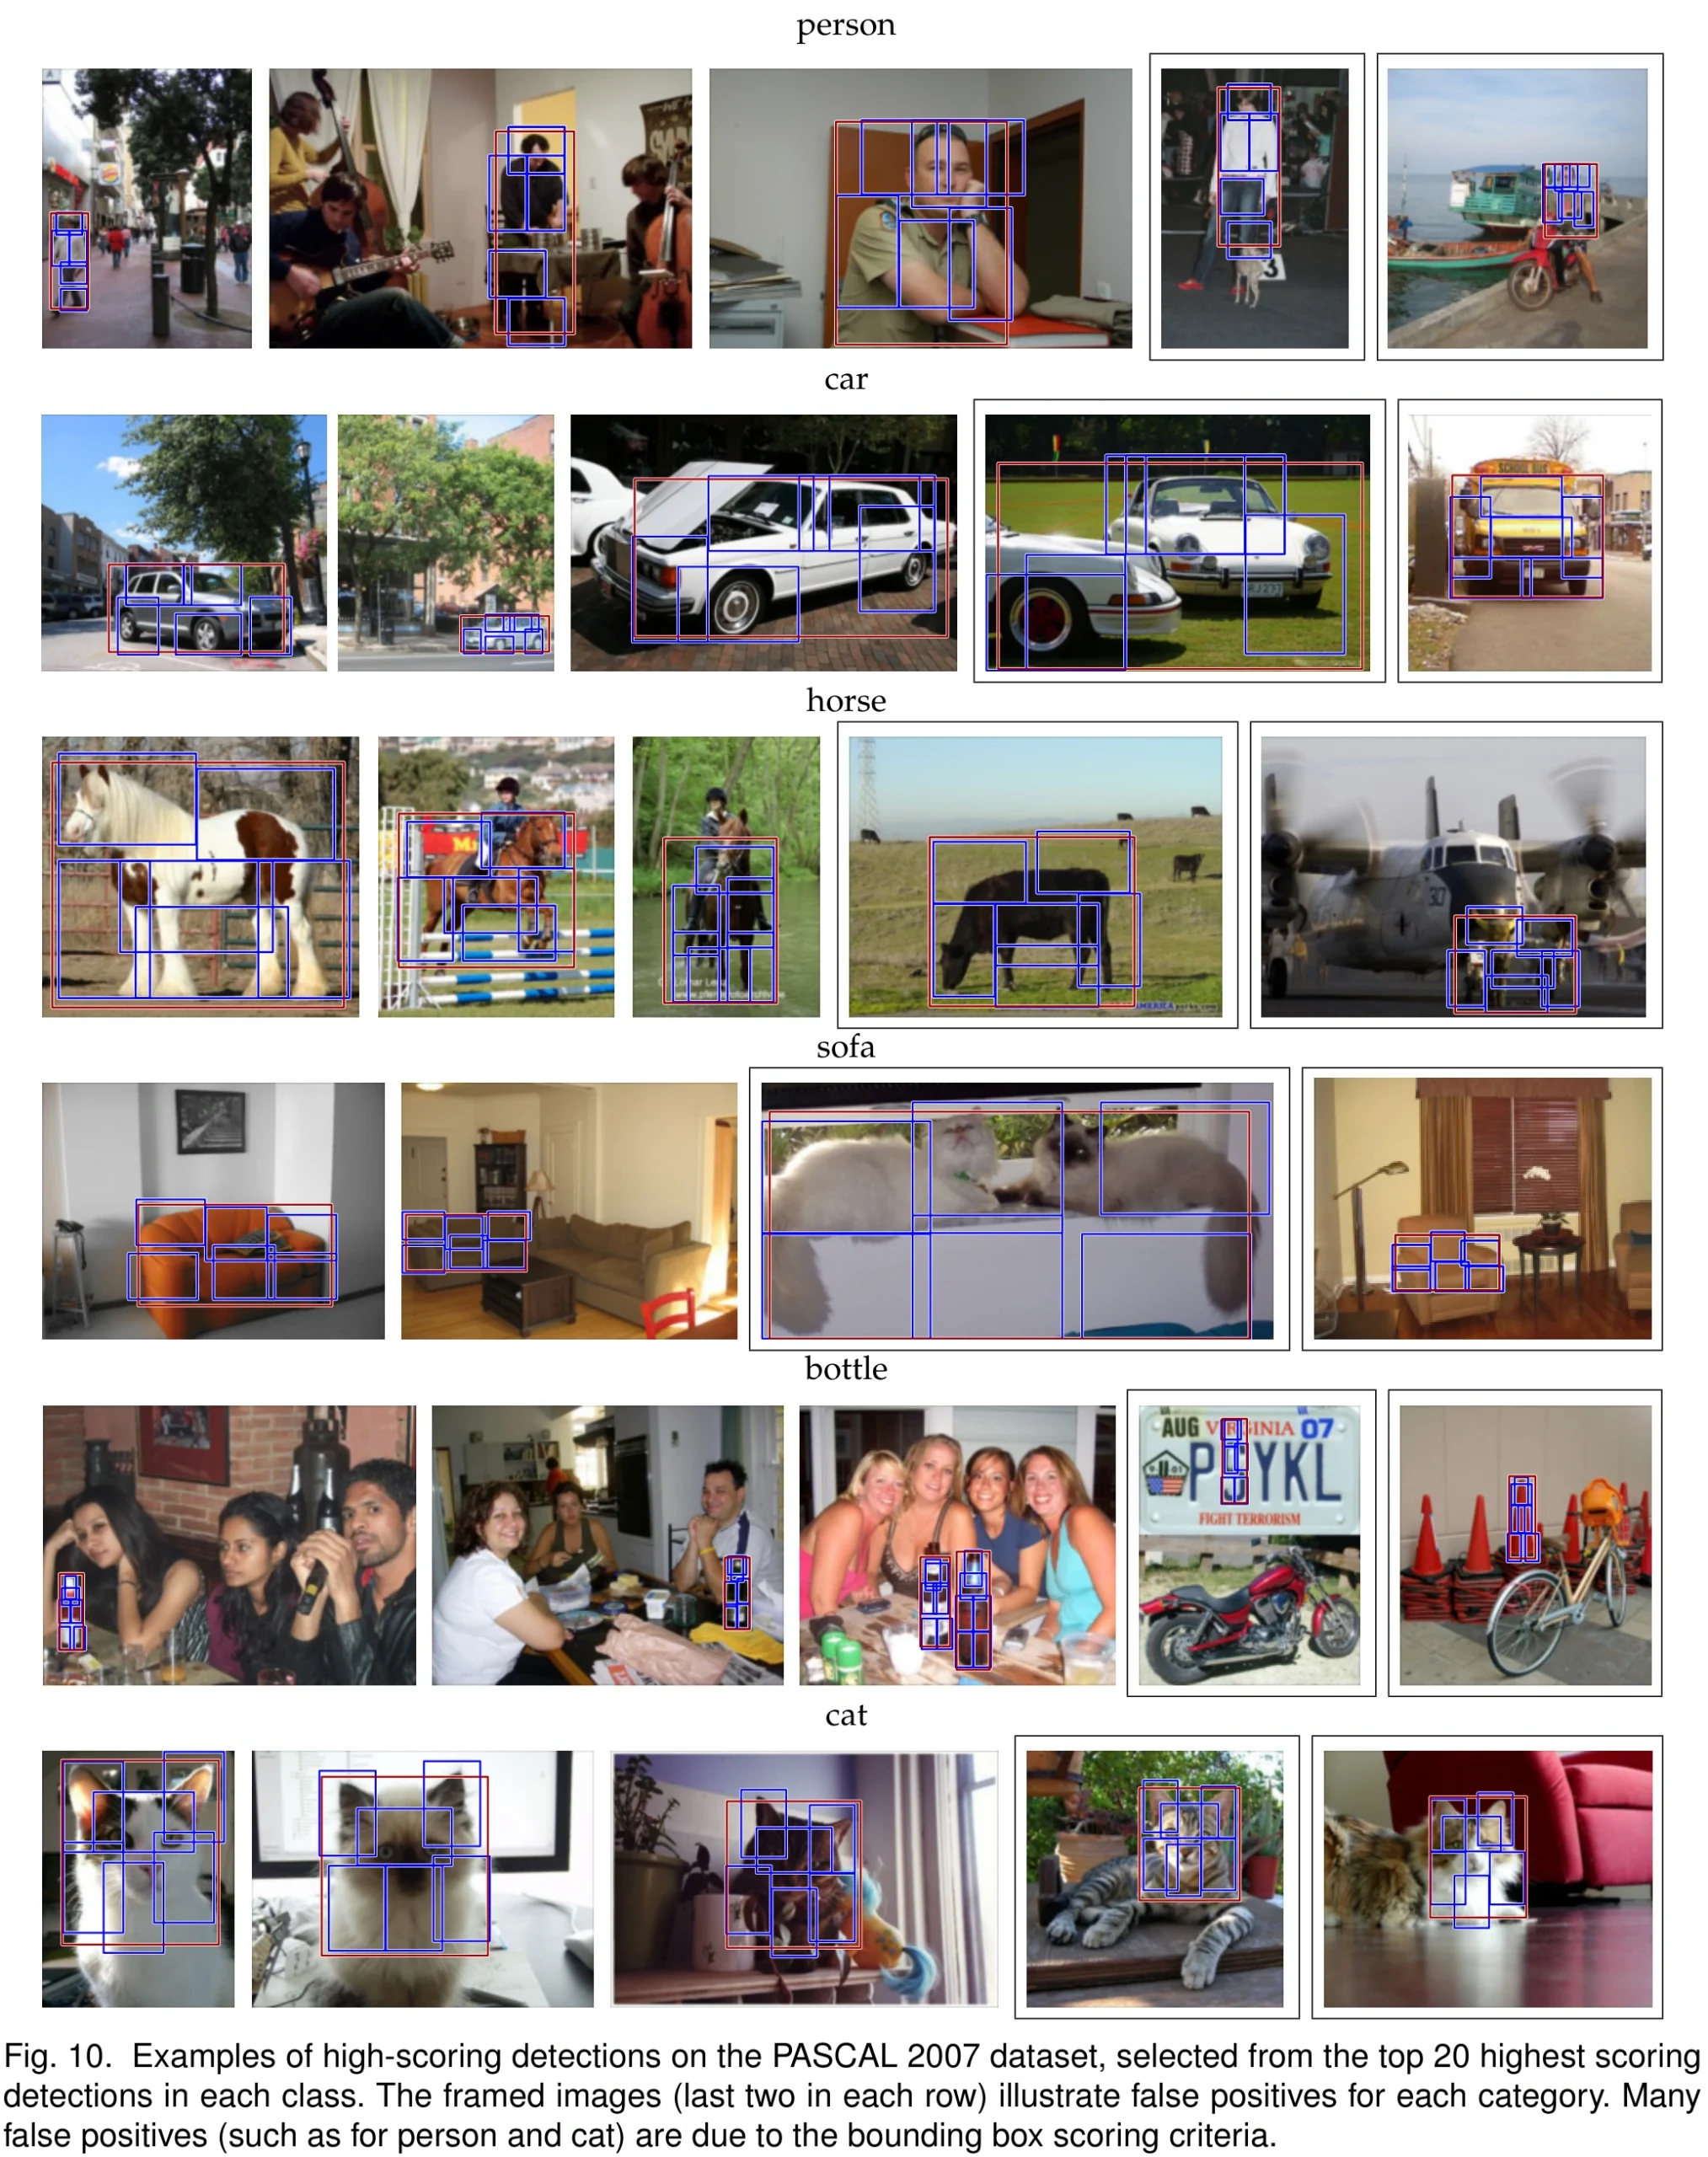
크게 보기: TPAMI 2010 fig10 원문 전체 패널과 캡션
TPAMI 2010 Figure 10: 위에서부터 사람·자동차·말·소파·병·고양이의 검출 결과. 각 클래스의 점수 상위 20개 검출 중 고른 사례이며, 각 행의 마지막 두 테두리 사진은 오검출이다. 사진과 오검출 표시를 모두 보존했다. 출처: ②, p.18.
이 그림의 실패는 단순히 ‘물체를 전혀 못 봤다’와 다르다. 고양이 얼굴은 찾았지만 몸통을 포함하지 않아 평가상 오검출이 되기도 한다. 저자들은 고양이의 점수 높은 오검출 상위 20개가 모두 얼굴이라고 분석한다. 얼굴만 보이는 학습 사례가 많아 그런 구성요소가 만들어졌기 때문이다. 잘 맞는 부분을 찾는 것과 물체 전체의 상자를 맞히는 것은 다른 문제다.
별 구조는 계산을 쉽게 하지만 부품 사이의 직접적인 상호작용을 표현하지 못한다. 잠재변수를 이용한 학습은 초기화와 국소해 문제도 남긴다. 저자들이 제시한 후속 방향은 부품 안의 부품, 부품 공유, 가변 계층을 갖는 문법 기반 모델이다.
7. 두 논문의 차이를 한눈에
| 관점 | CVPR 2008 | TPAMI 2010 |
|---|---|---|
| 표현 | 다중 해상도의 단일 root·부품 모델 | 여러 부품 모델의 혼합으로 큰 외형 변화도 분리 |
| 학습 | latent SVM 제안, SVMlight 기반 근사 구현 | 양성 배치 고정 하위 문제에서 실제 latent 목적함수·음성 특징 캐시 최적화 |
| 특징 | 36차원 HOG | 분석적 차원 축소와 방향 정보를 결합한 31차원 특징 |
| 최종 검출 | root 창 중심의 결과 | 부품 배치 기반 상자 회귀와 문맥 재점수화 추가 |
| 실험 | VOC 2006·2007 | VOC 2006·2007·2008 및 INRIA Person |
2008년의 핵심은 변형 가능한 부품을 판별 학습과 결합해 성능으로 연결한 것이다. 2010년은 그 원리를 혼합 모델·더 충실한 최적화·특징·후처리로 확장했다. 두 논문을 함께 읽으면 좋은 검출기는 구조 하나의 발명만으로 완성되지 않고, 표현·탐색·학습·평가 목표를 함께 맞추는 과정에서 만들어진다는 점이 선명해진다.
참고 자료
- CVPR 2008 논문
- TPAMI 2010 논문 원문 · 정식 출판 정보
- 저자 프로젝트와 공개 구현: 현재 안내되는 후속 Release 5의 성능을 이 글의 논문 수치와 섞지 않았다. 이 글은 저자 보고를 정리한 것이며 모델을 실행해 재현한 결과가 아니다.
답글 남기기