논문: A Critical Review of Recurrent Neural Networks for Sequence Learning
저자: Zachary C. Lipton, John Berkowitz, Charles Elkan
발표: 2015년 arXiv 서베이, v4 기준
1. 왜 순서를 기억하는 신경망이 필요한가
문장 속 단어와 영상 속 프레임은 앞뒤 맥락에 따라 의미가 달라진다. 각 입력을 따로 처리하거나 정해진 길이의 주변 정보만 붙이는 방식으로는 멀리 떨어진 단서까지 활용하기 어렵다. 순환 신경망(Recurrent Neural Network, RNN)은 앞서 읽은 정보를 내부 상태에 남기고 다음 입력과 함께 처리한다. 덕분에 길이가 달라지는 입력과 출력을 하나의 계산 방식으로 다룰 수 있다.
하지만 과거 정보가 전달될 경로를 만드는 것과, 그 정보를 실제로 활용하도록 학습하는 것은 다르다. 이 서베이는 그 간극을 중심으로 기본 RNN의 학습 문제, LSTM의 기억 장치, 양방향 RNN의 문맥 활용, 번역·이미지 설명 생성으로 이어지는 발전을 정리한다. 새로운 모델의 실험 보고서가 아니라 2015년까지의 연구를 원리와 적용 사례로 연결한 리뷰다.
- RNN: 같은 계산을 반복하면서 상태를 넘겨, 입력을 고정 길이 창으로 잘라야 하는 제약을 줄인다.
- LSTM: 무엇을 기억하고 지울지 학습하는 게이트와 별도의 기억 경로로 장기 의존성 학습을 돕는다.
- 양방향 RNN: 이미 주어진 시퀀스를 두 방향으로 읽어 앞뒤 문맥을 함께 활용한다. LSTM과도 결합할 수 있다.
- 적용과 평가: 번역과 캡셔닝의 성과는 중요하지만, 자동 평가 점수가 문장 품질 자체를 보장하지는 않는다.
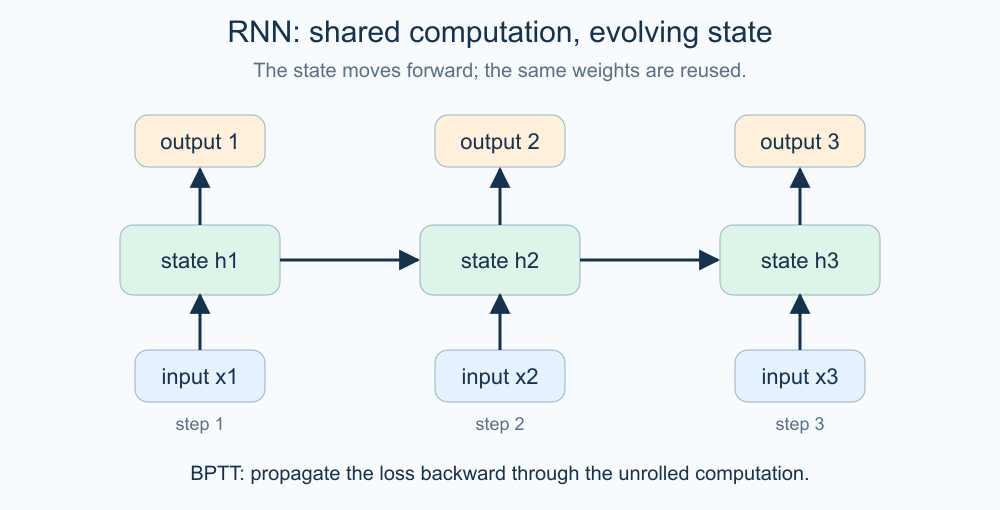
그림 1. 시간을 따라 펼친 RNN. 서로 다른 네트워크 세 개가 아니라 같은 가중치를 사용하는 계산의 세 시점이다. 원문 §3·Figure 4의 개념을 바탕으로 직접 제작한 설명 그림.
2. RNN: 과거를 상태에 압축해 넘긴다
기본 RNN은 현재 입력과 직전의 은닉 상태(hidden state)를 합쳐 새 상태를 만든다. 은닉 상태는 지금까지 본 정보를 담는 학습된 요약이며, 원래 입력 전체를 그대로 저장하는 기록장은 아니다. 원문 §3의 다중 클래스 출력 예시는 다음과 같다.
\begin{aligned}
\mathbf h^{(t)} &= \sigma\!\left(W^{hx}\mathbf x^{(t)} + W^{hh}\mathbf h^{(t-1)} + \mathbf b_h\right) \\
\hat{\mathbf y}^{(t)} &= \operatorname{softmax}\!\left(W^{yh}\mathbf h^{(t)} + \mathbf b_y\right).
\end{aligned}
입력 와 이전 상태 가 새 상태 를 결정한다. 여기서 는 시그모이드 함수이며, 세 가중치 행렬은 각각 입력→상태, 이전 상태→현재 상태, 상태→출력의 변환을 맡는다. 모든 시점에서 같은 가중치를 재사용하므로 시퀀스가 길어져도 시점마다 새로운 파라미터를 만들 필요가 없다. 출력 함수는 과제에 따라 바뀌며, softmax는 단어·클래스의 확률을 만들 때 쓰는 선택이다.
이전 상태만 참조한다는 점에서는 마르코프 모델과 닮았다. 차이는 과거 정보를 담는 방식이다. 전통적인 이산 상태 HMM은 가능한 상태와 전이를 명시적으로 다루는 반면, RNN은 연속값 벡터에 정보를 분산해서 표현한다. 다만 이를 “RNN은 임의로 긴 과거를 정확히 기억한다”로 읽으면 안 된다. 표현할 수 있는 가능성과 학습으로 얻는 기억 능력은 별개다.
초기 구조의 차이도 이 관점에서 이해할 수 있다. Jordan 계열은 이전 출력을 문맥 정보로 되돌려 행동의 이력을 반영하고, Elman 계열은 은닉 상태를 되돌려 출력에 드러나지 않은 정보도 다음 계산에 활용한다. 이 글에서는 개별 구조의 계보보다, 상태를 반복해서 전달할 때 생기는 학습 문제에 집중한다.
3. BPTT: 기억할 수 있어도 배우기 어려운 이유
순환 연결을 시간축으로 펼치면 RNN은 가중치를 공유하는 깊은 계산 그래프가 된다. 시간 역전파(Backpropagation Through Time, BPTT)는 이 그래프에서 뒤쪽의 오차를 앞선 시점까지 전달해 가중치를 조정한다. 같은 가중치가 여러 시점에 쓰였으므로 각 시점에서 생긴 기울기 기여를 모아 업데이트한다.
문제는 거리가 길수록 미분값이 반복해서 곱해진다는 것이다. 원문 §3.2의 단일 은닉 노드 설명을 스칼라 형태로 재정리하면 다음과 같다.
\frac{\partial h^{(t)}}{\partial h^{(\tau)}}
= \prod_{k=\tau+1}^{t} w\,\phi'(a^{(k)}).
여기서 는 순환 가중치, 는 활성화 전 값, 는 활성화 함수다. 작은 크기의 인자가 반복되면 기울기 소실이 생겨 먼 과거에 대한 학습 신호가 약해지고, 큰 인자가 반복되면 기울기 폭발이 생겨 업데이트가 불안정해질 수 있다. 실제 벡터 상태에서는 행렬 미분의 곱이므로, 가중치 하나가 1보다 큰지 작은지만으로 모든 경우를 판정할 수는 없다.
원문은 역전파 길이를 제한하는 TBPTT도 설명한다. 계산 부담과 긴 역전파 경로를 줄일 수 있지만, 잘라낸 구간을 가로질러 오차를 전달하지 못한다. 상태를 계속 넘기는 것과 그 전체 과거에 걸쳐 학습 신호를 보내는 것은 다른 문제다. LSTM은 여기서 한발 더 나아가, 기억을 전달하는 계산 경로 자체를 바꾼다.
4. LSTM: 기억과 출력을 분리한다
기본 RNN에서는 과거 상태가 매번 가중치 변환과 비선형 함수를 통과한다. 장단기 기억(Long Short-Term Memory, LSTM)은 별도의 셀 상태를 두고, 기존 기억을 유지하는 경로와 새 내용을 쓰는 경로를 나눈다. 핵심은 단순히 은닉층을 크게 만드는 것이 아니라 정보를 언제 저장하고, 지우고, 드러낼지 학습하는 것이다.
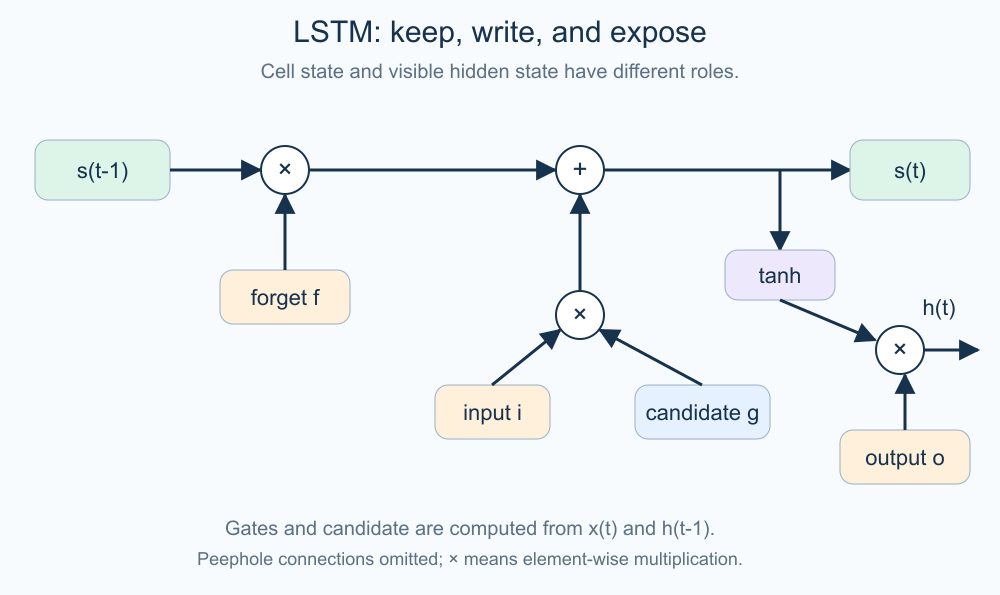
그림 2. 망각 게이트를 포함한 LSTM의 기억 흐름. 위쪽은 셀 상태를 유지·갱신하는 경로이고, 오른쪽 분기는 외부로 내보낼 은닉 상태를 만든다. 원문 §4.1·Figures 9–11에 근거해 직접 제작했으며 peephole 연결은 생략했다.
각 시점에서 현재 입력과 이전 은닉 상태를 받아 다음 요소를 계산한다.
- 후보값 g: 새로 기록할 내용이다. 게이트가 아니라 정보 자체이며, 원문이 정리한 현대적 구성에서는 tanh를 사용한다.
- 입력 게이트 i: 후보값 중 얼마를 기억에 쓸지 정한다.
- 망각 게이트 f: 이전 셀 상태 중 얼마를 남길지 정한다.
- 출력 게이트 o: 갱신한 기억 중 얼마를 현재 은닉 상태로 내보낼지 정한다.
게이트는 시그모이드로 0과 1 사이의 값을 만들며, 그 값으로 정보의 통과량을 조절한다. 원문 표기를 사용하면 후보값과 게이트는 다음처럼 묶어 쓸 수 있다.
\begin{aligned}
\mathbf g^{(t)} &= \tanh\!\left(W^{gx}\mathbf x^{(t)}+W^{gh}\mathbf h^{(t-1)}+\mathbf b_g\right), \\
\mathbf q^{(t)} &= \sigma\!\left(W^{qx}\mathbf x^{(t)}+W^{qh}\mathbf h^{(t-1)}+\mathbf b_q\right),\quad q\in\{i,f,o\}.
\end{aligned}
두 번째 줄은 세 게이트의 형태를 압축한 표기이며, 실제로는 게이트마다 서로 다른 가중치를 갖는다. 셀 상태 와 외부로 보이는 은닉 상태 는 다음과 같이 갱신한다.
\begin{aligned}
\mathbf s^{(t)} &= \mathbf f^{(t)}\odot\mathbf s^{(t-1)} + \mathbf i^{(t)}\odot\mathbf g^{(t)}, \\
\mathbf h^{(t)} &= \mathbf o^{(t)}\odot\tanh\!\left(\mathbf s^{(t)}\right).
\end{aligned}는 원소별 곱이다. 첫 번째 항은 이전 기억의 보존, 두 번째 항은 새로운 정보의 기록을 맡는다. 망각 게이트가 1에 가깝고 입력 게이트가 0에 가까우면 셀 상태는 거의 그대로 유지된다. 출력 게이트를 닫으면 그 기억을 보관하면서도 당장 외부 출력에 노출하지 않을 수 있다.
이 가산적 기억 경로가 LSTM의 핵심이다. 원래의 고정 단위 가중치 자기 연결은 constant error carousel이라 불리며, 기울기가 시간축을 따라 유지될 수 있는 경로를 제공한다. 다만 망각 게이트가 있는 구조에서 직접 기억 경로의 미분은 게이트 값의 영향을 받는다. 전체 네트워크의 기울기 소실·폭발을 무조건 없앤다는 뜻은 아니다. 실제로 아래에서 소개할 seq2seq 원 논문도 LSTM 학습에 기울기 크기 제한을 사용했다.
역사적으로도 구분이 필요하다. 1997년의 원래 LSTM에는 망각 게이트가 없었고, 2000년에 추가되었다. Peephole 연결은 셀 내부 상태를 게이트에 직접 보여 주어 시간 간격이나 계수 정보를 판단하도록 돕는 별도 변형이다. 위 수식은 망각 게이트는 포함하지만 peephole은 포함하지 않는다.
5. 양방향 RNN과 NTM: 기억을 개선하는 서로 다른 축
5.1 양방향 RNN: 뒤에 나오는 정보도 읽는다
문장 전체가 주어진 품사 태깅에서는 앞 단어뿐 아니라 뒤 단어도 현재 단어를 판단하는 단서가 된다. 양방향 RNN(Bidirectional RNN, BRNN)은 순방향과 역방향의 두 은닉 상태열을 별도로 계산하고, 같은 위치의 두 상태를 함께 이용해 출력을 만든다.
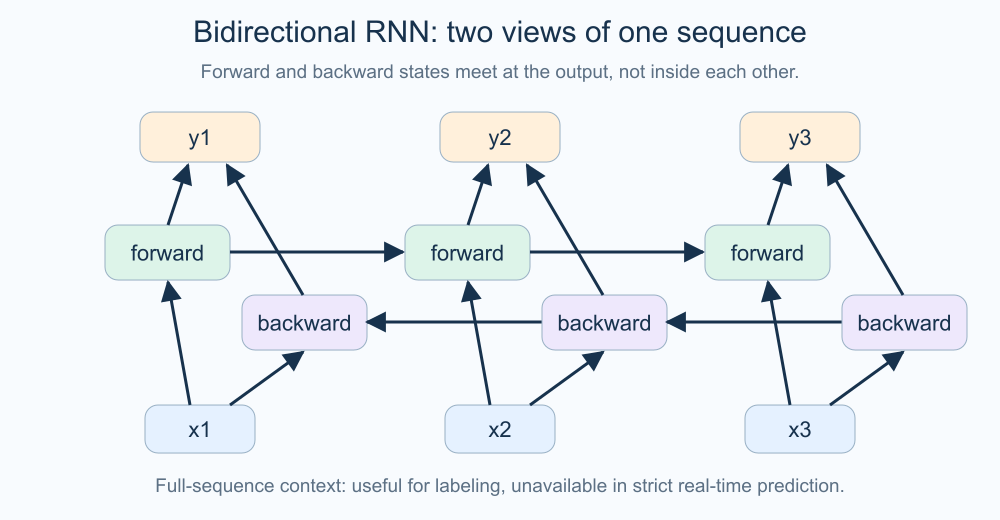
그림 3. 서로 반대 방향으로 흐르는 두 상태열. 미래의 정답을 보는 것이 아니라, 이미 확보한 입력 시퀀스의 뒷부분을 읽는다. 원문 §4.2·Figure 12에 근거해 직접 제작한 설명 그림.
LSTM이 “하나의 기억 장치를 어떻게 만들 것인가”에 대한 답이라면, BRNN은 “문맥을 어느 방향에서 모을 것인가”에 대한 답이다. 따라서 둘은 경쟁 관계가 아니며, 양방향의 각 계산에 LSTM을 쓰면 BiLSTM이 된다.
적용 조건은 명확하다. 앞으로 들어올 입력을 모르는 엄격한 실시간 예측에는 전체 미래 문맥을 요구하는 BRNN을 그대로 쓸 수 없다. 반면 문장·음성 구간처럼 끝이 정해진 입력을 모아서 처리할 때는 양쪽 문맥이 유용하다.
5.2 Neural Turing Machine: 기억을 외부로 확장한다
신경 튜링 머신(Neural Turing Machine, NTM)은 신경망 제어기에 주소를 지정할 수 있는 외부 메모리와 읽기·쓰기 장치를 붙인다. 하나의 상태 벡터에 모든 정보를 압축하기보다, 필요한 내용을 저장하고 다시 찾아오는 작업을 학습한다. 미분 가능한 읽기·쓰기 덕분에 전체 시스템을 역전파로 학습할 수 있다는 점이 중요하다.
서베이는 복사와 우선순위 정렬 등의 알고리즘 과제에서 NTM이 일반 LSTM보다 학습에 없던 긴 입력으로 더 잘 일반화한 연구를 소개한다. 이는 외부 메모리의 가능성을 보여 주는 제한된 과제의 결과이지, 임의의 프로그램을 안정적으로 실행하거나 모든 언어 과제에서 LSTM보다 우수하다는 뜻은 아니다. 이 논문 역시 NTM의 세부 주소 지정 알고리즘보다는 큰 구조를 소개하는 데 그친다.
| 구조 | 해결하려는 문제 | 작동 방식 | 중요한 조건·한계 |
|---|---|---|---|
| 기본 RNN | 순서와 과거 문맥의 활용 | 이전 은닉 상태를 다음 계산에 전달 | 긴 시간 간격의 학습 신호가 약해질 수 있음 |
| LSTM | 장기 의존성의 학습 | 셀 상태와 게이트로 기억의 보존·기록·출력을 분리 | 기억 길이와 안정성이 무조건 보장되지는 않음 |
| BRNN / BiLSTM | 한 방향만 읽을 때 놓치는 문맥 | 양방향 상태를 출력에서 결합 | 필요한 미래 입력이 확보되어야 함 |
| NTM | 고정 크기 상태만으로 다루기 어려운 기억 조작 | 외부 메모리를 학습된 읽기·쓰기로 접근 | 알고리즘 과제의 결과를 일반 능력으로 확대하면 안 됨 |
6. 무엇을 가능하게 했는가: 번역과 이미지 설명
RNN의 활용은 입력과 출력의 길이를 조합하는 방식으로 이해할 수 있다. 문서 분류는 여러 입력에서 하나의 결론을 만들고, 이미지 캡셔닝은 하나의 이미지에서 단어열을 만든다. 번역은 길이가 서로 다른 두 시퀀스를 연결한다.
대표 사례인 sequence-to-sequence 모델은 인코더 LSTM이 원문을 읽어 상태로 압축하고, 디코더 LSTM이 그 상태를 받아 번역문을 한 단어씩 생성한다. 학습할 때는 정답 번역의 앞부분을 디코더에 주고 다음 단어의 확률을 높인다. 생성할 때는 모델이 선택한 단어를 다음 입력으로 넘기고, 여러 후보를 유지하는 빔 탐색으로 문장을 찾다가 종료 토큰에서 마친다.
서베이가 소개하는 Sutskever 등의 연구는 입력 문장을 역순으로 읽는 방법도 사용했다. 초기 출력 단어와 관련 입력 사이의 거리를 줄여 최적화를 쉽게 하려는 접근이다. 이 방법은 BRNN처럼 두 방향을 모두 읽는 것이 아니라 단방향 인코더에 넣는 순서만 뒤집는 것이다.
아래는 서베이 §5.3의 대표 수치를 인용된 seq2seq 원 논문의 Tables 1–2와 대조해 정리한 것이다. 모두 WMT’14 영어→프랑스어 테스트셋(ntst14)에서 tokenized 텍스트에 대소문자를 구분해 계산한 BLEU이며, 원 논문의 평가 방식인 multi-bleu.pl 기준이다. BLEU는 높을수록 좋다.
| 방법 | 설정 | BLEU |
|---|---|---|
| 구문 기반 통계 번역 기준선 | 같은 테스트셋의 SMT 기준선 | 33.30 |
| 단일 LSTM | 입력 역순, beam 12 | 30.59 |
| LSTM 5개 앙상블 | 입력 역순, beam 12, 직접 번역 | 34.81 |
| SMT 후보를 LSTM으로 재정렬 | 후보 1,000개, 역순 LSTM 5개 앙상블 결합 | 36.5 |
| 당시 최상위 WMT’14 시스템 | seq2seq 논문과 같은 평가 방식으로 측정 | 37.0 |
34.81은 단일 LSTM의 점수가 아니라 5개 모델의 앙상블 결과다. 36.5 역시 모델 혼자 처음부터 생성한 번역의 점수가 아니라, 다른 번역 시스템이 만든 후보를 재정렬한 결과다. 따라서 이 사례의 의미는 “모든 기존 번역 시스템을 이겼다”가 아니라, 대규모 직접 신경망 번역이 구문 기반 기준선을 넘어설 수 있음을 보였다는 데 있다. 단일 역순 LSTM의 30.59는 그 기준선보다 낮다.
이미지 캡셔닝에서는 입력을 읽는 쪽을 CNN으로 바꾸고, 이미지 특징을 조건으로 RNN이나 LSTM이 문장을 생성한다. 서베이가 연결하는 중요한 공통점은 입력의 종류가 바뀌어도, 표현을 만들고 조건부 시퀀스를 생성하는 틀을 재사용할 수 있다는 것이다. 이 글의 결과는 모두 해당 연구들이 보고한 값이며, 모델을 직접 학습해 재현한 결과는 아니다.
7. 비판적으로 읽어야 할 지점
이 논문의 제목에서 “Critical Review”가 중요한 이유는 모델의 구조뿐 아니라 평가의 한계까지 다루기 때문이다. 번역과 캡셔닝은 정답 문장이 하나가 아니다. BLEU는 참조 문장과의 n-gram 일치를 활용하므로 많은 문장에 대한 집계에서는 유용해도, 개별 문장의 의미와 품질을 완벽히 판단하지는 못한다. METEOR는 어간과 동의어 등을 활용하지만, 비교하려면 그 처리 방식과 참조 문장 집합까지 맞춰야 한다.
읽고 남길 핵심은 세 가지다.
- 표현력과 학습 가능성을 구분해야 한다. 긴 과거를 표현할 상태가 있어도, 필요한 기억을 얻으려면 학습 신호가 전달되어야 한다.
- 기억의 구조와 문맥의 방향은 별개의 선택이다. LSTM·BRNN·외부 메모리는 서로 다른 문제를 다루며, 활용 조건도 다르다.
- 구조의 성과는 평가 조건과 함께 봐야 한다. 단일 모델과 앙상블, 직접 생성과 후보 재정렬을 한 종류의 결과로 섞으면 발전의 원인을 잘못 읽게 된다.
현재 관점에서 이 서베이는 최신 모델을 고르는 안내서보다 시퀀스 학습의 기초를 이해하는 역사적 설명서에 가깝다. 특히 LSTM과 BRNN을 중심으로 전개되므로 GRU의 상세 비교나 이후 Transformer의 발전을 기대할 자료는 아니다. 그 대신 “과거를 상태에 담는다 → 학습 신호가 멀리 가지 못한다 → 기억 경로와 문맥 활용 구조를 바꾼다”는 흐름을 이해하는 데 강점이 있다.
참고 자료
- Lipton et al., A Critical Review of Recurrent Neural Networks for Sequence Learning, 2015
- Sutskever et al., Sequence to Sequence Learning with Neural Networks, 2014: 번역 결과의 모델 구성과 평가 조건 확인.
- Graves et al., Neural Turing Machines, 2014: 외부 메모리의 세부 구조를 이어서 읽을 자료.
답글 남기기