논문: Tartan IMU: A Light Foundation Model for Inertial Positioning in Robotics
저자: Shibo Zhao, Sifan Zhou, Raphael Blanchard, Yuheng Qiu, Wenshan Wang, Sebastian Scherer · Carnegie Mellon University
발표: CVPR 2025, pp. 22520–22529
논문 · 프로젝트 · 공식 코드
1. 왜 IMU에도 공통 모델이 필요한가
관성 측정 장치(IMU)는 가속도와 각속도를 측정한다. 카메라와 달리 어둠이나 영상의 질감 부족에 직접 영향을 받지 않지만, 센서 오차를 적분하면 위치 오차가 빠르게 누적된다. 학습 기반 관성 오도메트리는 움직임의 패턴을 배워 이를 줄이려 한다. 문제는 사람의 보행으로 학습한 모델이 드론이나 자동차의 움직임까지 잘 설명하지는 못한다는 점이다.
Tartan IMU는 로봇마다 별도의 모델을 처음부터 만드는 대신, 여러 플랫폼의 IMU 데이터로 공통 표현을 학습한 뒤 필요한 부분만 적응시키자는 연구다. 여기서 파운데이션 모델은 언어나 영상을 다루는 거대 모델이 아니라, 서로 다른 로봇의 관성 위치 추정에 재사용할 수 있는 사전학습 모델을 뜻한다.
- 공유 학습: 차량·사족보행 로봇·드론·사람의 데이터를 같은 백본으로 처리하되, 속도를 예측하는 출력 헤드는 플랫폼별로 나눈다.
- 새 환경 적응: 기본 모델의 가중치는 고정하고 LoRA 어댑터만 조정해 작은 데이터로 새 움직임에 적응한다.
- 운용 중 적응: SLAM이 제공하는 상대 자세를 교사 신호로 쓰고, 다양한 동작을 고르게 담은 버퍼로 온라인 학습을 수행한다.
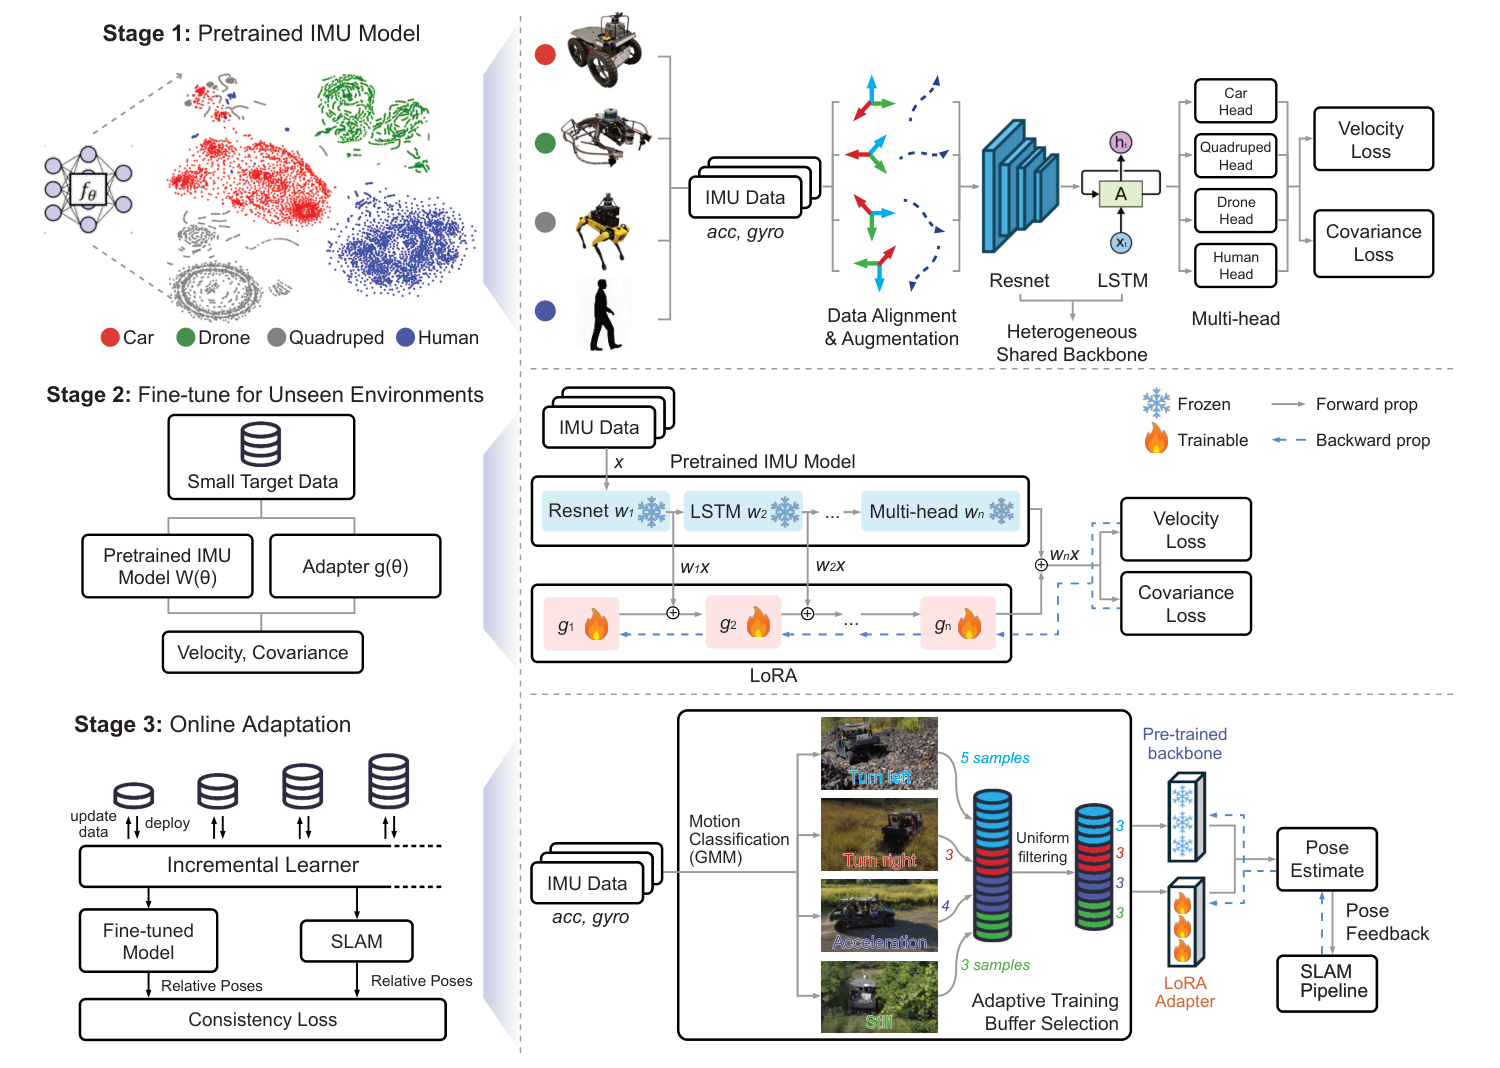
그림 1. Tartan IMU의 전체 흐름. 위에서부터 사전학습, 새 환경에 대한 미세조정, 운용 중 적응이다. 마지막 단계에는 SLAM의 상대 자세 피드백이 들어간다. 출처: Zhao et al., CVPR 2025, Figure 2.
2. 공통 특징은 함께 배우고, 움직임의 차이는 헤드로 분리한다
입력은 3축 가속도와 3축 각속도다. 센서마다 좌표축과 주파수가 다르므로, 몸체 좌표계를 X축 전방·Y축 왼쪽·Z축 위쪽으로 맞추고 데이터를 200 Hz로 보간한다. 학습에서는 회전 변환, 잡음, 바이어스 증강으로 센서와 장착 조건의 차이에 대응한다.
모델은 ResNet 계열 인코더 → LSTM → 플랫폼별 출력 헤드로 구성된다. ResNet은 짧은 구간의 IMU 특징을 뽑고, LSTM은 시간에 따라 이어지는 움직임을 반영한다. 학습 입력은 1초 길이의 창 10개이며, 창 하나에는 200개의 6축 측정값이 들어간다.
공유 백본을 쓰는 이유는 로봇 간에 재사용할 수 있는 관성 특징을 얻기 위해서다. 반면 출력까지 하나로 강제하면 지면 위 차량과 자유롭게 비행하는 드론의 서로 다른 움직임이 같은 예측기를 놓고 경쟁할 수 있다. 따라서 마지막에는 플랫폼별 헤드가 몸체 좌표계의 속도와 그 불확실성을 예측한다. 부록의 차량·사족보행 비교에서도 단일 헤드보다 분리된 헤드의 궤적이 더 정확했다.
속도만 맞히는 것이 아니라 예측의 신뢰도를 함께 학습한다는 점도 중요하다. 논문 식 (3)의 가우시안 음의 로그우도 손실은 다음과 같다.
\mathcal{L}_{\mathrm{NLL}}=\frac{1}{2}(v-\hat v)^T\Sigma^{-1}(v-\hat v)+\frac{1}{2}\ln|\Sigma|여기서 v는 정답 속도, v̂는 예측 속도, Σ는 예측 오차의 공분산이다. 첫 항은 확신에 비해 큰 오차를 벌하고, 두 번째 항은 불확실성을 무조건 크게 만드는 것을 막는다. 모델은 대각 공분산의 로그값을 출력하며, 학습은 먼저 MSE로 수렴시킨 뒤 NLL로 전환한다.
다만 전처리까지 아무 정보 없이 해결하는 모델은 아니다. 본문 식 (1)은 가속도·자이로 바이어스를 안다고 가정하고, 자세 회전을 사용해 중력을 제거한다. 새로운 장치에 적용할 때는 모델뿐 아니라 센서 좌표계·바이어스·자세 처리 조건도 함께 맞춰야 한다.
3. LoRA와 온라인 버퍼로 새 움직임에 적응한다
LoRA: 기존 가중치는 두고 작은 보정만 학습한다
새 환경마다 전체 모델을 다시 학습하면 계산량이 커지고 이전 환경의 지식을 잃을 수 있다. Tartan IMU는 사전학습 가중치 W₀를 고정한 채, 저랭크 행렬 A와 B가 만드는 보정만 학습한다. 논문 식 (4)는 다음과 같다.
h=W_0x+BAx
x는 입력 특징, h는 출력 특징이다. A와 B는 큰 가중치 변화량을 낮은 차원으로 표현한다. A는 무작위로, B는 0으로 초기화하므로 처음에는 원래 모델과 같은 출력을 내며 적응을 시작한다. 논문은 여기에 LoRA의 스케일 계수도 적용한다.
SubT에서 TartanDrive로 적응한 실험에서는 전체 미세조정과 LoRA 모두 새 환경을 학습했지만, 원래 SubT로 돌아왔을 때 LoRA 쪽이 기존 성능을 더 잘 유지했다. 이는 해당 실험에서의 망각 완화 결과이지, 모든 환경에서 망각이 없다는 보장은 아니다.
파라미터 수에는 원문 내부 차이가 있다. 초록과 공식 프로젝트는 학습 파라미터 1.1M을 제시하지만, 본문 3.3절은 어댑터를 5M으로 기술한다. 따라서 경량 적응이라는 방향과 별개로 정확한 크기는 사용할 구현·설정에서 확인할 필요가 있다.
온라인 적응: 들어오는 데이터를 전부 저장하지 않는다
운용 중에는 새 환경의 데이터를 미리 모아둘 수 없다. 논문은 SLAM이 추정한 상대 자세를 교사로 삼아 IMU 모델을 갱신하는 방식을 사용한다. 즉, IMU 입력으로 추론하는 것과 IMU만으로 온라인 학습 신호까지 얻는 것은 다르다. 이 온라인 적응에는 외부 SLAM 추정이 필요하다.
여기서 단순히 최신 데이터를 쌓으면 직진처럼 자주 나타나는 움직임이 학습 버퍼를 채우기 쉽다. Tartan IMU는 가우시안 혼합 모델(GMM)로 동작 패턴을 묶고, 각 묶음에서 균형 있게 샘플을 선택한다. 차량 실험에서는 정지·전진·좌회전·우회전이 대표적인 묶음이다. 중복된 직진 구간을 줄이고 드문 회전 구간도 유지해, 제한된 연산으로 더 다양한 움직임을 학습하려는 설계다.
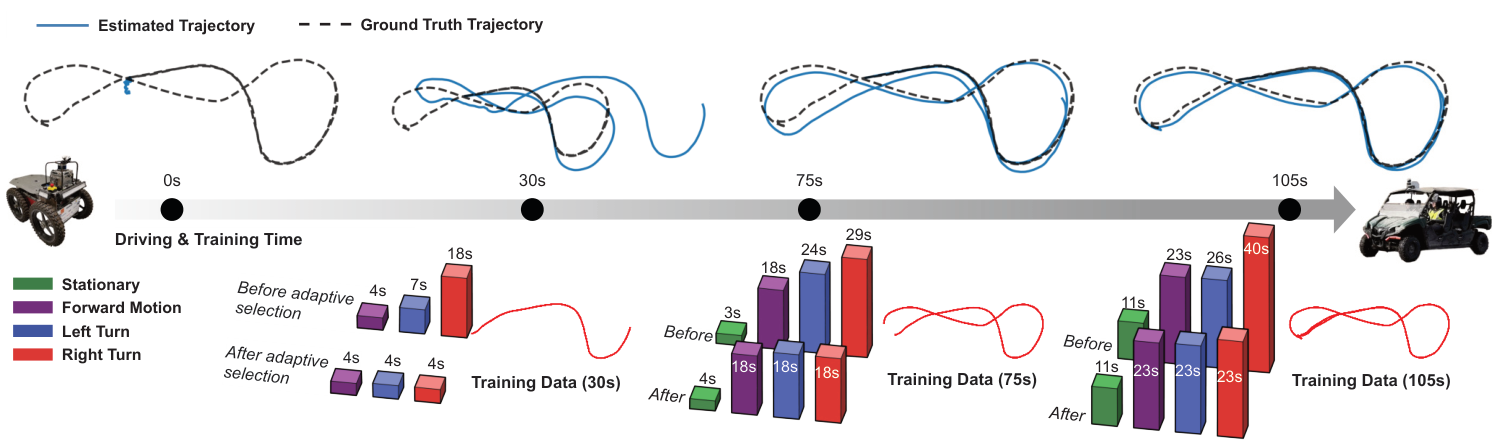
그림 2. SubT UGV 모델을 TartanDrive 차량에 온라인 적응시키는 예시. 아래 막대는 동작별 데이터가 균등하게 선택되는 과정을 보여준다. 출처: 같은 논문 Figure 6.
4. 실험: 어느 조건에서 얼마나 좋아졌나
부록에 정리된 학습 데이터는 SubT-MRS·IDOL·RNIN-VIO·BlackBird·UZH-FPV의 102.5시간이다. 아래 결과는 논문 저자 보고이며, 이 글에서 모델 학습이나 벤치마크를 재현한 것은 아니다.
공통 데이터로 학습한 모델 간 비교
본문 Table 1에서는 AI-IMU·RNIN-VIO·TLIO·IMO와 Tartan IMU를 같은 대규모 데이터로 학습시키고 동일한 미관측 테스트 데이터로 평가한다. 기존 방법의 배포 체크포인트를 그대로 가져온 비교로 읽으면 안 된다. Tartan IMU는 이 평가에서 추가 미세조정 없이 네 플랫폼 계열을 처리한다.
ATE는 전체 궤적의 절대 오차, T-RTE는 시간 구간 기준 상대 궤적 오차다. 두 지표 모두 낮을수록 좋다. 다음은 Table 1에서 플랫폼별 가장 낮은 기존 방법의 값과 Tartan IMU의 값을 옮긴 것이다.
| 플랫폼 | 비교 방법 | 기존 ATE | Tartan ATE | 기존 T-RTE | Tartan T-RTE |
|---|---|---|---|---|---|
| 차량 | AI-IMU | 7.68 | 6.17 | 3.33 | 2.52 |
| 사람 | TLIO | 6.96 | 4.32 | 4.82 | 1.95 |
| 사족보행 | RNIN-VIO | 3.10 | 1.46 | 1.58 | 0.79 |
| 드론 | IMO | 3.72 | 3.32 | 1.34 | 1.04 |
표의 절대값에서는 네 플랫폼 모두 개선된다. 다만 논문의 평균 ATE 35.5% 개선(초록 약 36%)·T-RTE 41.0% 개선은 표에 인쇄된 최선의 기존 값으로 계산한 결과와 일치하지 않는다. 각 행에서 (기존−제안)/기존을 계산해 단순 평균하면 각각 약 30.3%·39.1% 수준이다. 따라서 대표 개선율은 저자 보고로 구분하고, 실제 비교에는 위 절대값을 보는 편이 안전하다.
데이터를 섞는 것 자체의 효과
같은 Tartan IMU 구조라도 한 플랫폼의 데이터로만 학습하는 것보다 여러 플랫폼을 함께 학습할 때 ATE가 낮았다.
| 평가 플랫폼 | 단일 플랫폼 학습 ATE | 전체 플랫폼 학습 ATE |
|---|---|---|
| 차량 | 7.51 | 6.17 |
| 사람 | 6.64 | 4.32 |
| 사족보행 | 3.64 | 1.46 |
| 드론 | 3.84 | 3.32 |
출처: 본문 Table 2. 아키텍처를 바꾸는 비교가 아니라 학습 데이터 다양성의 효과를 보는 비교다.
사족보행의 3.64 → 1.46은 통상적인 기준으로 약 59.9% 오차 감소다. 본문의 “150% 감소” 표현은 이를 그대로 의미하지 않으므로, 절대값과 일반적인 감소율로 해석했다.
새 환경 적응 결과
- 오프라인 적응: SubT에서 TartanDrive로 미세조정할 때, 저자들은 RNIN-VIO 대비 33% 적은 반복으로 적응했다고 보고한다. Figure 5는 60 epoch 시점의 궤적 차이를 보여준다.
- 온라인 적응: 최대 속도 5 m/s의 UGV에서 최대 15 m/s의 오프로드 차량으로 조건이 바뀐 예시에서, Figure 6은 105초 동안의 적응을 보여준다. 이는 해당 주행 사례의 결과이지 모든 새 환경에 대한 고정 적응 시간은 아니다.
- 처리 속도: 초록은 200 FPS를 보고한다. 그러나 이를 재현할 장치·추론과 갱신의 시간 분해는 확인한 자료에서 충분히 제시되지 않는다. 부록의 NVIDIA 4090·약 30시간은 사전학습 조건이므로, 이를 200 FPS의 측정 조건으로 연결하지 않았다.
5. 의미와 한계
이 연구의 핵심은 단순히 모델을 키우는 데 있지 않다. 공유할 관성 특징은 함께 학습하고, 플랫폼별 차이는 헤드로 분리하며, 배포 이후 변화는 작은 어댑터와 균형 잡힌 버퍼로 흡수한다는 설계가 중심이다. 서로 다른 로봇의 데이터가 경쟁만 하는 것이 아니라 위치 추정에 도움이 될 수 있다는 점을 보여준다.
다만 미지의 모든 로봇에서 바로 동작하는 범용 센서 모델로 보기는 어렵다. 저자도 새로운 플랫폼에는 추가 헤드가 필요할 수 있고, 복잡한 움직임에서는 GMM 기반 버퍼 선택이 어려울 수 있다고 밝힌다. 온라인 적응 또한 SLAM 교사 신호의 품질과 사용 가능성에 의존한다.
재현 시에는 원문의 표기 차이도 확인해야 한다. 플랫폼 수는 본문에서 8개, 부록에서는 10개로 기술되며, 어댑터 크기와 일부 개선율도 일치하지 않는다. 다중 플랫폼 학습의 유효성은 표의 결과로 확인하되, 특정 성능 수치나 비용을 보장으로 받아들이지는 않는 것이 이 논문을 읽는 적절한 출발점이다.
참고 자료
- CVPR 2025 논문 정보
- 보충 자료: 데이터 구성·구현 조건·추가 ablation
- Tartan IMU 공식 프로젝트
- 공식 구현: 현재 공개 안내는 ResNet-LSTM 기반 모델을 제공한다. 최신 배포·챌린지 설명과 이 글의 CVPR 2025 실험 조건은 구분해야 한다.
답글 남기기